TF-IDF Hesaplama Aracı Nedir?
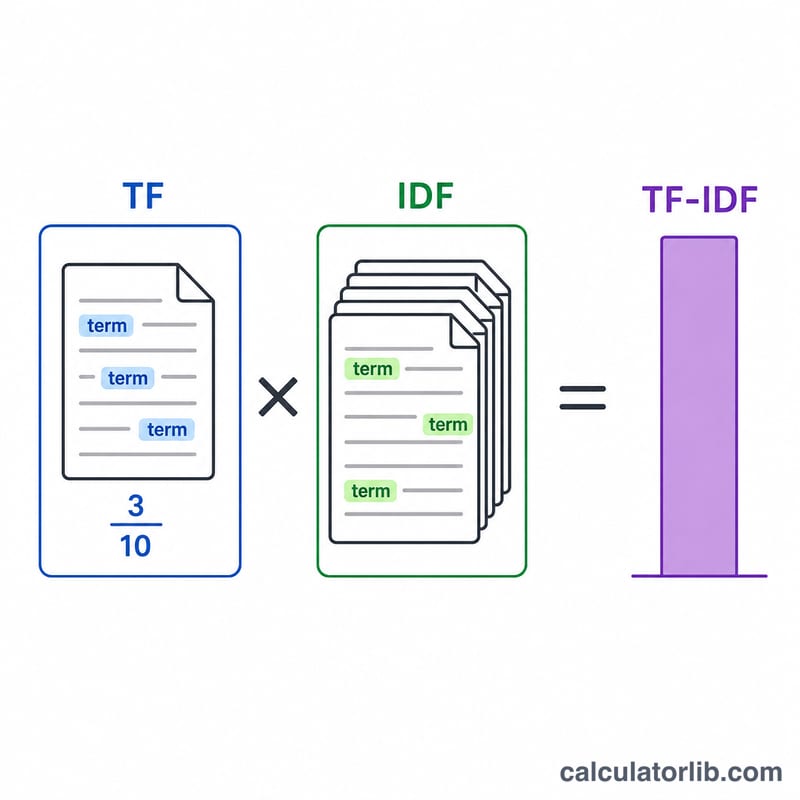
TF-IDF (İngilizce "Term Frequency–Inverse Document Frequency", yani Terim Sıklığı–Ters Belge Sıklığı), bilgi erişimi, arama motorları ve metin madenciliğinde kullanılan sayısal bir istatistiktir. Bir kelimenin, daha büyük bir belge koleksiyonu (korpus olarak adlandırılır) içindeki tek bir belge için ne kadar önemli olduğunu ölçer. Bu araçla bir belgeyi, hedeflediğiniz bir terimi, korpusunuzdaki toplam belge sayısını ve bu belgelerden kaçının ilgili terimi içerdiğini girebilirsiniz. Araç ardından terim sıklığını (TF), ters belge sıklığını (IDF) ve bunların birleşiminden oluşan TF-IDF skorunu hesaplar.
Nasıl Kullanılır?
- Belge: Analiz etmek istediğiniz belgenin metnini yapıştırın.
- Terim: Skorunu öğrenmek istediğiniz tek kelimeyi veya ifadeyi girin.
- Korpus boyutu: Koleksiyonunuzdaki toplam belge sayısı (\(N\)).
- Terimi içeren belgeler: Terimin en az bir kez geçtiği belge sayısı.
Araç, terimin belgenizde kaç kez geçtiğini sayar, bunu toplam kelime sayısına böler ve sonucu terimin korpus genelindeki nadirliğiyle birleştirir.
Formülün Açıklaması
Standart TF-IDF formülü şöyledir:
$$\begin{gathered} \text{TF-IDF} = \text{TF} \times \text{IDF} \\[1.5em] \text{where}\quad \left\{ \begin{aligned} \text{TF} &= \dfrac{\text{count of }\text{Term}\text{ in }\text{Document}}{\text{total words in }\text{Document}} \\[0.6em] \text{IDF} &= \ln\!\left(1 + \dfrac{\text{Corpus Size}}{\text{Docs with Term} + 1}\right) \end{aligned} \right. \end{gathered}$$- TF = (terimin belgede geçme sayısı) ÷ (belgedeki toplam kelime sayısı)
- IDF = \(\log(N \div \text{terimi içeren belge sayısı})\)
- TF-IDF = \(\text{TF} \times \text{IDF}\)
Yüksek bir TF-IDF skoru, terimin belgenizde sık ama korpus genelinde nadir geçtiği anlamına gelir; bu da o kelimenin ilgili belge için ayırt edici ve anlamlı olduğuna dair güçlü bir işarettir.
Örnek Hesaplama
Diyelim ki belgenizde 100 kelime var ve "pazarlama" terimi 5 kez geçiyor. Korpusunuz 1.000 belge içeriyor ve bunların 100'ünde "pazarlama" kelimesi geçiyor.
- $$\text{TF} = 5 \div 100 = 0{,}05$$
- $$\text{IDF} = \log(1000 \div 100) = \log(10) = 1 \text{ (10 tabanında)}$$
- $$\text{TF-IDF} = 0{,}05 \times 1 = 0{,}05$$
Eğer "pazarlama" yalnızca 10 belgede geçseydi, IDF değeri \(\log(100) = 2\)'ye yükselir ve skoru 0,10'a çıkararak iki katına çıkarırdı; yani nadir ve daha ayırt edici terimler ödüllendirilir.
Temel Terimler ve Değişkenler
| Terim | Sembol | Tanım |
|---|---|---|
| Terim | \(t\) | Puanlandırılan sözcük, kök veya ifade. Bütün korpus boyunca bir terim olarak neyin sayılması gerektiği tutarlı bir şekilde tanımlanmalıdır. |
| Belge | \(d\) | Puanlandırılan bir metin birimi — bir makale, bir sayfa, bir ürün açıklaması, bir destek talebini. TF her zaman tek bir belgeye göredir. |
| Derlem | \(D\) | Nadirliğin yargılandığı belgelerin tam koleksiyonu. IDF, belgenin değil, derlemin bir özelliğidir. |
| Derlem boyutu | \(N\) | Puanlandırılan belge dahil, derlemdeki belge sayısı. |
| Belge sıklığı | \(df\) | Terimi en az bir kez içeren belge sayısı. Belgelerin sayısı, asla oluşumların sayısı değil, bu nedenle \(0 \le df \le N\). |
| Ham terim sayısı | \(tf\) | Terimin tek bir belgede kaç kez oluştuğu — normalize edilmemiş sayı. |
| Terim sıklığı | TF | Normalize edilmiş sayı, \(tf\)'nin belgenin toplam sözcük sayısına bölünmesi. Belgenin uzunluğunun etkisini ortadan kaldıran 0 ile 1 arasında bir oran. |
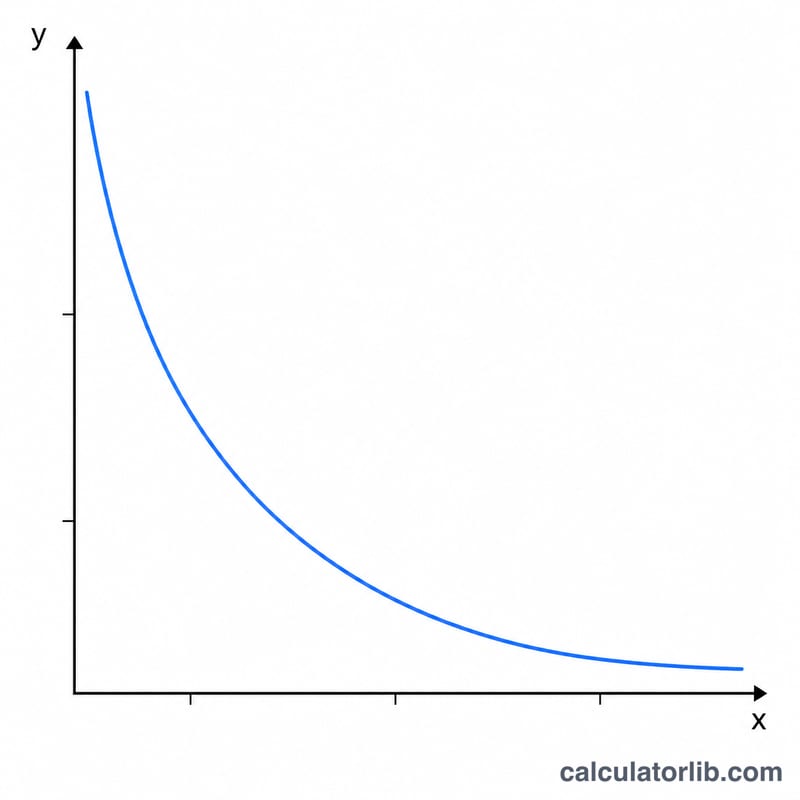
| Ters belge sıklığı | IDF | Küresel nadirliğin logaritmik ölçüsü. Terim az sayıda belgede göründüğünde büyük, birçok belgede göründüğünde küçük. |
| TF-IDF | — | \(\text{TF} \times \text{IDF}\) çarpımı: bir terim yerel olarak sık ve küresel olarak nadir olduğunda yüksek. |
| Tokenleştirme | — | Ham metni sayılabilir tokenlara bölme — tipik olarak küçük harfe çevirme, noktalama işaretlerini kaldırma ve sayılar, tireler ve kasılmalarla nasıl davranacağına karar verme. Hem TF paydasını hem de ne sayılan bir eşleşmeyi belirler. |
| Durma sözcüğü | — | Çok yaygın bir işlev sözcüğü (the, of, and, is) çok az tematik bilgi taşıyan. Puanlamadan önce sıklıkla kaldırılır, ancak TF-IDF bu tür sözcükleri kendi kendine bastırır çünkü bunların IDF minimum değere yakındır. |
| Düzleştirme | — | \(\ln(1 + N/(df+1))\)'teki \(+1\) terimleri. Paydadaki \(+1\), \(df = 0\) olduğunda (derlemde görülmemiş bir terim) sıfıra bölmeyi engeller; logaritmanın içindeki \(+1\), argümanı 1'in üstünde tutar, böylece sonuç her zaman kesinlikle pozitif ve asla sıfır veya negatif değildir. |
| Logaritma tabanı | \(\ln\), \(\log_{10}\) | IDF'de kullanılan logaritmanın tabanı. Tabanı değiştirmek sadece her IDF'yi bir sabit ile çarpar — \(\ln x = \log_{10}x \times \ln 10 \approx 2.3026\,\log_{10}x\) — bu nedenle terimlerin sıralaması değişmez, ancak mutlak sayılar değişir. Hangi tabanı kullandığınızı her zaman belirtin. |
| Sözlük | \(V\) | Tokenleştirmeden sonra derlem genelinde farklı terimlerin kümesi. Boyutu, TF-IDF vektör uzayının boyutsallığıdır. |
TF-IDF'nin tek bir formül yerine bir formül ailesi olduğunu unutmayın: varyantlar ham sayılı TF, log-normalize edilmiş TF \(1 + \ln(tf)\), artırılmış TF ve düzleştirilmemiş veya olasılıksal IDF'yi içerir. Farklı varyantlardan elde edilen puanlar hiçbir zaman doğrudan karşılaştırılmamalıdır.
Sıkça Sorulan Sorular
IDF'de neden logaritma kullanılır? Logaritma, son derece nadir terimlerin etkisini yumuşatır; böylece tek bir geçiş skoru domine etmez ve sonuçlar dengeli kalır.
Hangi logaritma tabanını kullanmalıyım? Hem 10 tabanı hem de doğal logaritma (\(\ln\)) yaygındır. Taban yalnızca sonuçları orantılı biçimde ölçeklendirir; bu nedenle aynı korpus içindeki karşılaştırmalar geçerliliğini korur.
Sıfır skoru ne anlama gelir? Bir terim her belgede geçiyorsa (\(N = \text{terimi içeren belge sayısı}\)), IDF \(\log(1) = 0\) olur ve TF-IDF skoru sıfıra iner; yani o kelime ayırt edici hiçbir değer taşımaz.