什麼是 TF-IDF 計算機?
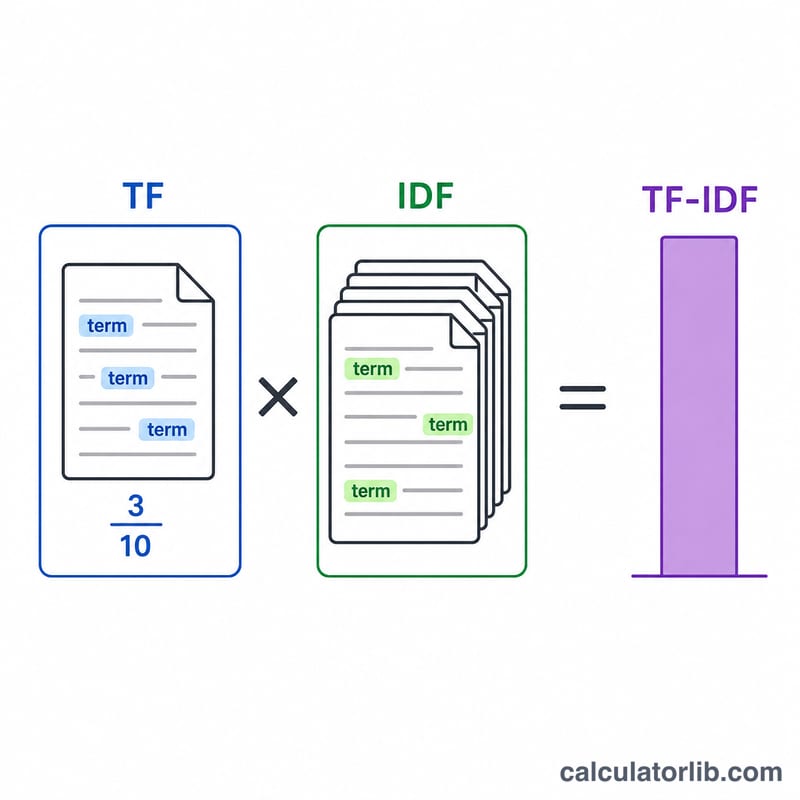
TF-IDF(詞頻–逆文件頻率,Term Frequency–Inverse Document Frequency)是資訊檢索、搜尋引擎與文字探勘中常用的一項數值統計,用來衡量某個詞對「單一文件」相對於「整批文件集合」(稱為語料庫,corpus)的重要程度。透過這個計算機,你可以輸入一份文件、一個目標關鍵詞、語料庫中的文件總數,以及其中含有該詞的文件數量,系統就會算出詞頻(TF)、逆文件頻率(IDF),以及兩者相乘後的 TF-IDF 權重分數。
使用方式
- 文件:貼上你想分析的文件內容。
- 關鍵詞:輸入你想評分的單一字詞或片語。
- 語料庫總數:整批文件集合中的文件總數(\(N\))。
- 含該詞的文件數:至少出現過該詞一次的文件有幾份。
計算機會統計該詞在你的文件中出現的次數,除以文件的總字數,再結合該詞在整個語料庫中的稀有程度,得出最終分數。
公式說明
標準的 TF-IDF 公式如下:
- TF=(該詞在文件中出現的次數)÷(文件的總字數)
- IDF=log(\(N\) ÷ 含該詞的文件數)
- TF-IDF=TF × IDF
$$\begin{gathered} \text{TF-IDF} = \text{TF} \times \text{IDF} \\[1.5em] \text{where}\quad \left\{ \begin{aligned} \text{TF} &= \dfrac{\text{count of }\text{Term}\text{ in }\text{Document}}{\text{total words in }\text{Document}} \\[0.6em] \text{IDF} &= \ln\!\left(1 + \dfrac{\text{Corpus Size}}{\text{Docs with Term} + 1}\right) \end{aligned} \right. \end{gathered}$$
TF-IDF 分數越高,代表這個詞在你的文件中頻繁出現,但在整個語料庫中卻很少見——這是個強烈訊號,說明該詞對這份文件具有獨特性與代表性。
實際範例
假設你的文件共有 100 個字,而「行銷」這個詞出現了 5 次。你的語料庫共有 1,000 份文件,其中有 100 份提到「行銷」。
- TF=\(5 \div 100 = 0.05\)
- IDF=\(\log(1000 \div 100) = \log(10) = 1\)(以 10 為底)
- TF-IDF=\(0.05 \times 1 = 0.05\)
如果「行銷」只出現在 10 份文件中,IDF 就會上升到 \(\log(100) = 2\),分數隨之翻倍至 \(0.10\)——這正是 TF-IDF 給越稀有、越具辨識度的詞更高權重的原因。
主要術語和變數
| 術語 | 符號 | 定義 |
|---|---|---|
| 術語 | \(t\) | 被評分的單字、詞幹或短語。無論什麼算作一個術語,都必須在整個語料庫中定義一致。 |
| 文件 | \(d\) | 被評分的一個文本單位——一篇文章、一個頁面、一個產品描述、一個支持工單。TF 始終相對於單個文件。 |
| 語料庫 | \(D\) | 用來判斷罕見性的完整文件集合。IDF 是語料庫的屬性,而不是文件的屬性。 |
| 語料庫大小 | \(N\) | 語料庫中的文件數量,包括正在評分的文件。 |
| 文件頻率 | \(df\) | 有多少個文件至少包含一次該術語。是文件計數,永遠不是出現次數,所以 \(0 \le df \le N\)。 |
| 原始術語計數 | \(tf\) | 術語在單個文件中出現的次數——未標準化的計數。 |
| 術語頻率 | TF | 標準化計數,即 \(tf\) 除以文件的總字數。0 到 1 之間的比例,消除了文件長度的影響。 |
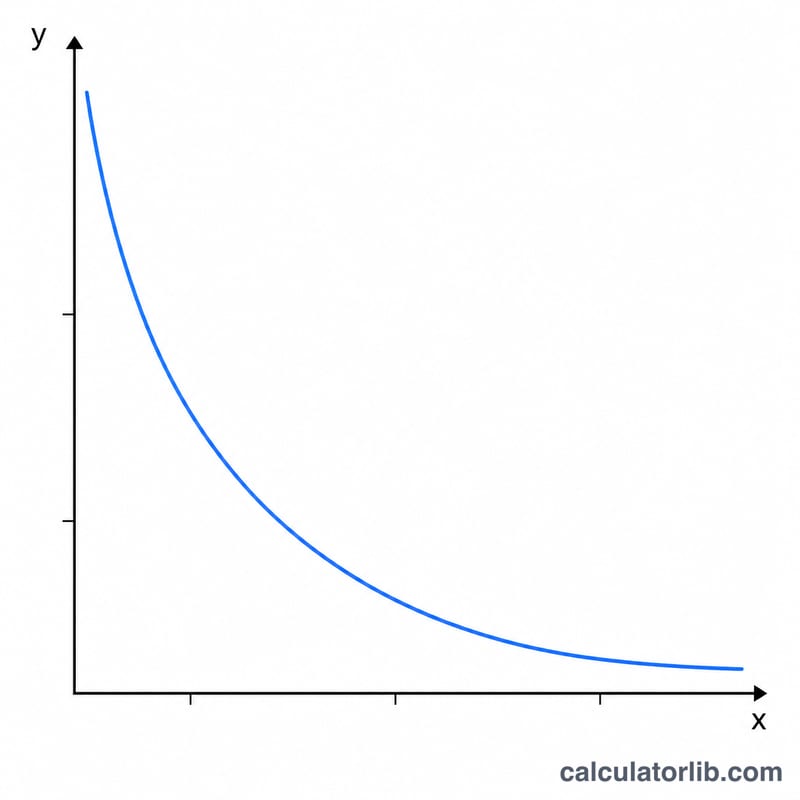
| 逆文件頻率 | IDF | 全局罕見性的對數度量。當術語在少數文件中出現時較大,在許多文件中出現時較小。 |
| TF-IDF | — | 乘積 \(\text{TF} \times \text{IDF}\):當術語在局部頻繁且全局罕見時較高。 |
| 分詞 | — | 將原始文本拆分為可計數的標記——通常包括小寫轉換、移除標點符號,以及決定如何處理數字、連字符和縮寫。它固定了 TF 分母和作為匹配項的內容。 |
| 停用詞 | — | 非常常見的功能詞(the、of、and、is),帶有很少的主題信息。評分前通常被移除,儘管 TF-IDF 因為這些詞的 IDF 接近最小值而自動抑制這些詞。 |
| 平滑 | — | 公式 \(\ln(1 + N/(df+1))\) 中的 \(+1\) 項。分母中的 \(+1\) 防止了當 \(df = 0\) 時的除零錯誤(語料庫中未出現的術語);對數內的 \(+1\) 使參數保持在 1 以上,因此結果始終嚴格為正,永遠不為零或負。 |
| 對數底 | \(\ln\), \(\log_{10}\) | IDF 中使用的對數底。改變底數只會將每個 IDF 乘以一個常數——\(\ln x = \log_{10}x \times \ln 10 \approx 2.3026\,\log_{10}x\)——因此術語的 排名 保持不變,但絕對數字會改變。始終說明你使用的底數。 |
| 詞彙 | \(V\) | 標記化後語料庫中所有不同術語的集合。其大小是 TF-IDF 向量空間的維數。 |
注意 TF-IDF 是一個公式族而不是單個公式:變體包括原始計數 TF、對數標準化 TF \(1 + \ln(tf)\)、擴充 TF 和未平滑或概率 IDF。不同變體的分數不應直接比較。
常見問題
為什麼 IDF 要取對數?取對數能抑制極度稀有詞所造成的過度影響,避免單一次出現就主導整個分數,讓結果更為平衡。
應該用哪一種對數底數?以 10 為底(\(\log\))與自然對數(\(\ln\))都很常見。底數只是把結果做等比例縮放,因此只要在同一個語料庫內比較,結果依然有效。
分數為 0 代表什麼?如果某個詞出現在每一份文件中(\(N\)=含該詞的文件數),IDF 就會變成 \(\log(1) = 0\),使得 TF-IDF 分數歸零——表示這個詞完全沒有辨識價值。