什么是 TF-IDF 计算器?
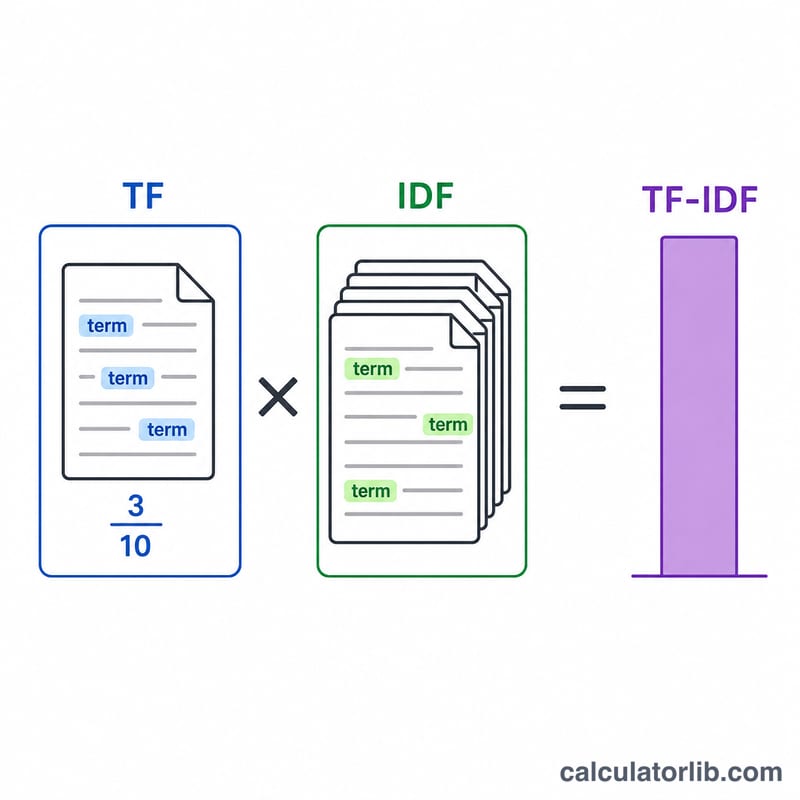
TF-IDF(Term Frequency–Inverse Document Frequency,即词频—逆文档频率)是一种广泛应用于信息检索、搜索引擎和文本挖掘的数值统计方法,用来衡量某个词对一篇文档(相对于整个文档集合,即"语料库")的重要程度。使用这款计算器,你只需输入一篇文档、一个目标词、语料库中的文档总数,以及其中包含该词的文档数量,工具就会自动算出词频(TF)、逆文档频率(IDF)以及二者结合后的 TF-IDF 得分。
如何使用
- 文档:把你想要分析的文档正文粘贴进来。
- 目标词:填入你想要评分的单个词语或短语。
- 语料库规模:整个文档集合中的文档总数(\(N\))。
- 包含该词的文档数:有多少篇文档至少出现过这个词一次。
计算器会统计目标词在文档中出现的次数,再除以文档的总词数,然后结合该词在整个语料库中的稀有程度,得出最终结果。
公式详解
标准的 TF-IDF 计算公式如下:
$$\begin{gathered} \text{TF-IDF} = \text{TF} \times \text{IDF} \\[1.5em] \text{where}\quad \left\{ \begin{aligned} \text{TF} &= \dfrac{\text{count of }\text{Term}\text{ in }\text{Document}}{\text{total words in }\text{Document}} \\[0.6em] \text{IDF} &= \ln\!\left(1 + \dfrac{\text{Corpus Size}}{\text{Docs with Term} + 1}\right) \end{aligned} \right. \end{gathered}$$- TF =(目标词在文档中出现的次数)÷(文档的总词数)
- IDF = \(\log(N \div \text{包含该词的文档数})\)
- TF-IDF = \(\text{TF} \times \text{IDF}\)
TF-IDF 得分越高,说明该词在你的文档中频繁出现、却在整个语料库中很少出现——这强烈表明这个词对该文档具有独特的代表性和实际意义。
实例演算
假设你的文档共有 100 个词,"营销"这个词出现了 5 次;你的语料库中共有 1,000 篇文档,其中有 100 篇提到了"营销"。
- TF = \(5 \div 100 = 0.05\)
- IDF = \(\log(1000 \div 100) = \log(10) = 1\)(以 10 为底)
- TF-IDF = \(0.05 \times 1 = 0.05\)
如果"营销"只出现在 10 篇文档中,IDF 就会上升到 \(\log(100) = 2\),得分也随之翻倍至 \(0.10\)——这正体现了对更稀有、更具区分度词语的"奖励"。
关键术语和变量
| 术语 | 符号 | 定义 |
|---|---|---|
| 术语 | \(t\) | 被评分的词、词根或短语。任何被算作一个术语的内容必须在整个语料库中保持一致的定义。 |
| 文档 | \(d\) | 被评分的文本单位——文章、页面、产品描述、支持工单。TF 总是相对于单个文档的。 |
| 语料库 | \(D\) | 用于判断罕见性的文档的完整集合。IDF 是语料库的属性,而不是文档的属性。 |
| 语料库大小 | \(N\) | 语料库中的文档数,包括被评分的文档。 |
| 文档频率 | \(df\) | 包含该术语至少一次的文档数。文档计数,而不是出现次数计数,因此 \(0 \le df \le N\)。 |
| 原始术语计数 | \(tf\) | 该术语在单个文档内出现的次数——未归一化的计数。 |
| 术语频率 | TF | 归一化的计数,\(tf\) 除以文档的总单词数。0 到 1 之间的比例,消除了文档长度的影响。 |
| 逆文档频率 | IDF | 全局罕见性的对数度量。当术语出现在少数文档中时较大,出现在许多文档中时较小。 |
| TF-IDF | — | 乘积 \(\text{TF} \times \text{IDF}\):当术语在局部频繁且全局罕见时较高。 |
| 分词 | — | 将原始文本分割成可计数的标记——通常包括转换为小写、移除标点符号,以及决定如何处理数字、连字符和缩写。它既确定了 TF 的分母,也确定了什么被算作匹配。 |
| 停用词 | — | 一种非常常见的功能词(the、of、and、is)携带很少的主题信息。通常在评分前被移除,尽管 TF-IDF 由于这些词的 IDF 接近最小值而自行抑制它们。 |
| 平滑 | — | 公式 \(\ln(1 + N/(df+1))\) 中的 \(+1\) 项。分母中的 \(+1\) 防止当 \(df = 0\) 时的除以零(语料库中未见过的术语);对数内的 \(+1\) 保持参数大于 1,因此结果始终严格为正,永不为零或负数。 |
| 对数基数 | \(\ln\), \(\log_{10}\) | IDF 中使用的对数基数。改变基数只是将每个 IDF 乘以常数——\(\ln x = \log_{10}x \times \ln 10 \approx 2.3026\,\log_{10}x\)——所以术语的排名不变,而绝对数字会改变。始终说明使用的基数。 |
| 词汇表 | \(V\) | 分词后语料库中的不同术语集合。其大小是 TF-IDF 向量空间的维度。 |
注意 TF-IDF 是一类公式而不是单一公式:变体包括原始计数 TF、对数归一化 TF \(1 + \ln(tf)\)、增强 TF 以及未平滑或概率性 IDF。不同变体的分数不应直接比较。
常见问题
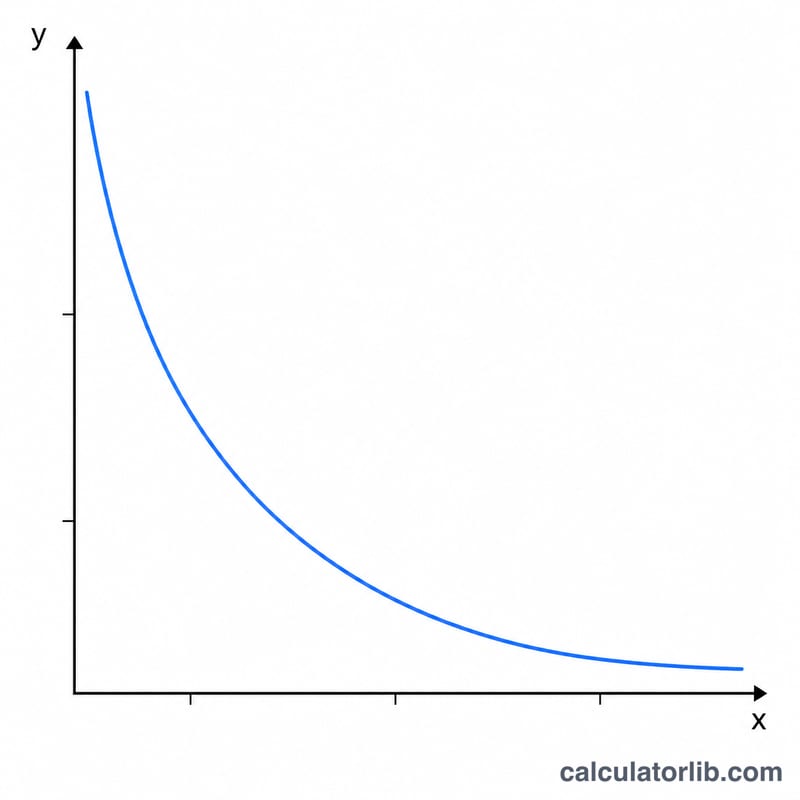
IDF 为什么要用对数?对数可以削弱极其罕见词语的影响,避免某个词仅出现一次就主导整个得分,从而让结果更加均衡合理。
该用哪个对数底数?以 10 为底和自然对数(\(\ln\))都很常见。底数只是对结果做统一的等比缩放,因此在同一语料库内进行比较时,结果依然有效可靠。
得分为零代表什么?如果某个词出现在每一篇文档中(即 \(N\) 等于包含该词的文档数),IDF 就会变成 \(\log(1) = 0\),使整个 TF-IDF 得分归零——说明这个词不具备任何区分价值。