O que é a Calculadora de TF-IDF?
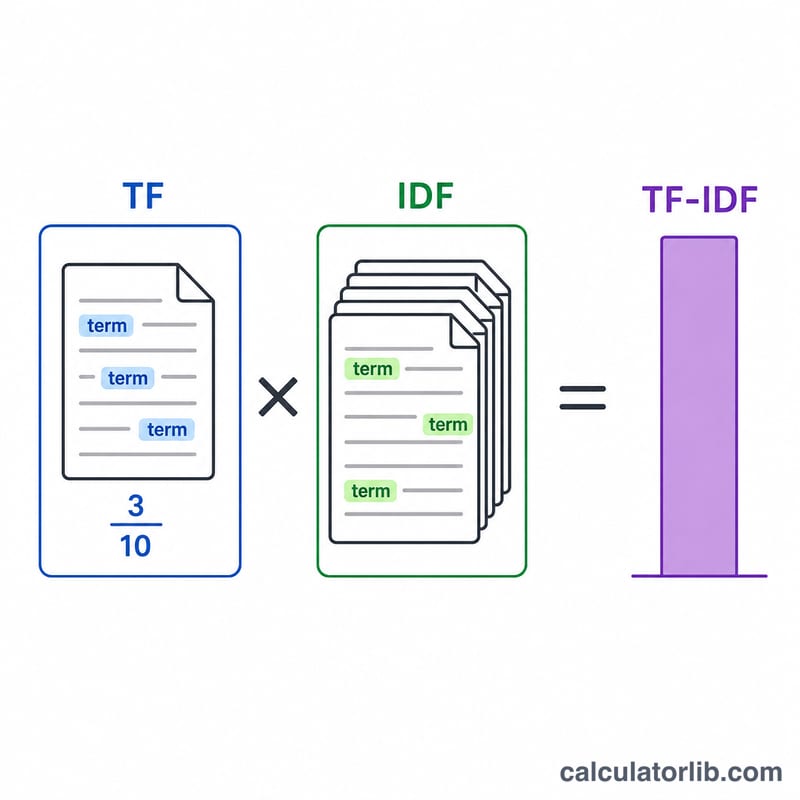
TF-IDF (Term Frequency–Inverse Document Frequency, ou Frequência do Termo–Inverso da Frequência nos Documentos) é uma estatística numérica usada em recuperação de informação, mecanismos de busca e mineração de texto para medir a importância de uma palavra para um documento dentro de uma coleção maior de documentos (chamada de corpus). Esta calculadora permite informar um documento, um termo-alvo, o número total de documentos do seu corpus e quantos desses documentos contêm o termo. Em seguida, ela calcula a frequência do termo (TF), o inverso da frequência nos documentos (IDF) e a pontuação combinada de TF-IDF.
Como usar
- Documento: Cole o texto do documento que você quer analisar.
- Termo: Digite a palavra ou expressão que você quer pontuar.
- Tamanho do corpus: O número total de documentos da sua coleção (\(N\)).
- Documentos com o termo: Quantos documentos contêm o termo pelo menos uma vez.
A calculadora conta quantas vezes o termo aparece no seu documento e divide esse valor pelo total de palavras; depois, combina o resultado com a raridade do termo no corpus.
A fórmula explicada
A fórmula padrão do TF-IDF é:
$$\begin{gathered} \text{TF-IDF} = \text{TF} \times \text{IDF} \\[1.5em] \text{onde}\quad \left\{ \begin{aligned} \text{TF} &= \dfrac{\text{contagem de }\text{Termo}\text{ in }\text{Documento}}{\text{total de palavras em }\text{Documento}} \\[0.6em] \text{IDF} &= \ln\!\left(1 + \dfrac{\text{Tamanho do Corpus}}{\text{Docs com o Termo} + 1}\right) \end{aligned} \right. \end{gathered}$$- TF = (número de vezes que o termo aparece no documento) ÷ (total de palavras do documento)
- IDF = \(\log(N \div \text{número de documentos que contêm o termo})\)
- TF-IDF = \(\text{TF} \times \text{IDF}\)
Uma pontuação alta de TF-IDF significa que o termo aparece com frequência no seu documento, mas raramente no corpus — um forte sinal de que a palavra é distintiva e significativa para aquele documento.
Exemplo prático
Suponha que seu documento tenha 100 palavras e o termo "marketing" apareça 5 vezes. Seu corpus contém 1.000 documentos, e 100 deles mencionam "marketing".
- TF = \(5 \div 100 = 0{,}05\)
- IDF = \(\log(1000 \div 100) = \log(10) = 1\) (base 10)
- TF-IDF = \(0{,}05 \times 1 = 0{,}05\)
Se "marketing" aparecesse em apenas 10 documentos, o IDF subiria para \(\log(100) = 2\), dobrando a pontuação para 0,10 — recompensando termos mais raros e mais distintivos.
Termos e variáveis principais
| Termo | Símbolo | Definição |
|---|---|---|
| Termo | \(t\) | A palavra, radical ou expressão que está sendo pontuada. O que conta como um termo deve ser definido de forma consistente em todo o corpus. |
| Documento | \(d\) | Uma unidade de texto pontuada — um artigo, uma página, uma descrição de produto, um chamado de suporte. O TF é sempre relativo a um único documento. |
| Corpus | \(D\) | A coleção completa de documentos em relação à qual a raridade é avaliada. O IDF é uma propriedade do corpus, não do documento. |
| Tamanho do corpus | \(N\) | O número de documentos do corpus, incluindo o que está sendo pontuado. |
| Frequência nos documentos | \(df\) | Quantos documentos contêm o termo pelo menos uma vez. É uma contagem de documentos, nunca de ocorrências, portanto \(0 \le df \le N\). |
| Contagem bruta do termo | \(tf\) | O número de vezes que o termo ocorre dentro do documento — a contagem não normalizada. |
| Frequência do termo | TF | A contagem normalizada, \(tf\) dividido pelo total de palavras do documento. Uma proporção entre 0 e 1 que elimina o efeito do tamanho do documento. |
| Inverso da frequência nos documentos | IDF | Uma medida logarítmica da raridade global. É grande quando o termo aparece em poucos documentos e pequena quando aparece em muitos. |
| TF-IDF | — | O produto \(\text{TF} \times \text{IDF}\): alto quando um termo é frequente localmente e raro globalmente. |
| Tokenização | — | Divisão do texto bruto em tokens contáveis — normalmente convertendo para minúsculas, removendo pontuação e decidindo como tratar números, hifens e contrações. Ela define tanto o denominador do TF quanto o que conta como correspondência. |
| Stopword | — | Uma palavra funcional muito comum (o, de, e, é) que traz pouca informação temática. Costuma ser removida antes da pontuação, embora o TF-IDF já suprima essas palavras por conta própria, pois o IDF delas fica próximo do mínimo. |
| Suavização | — | Os termos \(+1\) em \(\ln(1 + N/(df+1))\). O \(+1\) no denominador evita divisão por zero quando \(df = 0\) (um termo que não aparece no corpus); o \(+1\) dentro do logaritmo mantém o argumento acima de 1, de modo que o resultado seja sempre estritamente positivo, nunca zero ou negativo. |
| Base do logaritmo | \(\ln\), \(\log_{10}\) | A base do logaritmo usada no IDF. Mudar a base apenas multiplica todos os IDFs por uma constante — \(\ln x = \log_{10}x \times \ln 10 \approx 2{,}3026\,\log_{10}x\) — de modo que o ranking dos termos não muda, mas os valores absolutos sim. Sempre informe qual base você usou. |
| Vocabulário | \(V\) | O conjunto de termos distintos do corpus após a tokenização. Seu tamanho é a dimensionalidade do espaço vetorial do TF-IDF. |
Observe que o TF-IDF é uma família de fórmulas, e não uma única: as variantes incluem TF por contagem bruta, TF normalizado por logaritmo \(1 + \ln(tf)\), TF aumentado e IDF sem suavização ou probabilístico. Pontuações de variantes diferentes nunca devem ser comparadas diretamente.
Perguntas frequentes
Por que usar um logaritmo no IDF? O logaritmo suaviza o efeito de termos extremamente raros, de modo que uma única ocorrência não domine a pontuação, mantendo os resultados equilibrados.
Qual base de logaritmo devo usar? A base 10 e o logaritmo natural (ln) são ambos comuns. A base apenas escala os resultados de maneira uniforme, então as comparações dentro do mesmo corpus continuam válidas.
O que significa uma pontuação igual a zero? Se um termo aparece em todos os documentos (\(N\) = documentos com o termo), o IDF passa a ser \(\log(1) = 0\), fazendo a pontuação de TF-IDF ser zero — a palavra não tem valor distintivo.
Calculadoras relacionadas
- Calculadora de Similaridade de Cosseno — similaridade entre dois vetores.