यह कैलकुलेटर क्या करता है
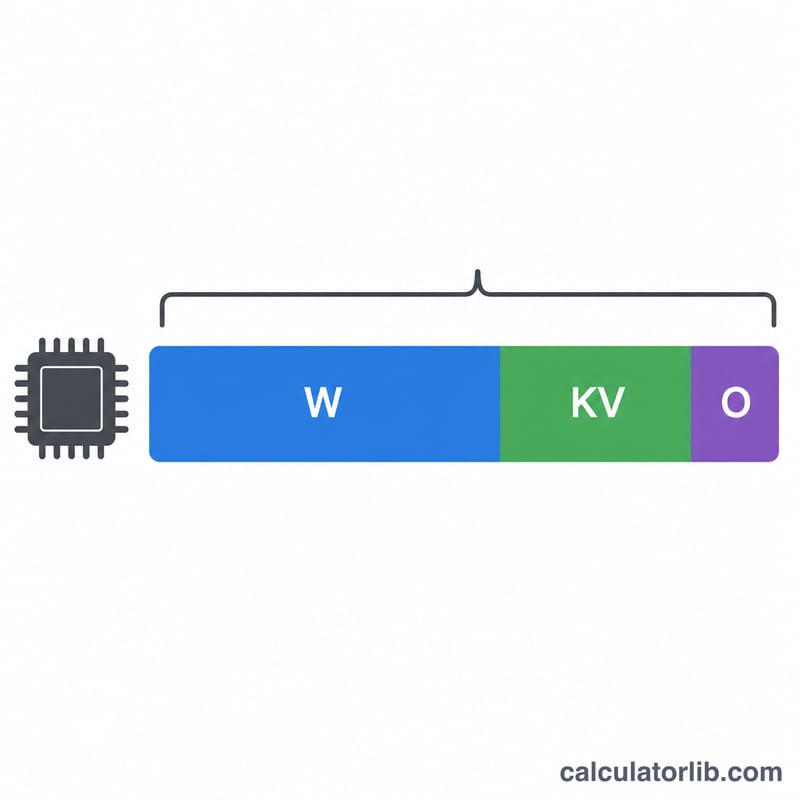
LLM VRAM आवश्यकता कैलकुलेटर यह अनुमान लगाता है कि किसी लार्ज लैंग्वेज मॉडल (LLM) को लोड करके चलाने के लिए आपको कितनी GPU मेमोरी चाहिए। यह मॉडल के पैरामीटर की संख्या (अरबों में) को आपकी चुनी हुई प्रिसिज़न पर हर पैरामीटर द्वारा घेरे जाने वाले बाइट्स से गुणा करता है, और फिर एक ओवरहेड फ़ैक्टर लगाता है जो ऐक्टिवेशन, KV कैश और फ़्रेमवर्क बफ़र्स का हिसाब रखता है।
इसका इस्तेमाल कैसे करें
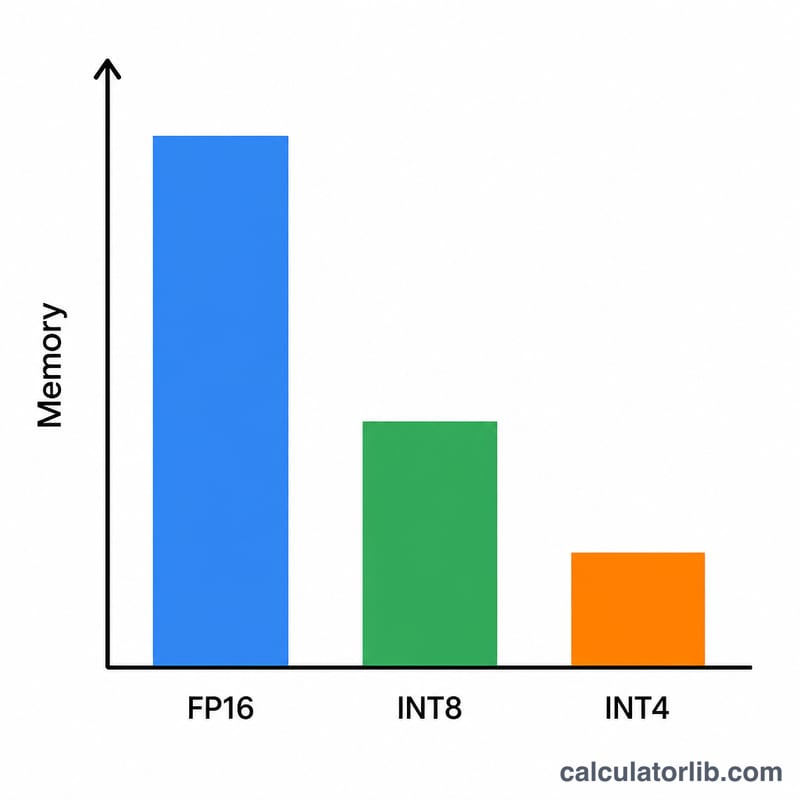
मॉडल का आकार अरबों पैरामीटर में डालें (जैसे 7B मॉडल के लिए 7, और 70B मॉडल के लिए 70)। क्वांटाइज़ेशन चुनें: FP16/BF16 हर वेट के लिए 2 बाइट, INT8 के लिए 1 बाइट, 4-बिट के लिए 0.5 बाइट, और 2-बिट के लिए 0.25 बाइट इस्तेमाल करता है। डिफ़ॉल्ट ओवरहेड 1.2 (यानी 20% बफ़र) इन्फ़रेंस के लिए एक समझदारी भरी शुरुआत है; लंबे कॉन्टेक्स्ट या बैच वाले वर्कलोड के लिए इसे बढ़ा दें।
फ़ॉर्मूला समझें
$$\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times \text{Overhead}$$ पहले दो हिस्से मॉडल वेट्स का कच्चा (raw) आकार गीगाबाइट में बताते हैं। ओवरहेड मल्टीप्लायर वह अतिरिक्त मेमोरी रिज़र्व करता है जिसे PyTorch, CUDA और अटेंशन KV कैश रनटाइम पर इस्तेमाल करते हैं — और जिसे अकेला वेट साइज़ नज़रअंदाज़ कर देता है।
हल किया हुआ उदाहरण
4-बिट प्रिसिज़न पर एक 7B मॉडल: \(7 \times 0.5 = 3.5\) GB वेट्स। 1.2 ओवरहेड फ़ैक्टर के साथ: \(3.5 \times 1.2 = 4.2\) GB। यह 8 GB वाले कंज़्यूमर GPU में आराम से समा जाता है। वही मॉडल FP16 में \(7 \times 2 \times 1.2 = 16.8\) GB मांगता है, जिसके लिए 24 GB कार्ड चाहिए।
अक्सर पूछे जाने वाले सवाल
क्या यह बिल्कुल सटीक है? नहीं — यह एक इन्फ़रेंस अनुमान है। असल इस्तेमाल कॉन्टेक्स्ट लंबाई, बैच साइज़ और सर्विंग फ़्रेमवर्क के साथ बदलता रहता है। इसे प्लानिंग के लिए इस्तेमाल करें, आख़िरी मेगाबाइट तक की गिनती के लिए नहीं।
क्या इसमें ट्रेनिंग की मेमोरी शामिल है? नहीं। ट्रेनिंग में कहीं ज़्यादा मेमोरी (ऑप्टिमाइज़र स्टेट्स, ग्रेडिएंट्स) लगती है, जो अक्सर इन्फ़रेंस के आँकड़े से 4 गुना या उससे भी ज़्यादा होती है।
मुझे कौन सा ओवरहेड इस्तेमाल करना चाहिए? छोटे कॉन्टेक्स्ट वाले इन्फ़रेंस के लिए 1.2 ठीक है; लंबे कॉन्टेक्स्ट या एक साथ कई रिक्वेस्ट के लिए 1.3–1.5 इस्तेमाल करें।