什麼是偽陽性悖論?
偽陽性悖論揭露了醫學檢測與篩檢中一個違反直覺的事實:當所篩檢的疾病本身相當罕見時,即使是準確率極高的檢測,也可能產生大量的假警報。這個計算器透過貝氏定理,幫你算出檢測呈陽性後實際上罹病的機率——也就是陽性預測值(PPV)。這個數字往往遠低於檢測標榜的「準確率」所給人的印象。
使用方法
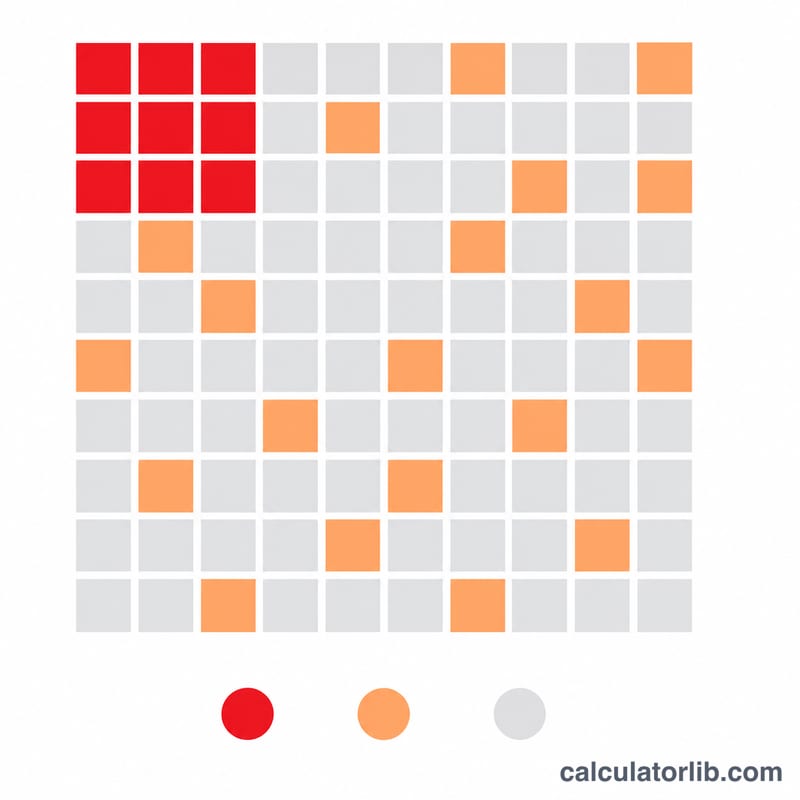
請輸入三個百分比:盛行率(該疾病在受檢族群中有多普遍)、敏感度(患病者被驗出陽性的機率,即真陽性率),以及特異度(健康者被驗出陰性的機率,即真陰性率)。計算器會回傳「陽性結果為真」的機率,以及偽發現率。
公式解析
貝氏定理把「患病者驗出陽性的可能性」與「健康者被誤判為陽性的可能性」結合起來:
$$\text{PPV} = \frac{\text{Sens} \cdot \text{Prev}}{\text{Sens} \cdot \text{Prev} + (1 - \text{Spec})(1 - \text{Prev})} \times 100\%$$
分子是「既患病、又被正確標記為陽性」的人口比例;分母則加入了偽陽性——也就是被誤判為陽性的健康者。當盛行率極低時,這個偽陽性項就會主導整個結果。
實例試算
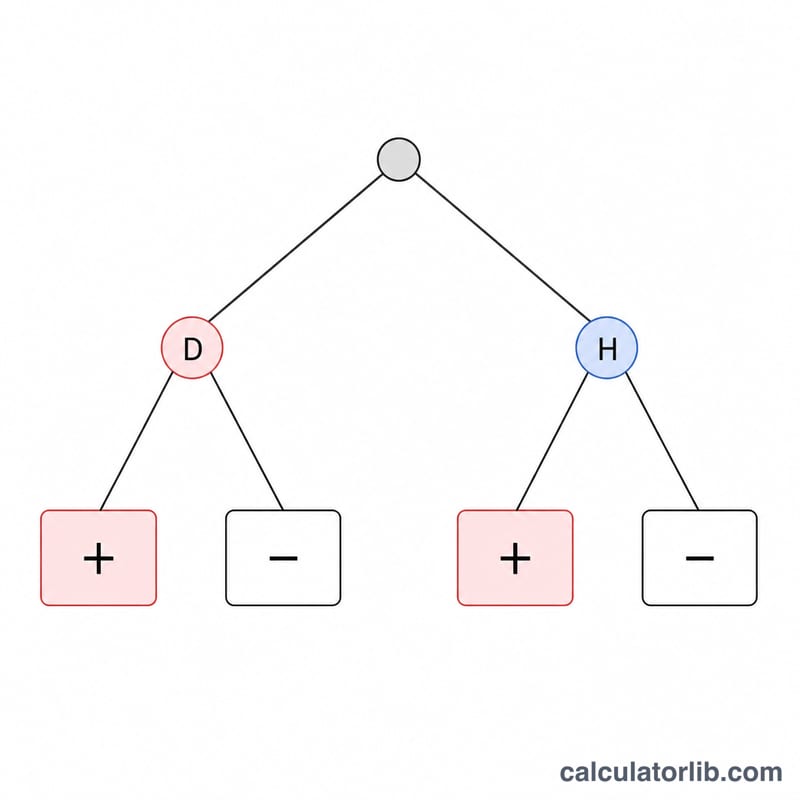
假設某疾病的盛行率為 1%(盛行率 = 0.01),檢測的敏感度為 99%、特異度為 95%。真陽性 \(= 0.99 \times 0.01 = 0.0099\);偽陽性 \(= 0.05 \times 0.99 = 0.0495\)。$$\text{PPV} = \frac{0.0099}{0.0099 + 0.0495} = \frac{0.0099}{0.0594} \approx 16.7\%$$所以即使檢測號稱「99% 準確」,每 6 個陽性結果中也只有約 1 個是真的。
流行率如何影響陽性預測值
下表將敏感度固定為 99%、特異度固定為 95%,僅改變流行率。每一列使用 \(\text{PPV} = \frac{ \text{Sens} \cdot \text{Prev} }{ \text{Sens} \cdot \text{Prev} + (1-\text{Spec})(1-\text{Prev}) }\),而偽發現率(FDR)為 \(1-\text{PPV}\)。
| 流行率 | PPV | 偽發現率 |
|---|---|---|
| 0.1% | 1.94% | 98.06% |
| 1% | 16.67% | 83.33% |
| 5% | 51.03% | 48.97% |
| 10% | 68.75% | 31.25% |
| 25% | 86.84% | 13.16% |
| 50% | 95.19% | 4.81% |
以 1% 那一列進行驗算:\(\text{PPV} = \frac{0.99 \times 0.01}{0.99 \times 0.01 + 0.05 \times 0.99} = \frac{0.0099}{0.0594} \approx 0.1667\),即約 16.7%。即使檢測看似準確,當病症罕見時,約六分之五的陽性結果其實是偽陽性。這就是偽陽性悖論。
1% 流行率下特異度的影響
敏感度維持在 99%,流行率維持在 1%。
| 特異度 | PPV | 偽發現率 |
|---|---|---|
| 95% | 16.67% | 83.33% |
| 99% | 50.00% | 50.00% |
| 99.9% | 90.91% | 9.09% |
在低流行率下,特異度對 PPV 的影響非常大,因為偽陽性來自龐大的健康族群。
關鍵術語:敏感度、特異度、PPV 等
- 流行率:受測族群中真正患有該病症的比例。
- 基礎比率:流行率的另一種說法,或在得知任何檢測結果之前,該病症的事前機率。
- 敏感度(真陽性率):患有該病症的人中,檢測結果為陽性的比例。
- 特異度(真陰性率):未患該病症的人中,檢測結果為陰性的比例。
- 偽陽性率:未患該病症的人中,檢測結果為陽性的比例,等於 \(1-\text{specificity}\)。
- 偽陰性率:患有該病症的人中,檢測結果為陰性的比例,等於 \(1-\text{sensitivity}\)。
- 陽性預測值(PPV):陽性結果中為真陽性的比例。
- 偽發現率(FDR):陽性結果中為偽陽性的比例,等於 \(1-\text{PPV}\)。
- 陰性預測值(NPV):陰性結果中為真陰性的比例。
敏感度和特異度是檢測本身的特性,不取決於流行率。PPV 和 NPV 則取決於流行率,因此同一項檢測在不同族群中會得出不同的預測值。
常見問題
為什麼機率會這麼低?因為罕見疾病代表健康的人遠多於患病的人,即使偽陽性率再小,所產生的假警報數量還是會遠遠超過真陽性。
如何提高 PPV?針對高風險族群檢測(提高盛行率)、改用特異度更高的檢測,或以另一項獨立檢測來複驗確認。
這只適用於醫學檢測嗎?不只如此——同樣的貝氏邏輯也適用於垃圾郵件過濾、詐騙偵測、藥物篩檢,以及任何針對罕見事件的分類器。