什么是假阳性悖论?
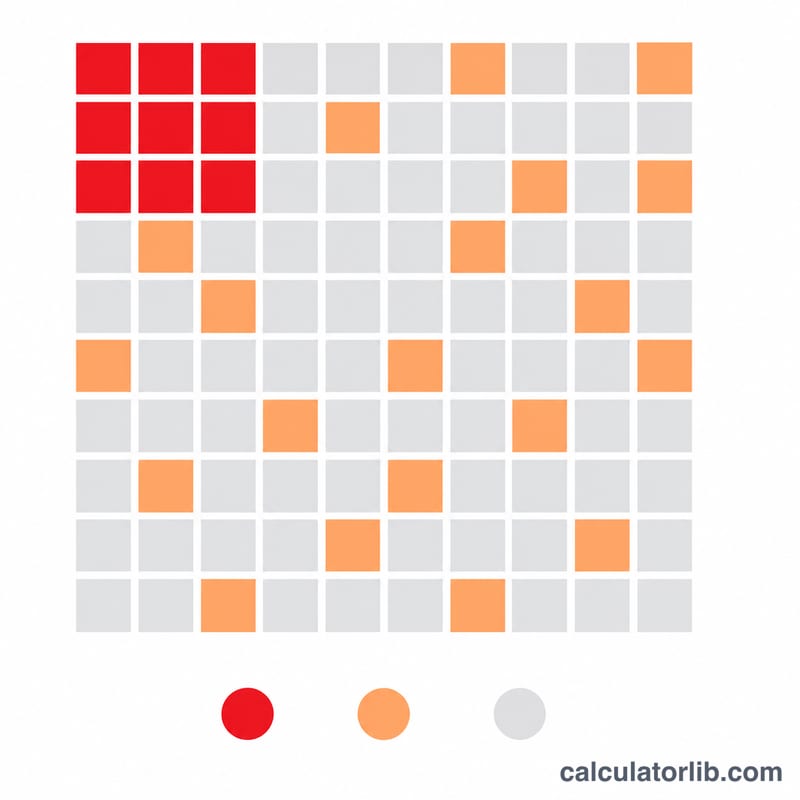
假阳性悖论揭示了医学检测与筛查中一个反直觉的事实:即便一项检测的准确率很高,当它要筛查的疾病本身十分罕见时,检出的"阳性"也大多是误报。本计算器运用贝叶斯定理,帮你算出检测呈阳性后真正患病的概率——也就是阳性预测值(PPV)。这个数字往往远低于检测宣传的整体准确率所给人的印象。
如何使用
请输入三个百分比:患病率(该疾病在受检人群中有多普遍)、灵敏度(患者被检出阳性的概率,即真阳性率),以及特异度(健康者被检出阴性的概率,即真阴性率)。计算器会返回一个阳性结果为真的概率,以及错误发现率。
公式解析
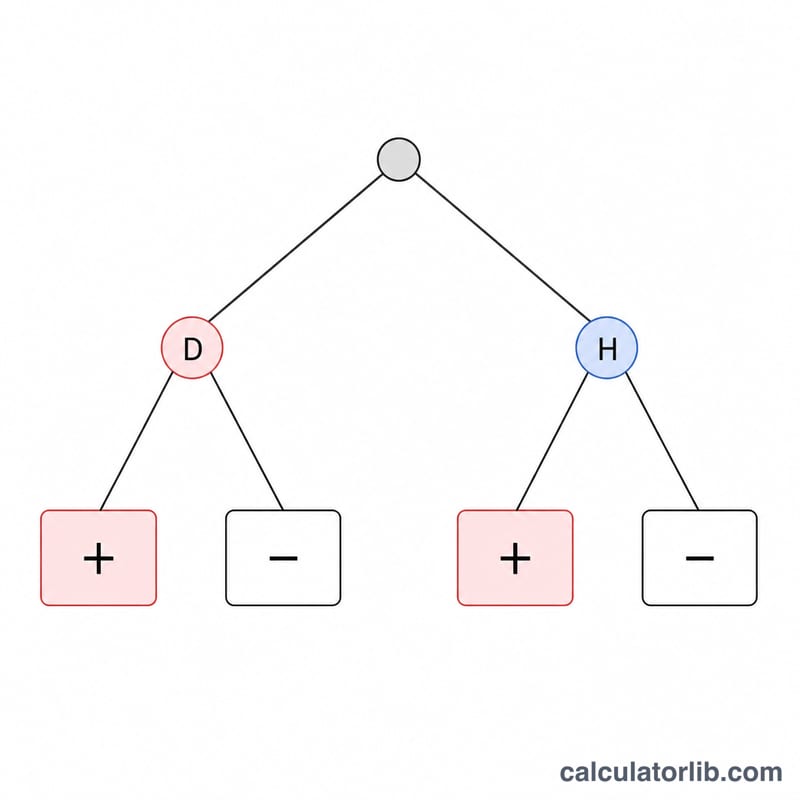
贝叶斯定理把"患者被正确检出阳性的概率"与"健康者被误判为阳性的概率"结合起来:
$$P(D\mid+) = \frac{\text{Sens} \cdot \text{Prev}}{\text{Sens} \cdot \text{Prev} + (1 - \text{Spec})(1 - \text{Prev})}$$分子是人群中既患病又被正确标记出来的比例。分母在此基础上加上了假阳性——也就是被错误标记的健康人。当患病率极低时,这一假阳性项就会占据主导地位。
实例演算
假设某疾病的患病率为1%(患病率 \(= 0.01\)),检测的灵敏度为99%、特异度为95%。真阳性 \(= 0.99 \times 0.01 = 0.0099\);假阳性 \(= 0.05 \times 0.99 = 0.0495\);
$$\text{PPV} = \frac{0.0099}{0.0099 + 0.0495} = \frac{0.0099}{0.0594} \approx 16.7\%$$换句话说,尽管这是一项"准确率99%"的检测,每6个阳性结果中也只有大约1个是真的。
患病率如何影响阳性预测值
下表将灵敏度固定为99%,特异度固定为95%,仅改变患病率。每一行均使用 \(\text{PPV} = \frac{ \text{Sens} \cdot \text{Prev} }{ \text{Sens} \cdot \text{Prev} + (1-\text{Spec})(1-\text{Prev}) }\),错误发现率(FDR)为 \(1-\text{PPV}\)。
| 患病率 | PPV | 错误发现率 |
|---|---|---|
| 0.1% | 1.94% | 98.06% |
| 1% | 16.67% | 83.33% |
| 5% | 51.03% | 48.97% |
| 10% | 68.75% | 31.25% |
| 25% | 86.84% | 13.16% |
| 50% | 95.19% | 4.81% |
1%一行的验算:\(\text{PPV} = \frac{0.99 \times 0.01}{0.99 \times 0.01 + 0.05 \times 0.99} = \frac{0.0099}{0.0594} \approx 0.1667\),即约16.7%。即使检测看似准确,当病症罕见时,大约六个阳性结果中有五个是假阳性。这就是假阳性悖论。
1%患病率下特异度的影响
灵敏度保持为99%,患病率保持为1%。
| 特异度 | PPV | 错误发现率 |
|---|---|---|
| 95% | 16.67% | 83.33% |
| 99% | 50.00% | 50.00% |
| 99.9% | 90.91% | 9.09% |
在低患病率下,特异度对PPV的影响非常大,因为假阳性来自庞大的健康人群。
关键术语:灵敏度、特异度、PPV等
- 患病率:受检人群中真正患有该病症的比例。
- 基础比率:患病率的另一种说法,即在得到任何检测结果之前,该病症的先验概率。
- 灵敏度(真阳性率):确实患有该病症且检测为阳性的人所占的比例。
- 特异度(真阴性率):未患该病症且检测为阴性的人所占的比例。
- 假阳性率:未患该病症但检测为阳性的人所占的比例,等于 \(1-\text{特异度}\)。
- 假阴性率:确实患有该病症但检测为阴性的人所占的比例,等于 \(1-\text{灵敏度}\)。
- 阳性预测值(PPV):阳性结果中为真阳性的比例。
- 错误发现率(FDR):阳性结果中为假阳性的比例,等于 \(1-\text{PPV}\)。
- 阴性预测值(NPV):阴性结果中为真阴性的比例。
灵敏度和特异度是检测本身的属性,不取决于患病率。PPV和NPV则取决于患病率,因此同一检测在不同人群中得到的预测值并不相同。
常见问题
为什么这个概率这么低?因为疾病罕见,意味着健康人远多于患者,所以哪怕假阳性率很小,产生的误报数量也会远超真阳性。
怎样才能提高PPV?对高风险人群进行检测(提高患病率)、采用特异度更高的检测,或者用第二项独立检测来复核确认。
这只适用于医学检测吗?不是。同样的贝叶斯逻辑也适用于垃圾邮件过滤、欺诈识别、药物筛查,以及任何针对罕见事件的分类判断。