
Công cụ này dùng để làm gì
Công Cụ Chọn Tên Ngẫu Nhiên / Xáo Danh Sách nhận bất kỳ danh sách nào bạn dán vào — tên người, con số hay các đoạn văn bản thường — rồi chọn hoặc xáo trộn các mục một cách ngẫu nhiên. Bạn có thể dùng để quay số trúng thưởng, gọi tên học sinh, chia đội nhóm, đảo thứ tự danh sách phát nhạc, hoặc đơn giản là trộn lẫn một trật tự cho mới. Mỗi lần nhấn là một kết quả mới, ngẫu nhiên hoàn toàn và đồng đều.
Cách sử dụng
Gõ hoặc dán danh sách tên hay lựa chọn, mỗi dòng một mục; một dòng ngăn bằng dấu phẩy cũng được. Bấm Quay hoặc phím cách. Tên trúng được chọn trước, sau đó vòng quay mới chạy và dừng đúng ô đó; nếu máy bạn bật chế độ giảm chuyển động, kết quả hiện ngay.
Số tên mỗi lượt bốc nhiều tên khác nhau cùng lúc. Bỏ tên vừa trúng gạch tên đã trúng khỏi danh sách, nên lượt sau là bốc không lặp lại; để trống nếu muốn cho trúng lại. Thêm " *3" sau một mục để mục đó có cơ hội gấp ba. Trộn và Xếp A–Z sắp lại danh sách, Chép kết quả chép tên trúng, Toàn màn hình để chiếu cho cả lớp. Chép liên kết đưa danh sách vào sau dấu # của địa chỉ, ai mở cũng thấy đúng vòng quay đó. Các lượt quay giữ trong tab này; bật Lưu trên máy này để giữ danh sách và lịch sử trong trình duyệt.
Kết quả có công bằng không?
Mọi kết quả lấy từ crypto.getRandomValues, bộ sinh số ngẫu nhiên mật mã có sẵn trong trình duyệt. Công cụ đổi các số đó thành kết quả bằng cách loại bỏ phần dư (rejection sampling), nên không kết quả nào được lợi nhờ phần dư, và hiệu ứng quay chỉ diễn lại kết quả đã được chọn trước khi bắt đầu. Không có gì được gửi lên máy chủ.
Ngẫu nhiên không có nghĩa là đều nhau trong ít lượt: tung mười lần, ra từ bảy lần ngửa trở lên xảy ra khoảng một lần trong sáu. Càng nhiều lượt, số lần càng gần tỉ lệ đã nêu. Công cụ không chứng minh được với người khác rằng bạn không quay lại, nên khi bốc thăm có giải thưởng, hãy quay trước mặt mọi người.
Giải thích công thức
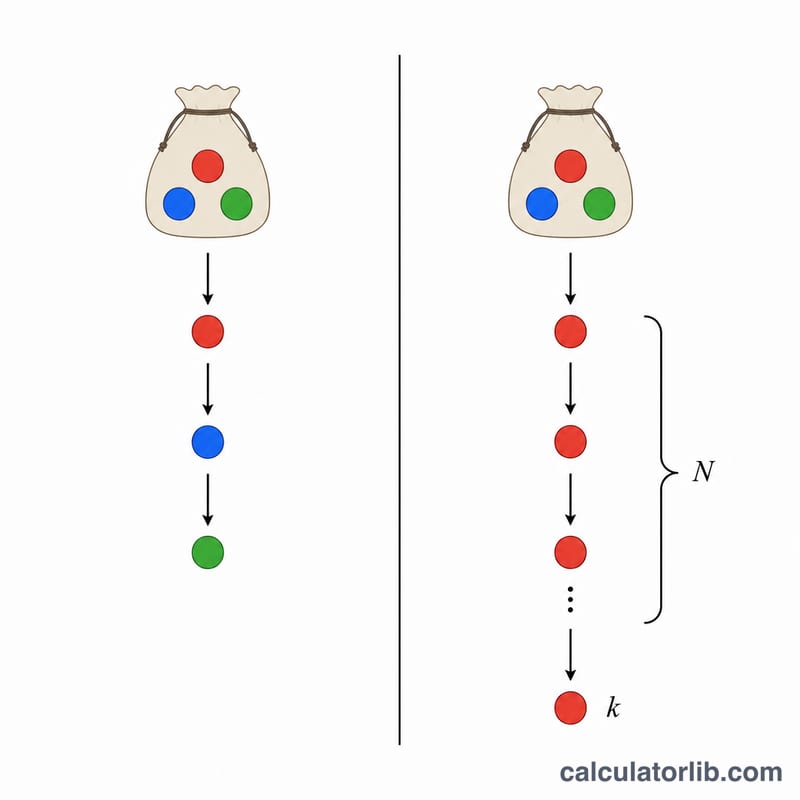
Gọi \(N\) là số mục đã tách được và \(k\) là số lượng bạn yêu cầu. Khi không cho lặp, công cụ chạy thuật toán xáo trộn Fisher-Yates (với \(i\) chạy từ \(N-1\) xuống 1, đổi chỗ mục \(i\) với một mục ngẫu nhiên đứng trước nó) rồi trả về
$$m = \min(k, N) \quad \text{(không hoàn lại)}$$mục đầu tiên — vậy nên khi \(k\) quá lớn, bạn chỉ đơn giản nhận lại toàn bộ danh sách đã được xáo trộn. Khi cho phép lặp, công cụ thực hiện \(k\) lần bốc độc lập, mỗi lần chọn một chỉ số ngẫu nhiên
$$j = \lfloor \text{rand}() \times N \rfloor$$nên các mục có thể lặp lại và \(k\) có thể lớn hơn \(N\). Việc sắp xếp dùng bộ so sánh tự nhiên: những mục trông giống con số sẽ so sánh theo giá trị số, còn lại so sánh như văn bản không phân biệt chữ hoa chữ thường.
Ví dụ minh họa
Danh sách: Liam, Ethan, Haley, 34, 25, 16, A, B, C (\(N = 9\)). Chọn = 9, lặp = Không, sắp xếp = không. Vì \(k\) bằng \(N\) nên đây là một lần xáo trộn toàn bộ, cả 9 mục đều được trả về theo một trong \(9! = 362{,}880\) thứ tự có khả năng xảy ra như nhau, ví dụ: 34, Ethan, B, A, 25, C, Liam, 16, Haley.
So sánh lấy mẫu có và không lặp lại: Các kịch bản
Bảng dưới đây sử dụng một danh sách gồm N = 10 mục khác nhau. Không lặp lại, mỗi mục chỉ có thể xuất hiện tối đa một lần, nên số lần chọn bị giới hạn ở \(k = \min(\text{số lần chọn}, n)\). Có lặp lại, mỗi lần rút là độc lập và bất kỳ mục nào cũng có thể được chọn lại.
| Kịch bản | k | Cài đặt lặp lại | Số kết quả có thứ tự có thể có | Khả năng một mục cụ thể được chọn | Có thể trùng lặp không? |
|---|---|---|---|---|---|
| Chọn 1 | 1 | Cả hai | 10 | 10% | Không |
| Chọn 3, không lặp lại | 3 | Không | 720 (10 × 9 × 8) | 30% (3/10) | Không |
| Chọn 3, có lặp lại | 3 | Có | 1.000 (103) | 27,1% (1 − 0,93) | Có |
| Chọn 10, không lặp lại | 10 | Không | 3.628.800 (10!) | 100% | Không |
| Chọn 15, có lặp lại | 15 | Có | 1015 | 79,4% (1 − 0,915) | Có |
Các công thức được sử dụng:
- Không lặp lại: số kết quả \(= \dfrac{n!}{(n-k)!}\) và \(P(\text{mục được chọn}) = \dfrac{k}{n}\).
- Có lặp lại: số kết quả \(= n^k\) và \(P(\text{mục được chọn ít nhất một lần}) = 1 - \left(1 - \dfrac{1}{n}\right)^k\).
Lưu ý rằng yêu cầu chọn 15 lần không lặp lại từ 10 mục chỉ trả về 10 kết quả, vì k bị giới hạn ở n. Chọn tất cả n mục không lặp lại cũng giống như xáo trộn toàn bộ danh sách.
Thuật ngữ chính: Lấy mẫu, Thay thế và Xáo trộn
- Mẫu ngẫu nhiên
- Một tập con các mục được chọn ngẫu nhiên từ một danh sách lớn hơn, sao cho việc chọn không phụ thuộc vào vị trí hoặc nội dung của mục.
- Có thay thế so với không thay thế
- Có thay thế (cho phép lặp lại), một mục được đặt lại sau khi được rút và có thể được chọn lại. Không thay thế (tắt lặp lại), một mục đã rút được loại khỏi tập, nên mọi kết quả đều khác nhau.
- Ngẫu nhiên đều
- Mọi lựa chọn có thể đều có khả năng xảy ra như nhau. Trong một lần rút từ n mục, mỗi mục có xác suất \(1/n\).
- Xáo trộn Fisher-Yates
- Một thuật toán xáo trộn không thiên lệch tiêu chuẩn. Đi từ cuối danh sách đến đầu, nó hoán đổi vị trí hiện tại với một vị trí được chọn ngẫu nhiên tại hoặc trước vị trí đó. Mọi thứ tự đều có khả năng xảy ra như nhau, với điều kiện các số ngẫu nhiên là tốt. Lấy k mục đầu tiên của một lần xáo trộn như vậy sẽ cho một mẫu không thay thế.
- Hoán vị (n!)
- Một thứ tự cụ thể của các mục. Một danh sách gồm n mục khác nhau có \(n! = n \times (n-1) \times \dots \times 1\) thứ tự; với 10 mục là 3.628.800.
- Thứ tự sắp xếp tự nhiên
- Một cách sắp xếp so sánh các số nhúng trong chuỗi theo giá trị thay vì từng ký tự, nên "item2" đứng trước "item10". Sắp xếp theo bảng chữ cái thông thường sẽ đặt "item10" lên trước.
- Token / mục đã phân tích
- Một mục được trích ra từ văn bản bạn dán vào sau khi tách thành các phần (ví dụ, theo dòng) và cắt bỏ khoảng trắng thừa xung quanh. Các mục rỗng bị bỏ qua, và số lượng mục còn lại là n.
Câu hỏi thường gặp
Vì sao mỗi lần kết quả lại khác nhau? Việc bốc là ngẫu nhiên, nên chạy lại sẽ cho ra thứ tự hoặc lựa chọn mới — đó là điều cố ý.
Nếu tôi yêu cầu nhiều mục hơn số mục trong danh sách thì sao? Khi không cho lặp, số lượng sẽ bị giới hạn bằng kích thước danh sách (bạn nhận lại toàn bộ danh sách đã xáo trộn). Khi cho phép lặp, bạn nhận đúng số lượng đã yêu cầu.
Dấu phẩy và khoảng trắng được xử lý thế nào? Các mục được tách theo dấu phẩy và dấu xuống dòng, những mục rỗng (như dấu phẩy thừa ở cuối) sẽ bị bỏ qua, và khoảng trắng thừa ở hai đầu cũng được cắt bỏ để kết quả gọn gàng hơn.