¿Qué es la calculadora de tokens a palabras y coste?
Los grandes modelos de lenguaje (LLM) como GPT, Claude o Gemini procesan el texto en tokens y no en palabras. Un token es un fragmento de texto —a menudo una parte de palabra de unos cuatro caracteres—. Esta calculadora estima cuántas palabras representa una cantidad determinada de tokens y cuánto cuestan esos tokens según el precio por millón de tokens de cada modelo.
Cómo usarla
Introduce el número de tokens, la proporción de palabras por token (0,75 es un buen valor por defecto para texto en inglés) y, si quieres, el precio que cobra tu proveedor por cada millón (1M) de tokens; déjalo en blanco para calcular solo las palabras. La herramienta te devuelve al instante el número estimado de palabras y, si has indicado un precio, el coste en dólares.
La fórmula explicada
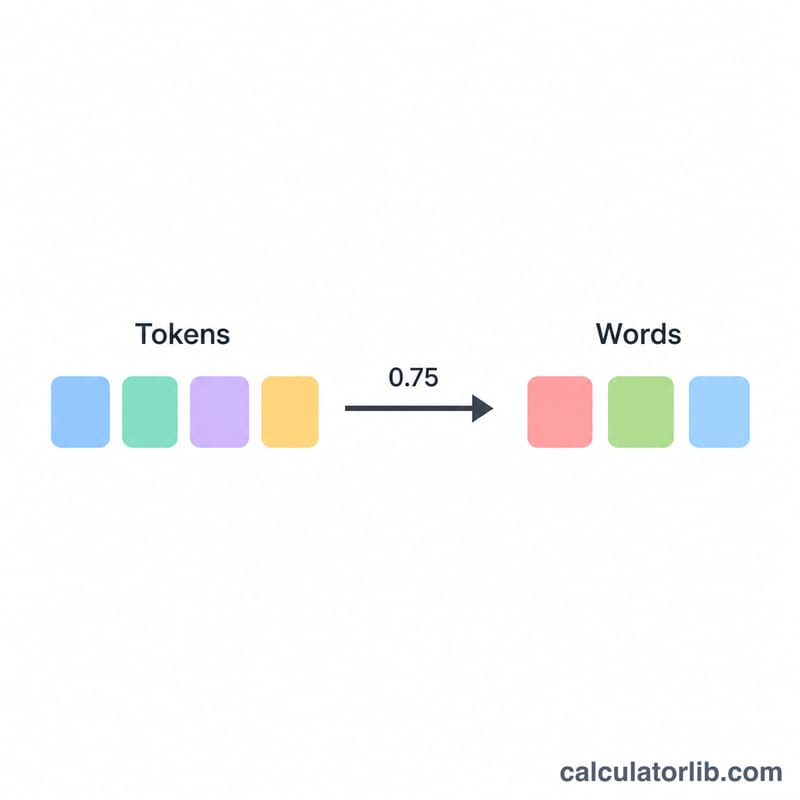
La estimación de palabras utiliza \(\text{palabras} \approx \text{tokens} \times 0{,}75\), basándose en la regla práctica de OpenAI para el inglés: 1 token ≈ 4 caracteres ≈ 0,75 palabras. El coste se calcula como $$\text{coste} = \frac{\text{tokens}}{1.000.000} \times \text{precio por 1M}$$ ya que la mayoría de los proveedores publican sus precios por millón de tokens. Ajusta la proporción para otros idiomas o para código, que suelen consumir más tokens por palabra.
Ejemplo práctico
Imagina que tienes 1.000 tokens con una proporción de 0,75 y un precio de 2 USD por cada millón de tokens. Palabras = \(1000 \times 0{,}75 = \mathbf{750}\) palabras. Coste = \(\frac{1.000}{1.000.000} \times 2 = \mathbf{0{,}002}\) USD.
Preguntas frecuentes
¿Qué precisión tiene la estimación de palabras? Es una aproximación. La tokenización real varía según el modelo y el contenido; 0,75 palabras por token es una buena media para el inglés.
¿Cuestan lo mismo los tokens de entrada y de salida? No: muchos proveedores aplican tarifas distintas. Usa la calculadora dos veces, una con cada tarifa, y suma los resultados.
¿Por qué difieren el código o los textos en otros idiomas? Suelen agrupar más tokens por palabra, así que conviene bajar la proporción (por ejemplo, a 0,5) para obtener una estimación más fiel. El español, en particular, tiende a usar más tokens por palabra que el inglés.