¿Qué es la calculadora de tokens a palabras?
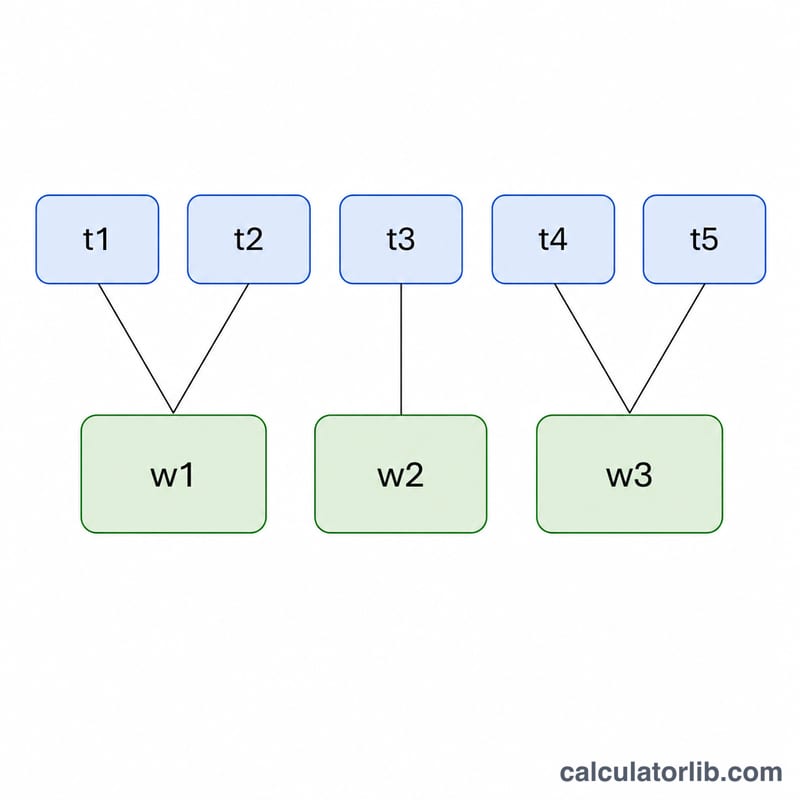
Los grandes modelos de lenguaje (LLM) como GPT, Claude o Gemini no leen el texto palabra por palabra: lo procesan en tokens. Un token es un fragmento de texto que puede ser una palabra completa, una parte de una palabra o incluso un signo de puntuación. En la prosa habitual en inglés, un token equivale aproximadamente a 0,75 palabras (es decir, alrededor de 1,33 tokens por palabra). Esta calculadora transforma un número de tokens en una estimación de palabras, o un número de palabras en los tokens que probablemente consumirá.
Cómo usarla
Elige la dirección —De tokens a palabras o De palabras a tokens—, introduce la cantidad y, si lo deseas, ajusta la proporción de palabras por token (por defecto 0,75). La herramienta muestra al instante la cifra convertida junto con la proporción aplicada. Reduce la proporción para código o texto en otros idiomas (que suelen consumir más tokens) y auméntala para un inglés sencillo y repetitivo.
La fórmula explicada
La conversión es una simple proporción. Para estimar palabras a partir de tokens:
$$\text{palabras} = \text{tokens} \times \text{proporción}$$Para estimar tokens a partir de palabras:
$$\text{tokens} = \frac{\text{palabras}}{\text{proporción}}$$Con la proporción por defecto de 0,75, 1.000 tokens ≈ 750 palabras y 1.000 palabras ≈ 1.333 tokens. Son estimaciones: la tokenización real depende del modelo, el idioma y el contenido.
Ejemplo práctico
Imagina que una llamada a la API indica que usó 1.000 tokens. Con la proporción por defecto:
$$1000 \times 0{,}75 = 750 \text{ palabras}$$Y si has escrito un ensayo de 1.500 palabras y quieres saber su coste en tokens:
$$1500 \div 0{,}75 = 2000 \text{ tokens}$$algo muy útil para no superar la ventana de contexto de un modelo o para controlar el gasto en la API.
Conversiones comunes de tokens a palabras
La tabla siguiente usa la regla práctica habitual de unas 0,75 palabras por token (aproximadamente 4 caracteres de texto en inglés por token), así que \(\text{Palabras} = \text{Tokens} \times 0.75\). Las páginas suponen unas 500 palabras por página a un solo espacio. Todos los valores son estimaciones; los recuentos reales dependen del tokenizador, el idioma y el contenido.
| Tokens | Palabras aprox. (×0,75) | Páginas aprox. (~500 palabras/página) |
|---|---|---|
| 100 | 75 | 0,15 |
| 500 | 375 | 0,75 |
| 1.000 | 750 | 1,5 |
| 4.000 | 3.000 | 6 |
| 8.000 | 6.000 | 12 |
| 32.000 | 24.000 | 48 |
| 128.000 | 96.000 | 192 |
| 200.000 | 150.000 | 300 |
Para hacer el cálculo en sentido contrario, divide las palabras entre la proporción: \(\text{Tokens} = \text{Palabras} \div 0.75\). Por ejemplo, 1.500 palabras ≈ \(1500 \div 0.75 = 2000\) tokens.
Palabras por token según el tipo de contenido
Los distintos tipos de texto se dividen en tokens de forma diferente. Las proporciones siguientes son reglas prácticas aproximadas y varían según el tokenizador y el modelo, así que trata los resultados como estimaciones y usa el tokenizador oficial de tu proveedor cuando necesites precisión.
| Tipo de contenido | Palabras por token típicas (aprox.) | Palabras en 1.000 tokens (aprox.) |
|---|---|---|
| Prosa en inglés sencilla | ~0,75 | ~750 |
| Inglés técnico o jurídico | ~0,65–0,70 | ~650–700 |
| Código fuente | ~0,5–0,6 | ~500–600 |
| Idiomas distintos del inglés o escrituras no latinas | ~0,3–0,5 | ~300–500 |
| Texto con muchos números y caracteres especiales | A menudo por debajo de ~0,5 (muy variable) | A menudo por debajo de ~500 |
¿Por qué hay diferencias? Las palabras comunes del inglés suelen ser un solo token, mientras que las palabras poco frecuentes, los términos técnicos largos, los símbolos, los dígitos y muchos caracteres no latinos se dividen en varios fragmentos más pequeños. El código también cuenta los espacios en blanco, la puntuación y los símbolos, lo que reduce las palabras por token. En la calculadora, cambia el campo de proporción para que coincida con tu tipo de contenido.
Términos clave: tokens, ventana de contexto y tokenizador
- Token
- La unidad básica de texto que un modelo de lenguaje lee y escribe. Un token puede ser una palabra completa, parte de una palabra, un signo de puntuación o un fragmento formado por un espacio y una palabra.
- Tokenizador
- El componente que convierte el texto en una secuencia de tokens (y viceversa). Cada familia de modelos usa su propio tokenizador y vocabulario, así que el mismo texto puede producir recuentos de tokens distintos.
- Codificación por pares de bytes (BPE)
- Un método de tokenización habitual que parte de unidades pequeñas (como bytes o caracteres) y fusiona repetidamente los pares adyacentes más frecuentes en tokens más grandes, construyendo un vocabulario en el que las palabras comunes son tokens individuales y las palabras poco frecuentes se dividen en fragmentos.
- Ventana de contexto
- El número máximo de tokens que un modelo puede procesar en una solicitud, que normalmente incluye en conjunto el prompt, el historial de la conversación y la respuesta generada.
- Tokens de entrada frente a tokens de salida
- Los tokens de entrada son los que envías al modelo (prompt, documentos, historial); los tokens de salida son los que genera el modelo. Los proveedores suelen contarlos por separado y pueden cobrarlos y limitarlos de forma diferente.
- Proporción de palabras por token
- El número medio de palabras que representa un token. Unas 0,75 es una regla práctica habitual para la prosa en inglés (aproximadamente 1 token ≈ 4 caracteres), pero es una aproximación que cambia según el idioma y el tipo de contenido.
Preguntas frecuentes
¿0,75 palabras por token es siempre exacto? No: es una regla práctica muy citada para el inglés. El código, los números y otros idiomas suelen usar más tokens por palabra, así que conviene aplicar una proporción más baja en esos casos.
¿Por qué importan los tokens? Los precios y los límites de contexto de los LLM se miden en tokens, no en palabras, por lo que convertir te ayuda a estimar el coste y el ajuste al contexto.
¿Cómo consigo recuentos exactos? Usa el tokenizador oficial del modelo (por ejemplo, tiktoken en el caso de OpenAI). Esta calculadora ofrece una aproximación rápida, no un recuento exacto.