토큰-단어 변환 계산기란?
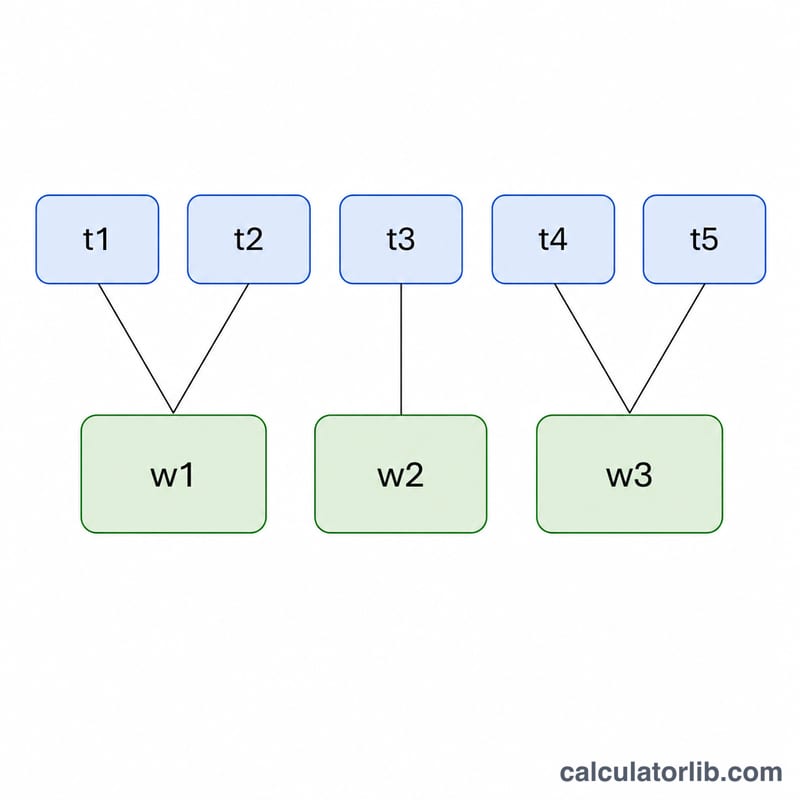
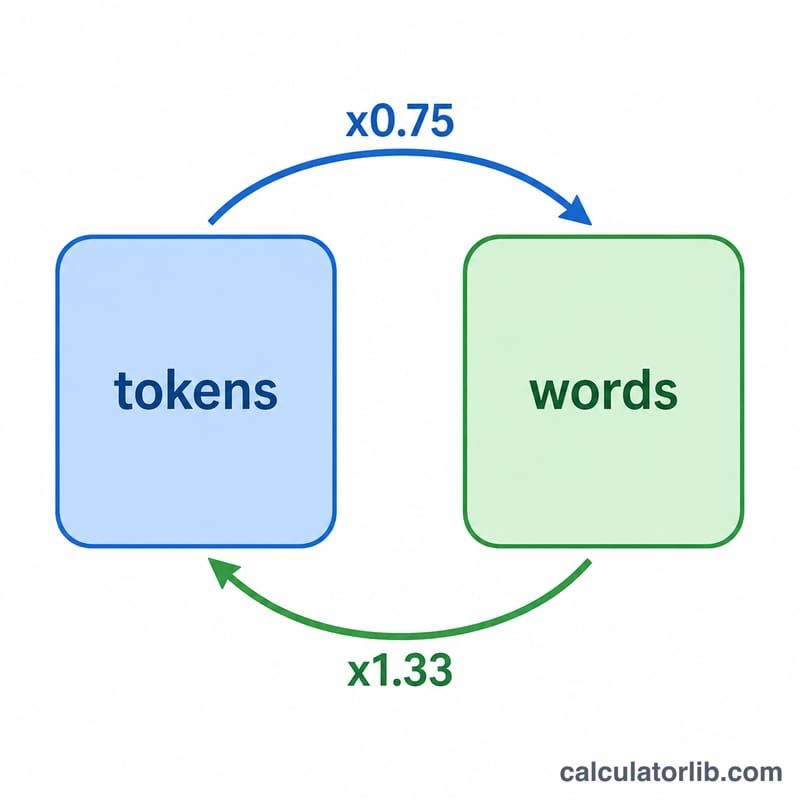
GPT, Claude, Gemini 같은 대규모 언어 모델(LLM)은 텍스트를 단어 단위로 읽지 않고 토큰 단위로 처리합니다. 토큰은 하나의 단어 전체일 수도 있고, 단어의 일부, 심지어 문장 부호일 수도 있는 텍스트 조각입니다. 일반적인 영어 문장에서는 토큰 하나가 대략 0.75단어에 해당합니다(즉, 단어 하나당 약 1.33토큰). 이 계산기는 토큰 수를 예상 단어 수로, 또는 단어 수를 소비될 토큰 수로 변환해 줍니다.
사용 방법
먼저 변환 방향을 선택하세요 — 토큰 → 단어 또는 단어 → 토큰. 그런 다음 값을 입력하고, 필요하면 토큰당 단어 수 비율(기본값 0.75)을 조정하면 됩니다. 변환된 값과 적용된 비율이 즉시 표시됩니다. 코드나 한국어를 포함한 비영어 텍스트는 토큰을 더 많이 사용하는 경향이 있으므로 비율을 낮추고, 단순하고 반복적인 영어 텍스트는 비율을 높여 보세요.
계산 공식
변환은 단순 비례식입니다. 토큰으로 단어를 추정하려면 $$\text{단어} = \text{토큰} \times \text{비율}$$ 단어로 토큰을 추정하려면 $$\text{토큰} = \frac{\text{단어}}{\text{비율}}$$ 입니다. 기본 비율 0.75를 적용하면 1,000토큰 ≈ 750단어, 1,000단어 ≈ 1,333토큰이 됩니다. 어디까지나 추정치이며, 실제 토큰화는 모델, 언어, 콘텐츠에 따라 달라집니다.
예시로 살펴보기
예를 들어 어떤 API 호출이 1,000토큰을 사용했다고 표시한다면, 기본 비율로 계산하면 $$1000 \times 0.75 = 750\,\text{단어}$$ 입니다. 반대로 1,500단어 분량의 글을 써놓고 토큰 비용이 궁금하다면 $$1500 \div 0.75 = 2{,}000\,\text{토큰}$$ 이 됩니다. 모델의 컨텍스트 한도 안에 들어가도록 관리하거나 API 비용을 예측할 때 유용합니다.
일반적인 토큰-단어 변환
아래 표는 토큰당 약 0.75단어(토큰당 영어 텍스트 약 4자)라는 일반적인 경험 법칙을 사용하며, \(\text{단어 수} = \text{토큰 수} \times 0.75\)입니다. 페이지는 단일 간격 기준 페이지당 약 500단어로 가정합니다. 모든 값은 추정치입니다. 실제 개수는 토크나이저, 언어 및 내용에 따라 달라집니다.
| 토큰 수 | 대략적인 단어 수 (×0.75) | 대략적인 페이지 수 (페이지당 약 500단어) |
|---|---|---|
| 100 | 75 | 0.15 |
| 500 | 375 | 0.75 |
| 1,000 | 750 | 1.5 |
| 4,000 | 3,000 | 6 |
| 8,000 | 6,000 | 12 |
| 32,000 | 24,000 | 48 |
| 128,000 | 96,000 | 192 |
| 200,000 | 150,000 | 300 |
반대로 계산하려면 단어 수를 비율로 나눕니다: \(\text{토큰 수} = \text{단어 수} \div 0.75\). 예를 들어 1,500단어 ≈ \(1500 \div 0.75 = 2000\)토큰입니다.
콘텐츠 유형별 토큰당 단어 수
텍스트 종류에 따라 토큰으로 나뉘는 방식이 다릅니다. 아래 비율은 대략적인 경험 법칙이며 토크나이저와 모델에 따라 달라지므로, 결과는 추정치로 보시고 정확성이 중요하다면 제공업체의 공식 토크나이저를 사용하세요.
| 콘텐츠 유형 | 일반적인 토큰당 단어 수 (대략) | 1,000토큰에 해당하는 단어 수 (대략) |
|---|---|---|
| 일반 영어 산문 | ~0.75 | ~750 |
| 기술 또는 법률 영어 | ~0.65–0.70 | ~650–700 |
| 소스 코드 | ~0.5–0.6 | ~500–600 |
| 영어가 아니거나 라틴 문자가 아닌 문자 | ~0.3–0.5 | ~300–500 |
| 숫자 및 특수 문자가 많은 텍스트 | 대개 ~0.5 미만 (편차 큼) | 대개 ~500 미만 |
왜 차이가 날까요? 흔한 영어 단어는 대개 하나의 토큰이지만, 드문 단어, 긴 기술 용어, 기호, 숫자 및 많은 비라틴 문자는 여러 개의 작은 조각으로 나뉩니다. 코드는 공백, 구두점, 기호도 계산에 포함하므로 토큰당 단어 수가 줄어듭니다. 계산기에서는 콘텐츠 유형에 맞게 비율 입력란을 변경하세요.
핵심 용어: 토큰, 컨텍스트 윈도우, 토크나이저
- 토큰
- 언어 모델이 읽고 쓰는 텍스트의 기본 단위입니다. 토큰은 단어 전체, 단어의 일부, 구두점 또는 공백과 단어가 결합된 조각일 수 있습니다.
- 토크나이저
- 텍스트를 토큰 시퀀스로 (그리고 다시 텍스트로) 변환하는 구성 요소입니다. 모델 계열마다 고유한 토크나이저와 어휘 사전을 사용하므로, 같은 텍스트라도 토큰 수가 다르게 나올 수 있습니다.
- 바이트 쌍 인코딩 (BPE)
- 바이트나 문자 같은 작은 단위에서 시작하여 가장 자주 나타나는 인접한 쌍을 반복적으로 병합해 더 큰 토큰을 만드는 일반적인 토큰화 방법입니다. 이를 통해 흔한 단어는 하나의 토큰이 되고 드문 단어는 여러 조각으로 나뉘는 어휘 사전을 구축합니다.
- 컨텍스트 윈도우
- 모델이 한 번의 요청에서 처리할 수 있는 최대 토큰 수입니다. 일반적으로 프롬프트, 대화 기록, 생성된 응답을 모두 합친 양을 포함합니다.
- 입력 토큰과 출력 토큰
- 입력 토큰은 모델에 보내는 토큰(프롬프트, 문서, 기록)이고, 출력 토큰은 모델이 생성하는 토큰입니다. 제공업체는 이 둘을 별도로 계산하며 요금과 한도를 다르게 적용하는 경우가 많습니다.
- 단어-토큰 비율
- 토큰 하나가 나타내는 평균 단어 수입니다. 영어 산문에서는 약 0.75가 흔한 경험 법칙(대략 토큰 1개 ≈ 4자)이지만, 이는 언어와 콘텐츠 유형에 따라 달라지는 근사치입니다.
자주 묻는 질문
토큰당 0.75단어가 항상 정확한가요? 아닙니다. 이는 영어에 널리 통용되는 경험적 기준일 뿐입니다. 코드, 숫자, 그리고 한국어를 비롯한 다른 언어는 단어당 토큰을 더 많이 쓰는 경우가 많으므로 그런 경우에는 비율을 낮춰 사용하세요.
토큰이 왜 중요한가요? LLM의 요금과 컨텍스트 한도는 단어가 아닌 토큰을 기준으로 측정되므로, 변환을 통해 비용과 입력 가능 분량을 예측할 수 있습니다.
정확한 토큰 수는 어떻게 알 수 있나요? 모델의 공식 토크나이저(예: OpenAI의 tiktoken)를 사용하세요. 이 계산기는 정확한 수치가 아닌 빠른 근사치를 제공합니다.