ما هي حاسبة تحويل التوكنز إلى كلمات؟
لا تقرأ نماذج اللغة الكبيرة (LLM) مثل GPT وClaude وGemini النص كلمةً كلمة، بل تعالجه على هيئة توكنز (رموز). والتوكن هو وحدة نصية قد تكون كلمة كاملة أو جزءًا من كلمة أو حتى علامة ترقيم. وفي النصوص الإنجليزية الاعتيادية، يقابل التوكن الواحد نحو 0.75 كلمة (أي ما يعادل تقريبًا 1.33 توكن لكل كلمة). تحوّل هذه الحاسبة عدد التوكنز إلى عدد كلمات تقديري، أو تحوّل عدد الكلمات إلى عدد التوكنز الذي يُرجَّح أن تستهلكه.
طريقة الاستخدام
اختر اتجاه التحويل — من التوكنز إلى الكلمات أو من الكلمات إلى التوكنز — ثم أدخل الكمية، ويمكنك إن شئت تعديل نسبة الكلمات لكل توكن (القيمة الافتراضية 0.75). تعرض الأداة فورًا الرقم المحوَّل إلى جانب النسبة المستخدمة. اخفض النسبة عند التعامل مع الأكواد البرمجية أو النصوص بغير الإنجليزية (التي تميل إلى استهلاك توكنز أكثر)، وارفعها مع النصوص الإنجليزية البسيطة والمتكررة.
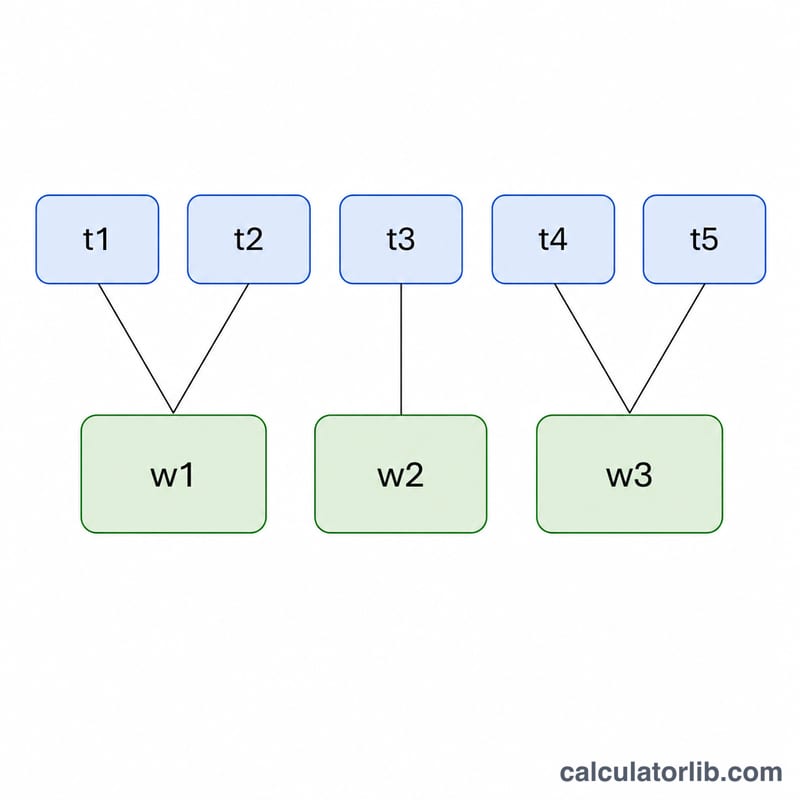
شرح المعادلة
التحويل قائم على نسبة بسيطة. لتقدير عدد الكلمات من التوكنز:
$$\text{الكلمات} = \text{التوكنز} \times \text{النسبة}$$ولتقدير عدد التوكنز من الكلمات:
$$\text{التوكنز} = \frac{\text{الكلمات}}{\text{النسبة}}$$وبالنسبة الافتراضية 0.75، فإن 1000 توكن ≈ 750 كلمة، و1000 كلمة ≈ 1333 توكنًا. وتبقى هذه أرقامًا تقديرية، إذ تعتمد التجزئة الفعلية إلى توكنز على النموذج واللغة وطبيعة المحتوى.
مثال عملي
افترض أن استدعاءً لواجهة برمجة (API) أفاد باستهلاك 1000 توكن. باستخدام النسبة الافتراضية:
$$1000 \times 0.75 = 750 \text{ كلمة}$$وإذا كتبت بدلًا من ذلك مقالًا من 1500 كلمة وأردت معرفة تكلفته بالتوكنز:
$$1500 \div 0.75 = 2000 \text{ توكن}$$— وهو ما يفيد في البقاء ضمن نافذة السياق للنموذج أو ضبط ميزانية استخدام الـ API.
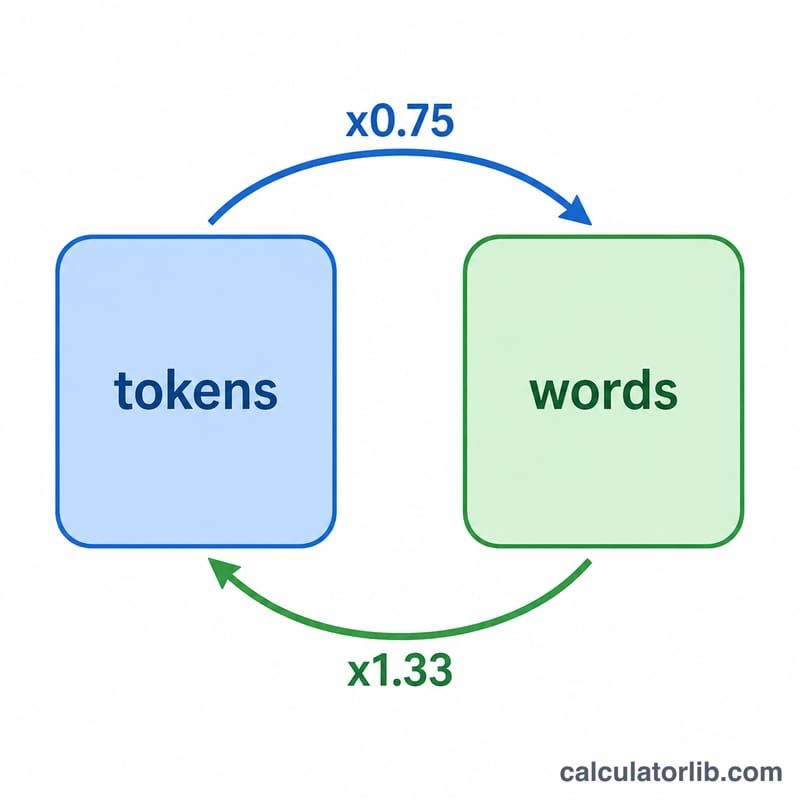
تحويل الرموز إلى كلمات الشائع
يستخدم الجدول أدناه قاعدة الإبهام الشائعة لنحو 0.75 كلمة لكل رمز (تقريباً 4 أحرف من النص الإنجليزي لكل رمز)، لذا فإن \(\text{Words} = \text{Tokens} \times 0.75\). تفترض الصفحات نحو 500 كلمة لكل صفحة بمسافة مفردة. جميع القيم تقديرية؛ تعتمد الأعداد الفعلية على أداة الترميز واللغة والمحتوى.
| الرموز | عدد الكلمات التقريبي (×0.75) | عدد الصفحات التقريبي (~500 كلمة/صفحة) |
|---|---|---|
| 100 | 75 | 0.15 |
| 500 | 375 | 0.75 |
| 1,000 | 750 | 1.5 |
| 4,000 | 3,000 | 6 |
| 8,000 | 6,000 | 12 |
| 32,000 | 24,000 | 48 |
| 128,000 | 96,000 | 192 |
| 200,000 | 150,000 | 300 |
للتحويل في الاتجاه المعاكس، اقسم عدد الكلمات على النسبة: \(\text{Tokens} = \text{Words} \div 0.75\). على سبيل المثال، 1,500 كلمة ≈ \(1500 \div 0.75 = 2000\) رمز.
عدد الكلمات لكل رمز حسب نوع المحتوى
تُقسَّم أنواع النصوص المختلفة إلى رموز بطرق مختلفة. النسب أدناه قواعد إبهام تقريبية وتختلف حسب أداة الترميز والنموذج، لذا تعامل مع النتائج على أنها تقديرات، واستخدم أداة الترميز الرسمية لمزوّد الخدمة عندما تكون الدقة مهمة.
| نوع المحتوى | عدد الكلمات النموذجي لكل رمز (تقريبي) | عدد الكلمات في 1,000 رمز (تقريبي) |
|---|---|---|
| النثر الإنجليزي العادي | ~0.75 | ~750 |
| الإنجليزية التقنية أو القانونية | ~0.65–0.70 | ~650–700 |
| الشيفرة المصدرية | ~0.5–0.6 | ~500–600 |
| اللغات غير الإنجليزية أو الأبجديات غير اللاتينية | ~0.3–0.5 | ~300–500 |
| النصوص الكثيفة بالأرقام والرموز الخاصة | غالباً أقل من ~0.5 (متغير بشدة) | غالباً أقل من ~500 |
لماذا تختلف هذه النسب؟ الكلمات الإنجليزية الشائعة غالباً ما تكون رمزاً واحداً، بينما تُقسَّم الكلمات النادرة والمصطلحات التقنية الطويلة والرموز والأرقام والكثير من الحروف غير اللاتينية إلى أجزاء أصغر عدة. كما تحتسب الشيفرة المسافات وعلامات الترقيم والرموز، مما يقلل عدد الكلمات لكل رمز. في الحاسبة، غيّر حقل النسبة ليتوافق مع نوع المحتوى لديك.
المصطلحات الأساسية: الرموز ونافذة السياق وأداة الترميز
- الرمز (Token)
- الوحدة الأساسية للنص التي يقرؤها نموذج اللغة ويكتبها. قد يكون الرمز كلمة كاملة أو جزءاً من كلمة أو علامة ترقيم أو مقطعاً يتكون من مسافة وكلمة.
- أداة الترميز (Tokenizer)
- المكوّن الذي يحوّل النص إلى سلسلة من الرموز (والعكس). لكل عائلة نماذج أداة ترميز ومفردات خاصة بها، لذا قد ينتج النص نفسه أعداداً مختلفة من الرموز.
- ترميز أزواج البايتات (BPE)
- طريقة شائعة للترميز تبدأ من وحدات صغيرة (مثل البايتات أو الحروف) وتدمج بشكل متكرر أكثر الأزواج المتجاورة تكراراً في رموز أكبر، مما يبني مفردات تكون فيها الكلمات الشائعة رموزاً مفردة وتُقسَّم الكلمات النادرة إلى أجزاء.
- نافذة السياق (Context window)
- الحد الأقصى لعدد الرموز التي يمكن للنموذج معالجتها في طلب واحد، وتشمل عادةً المطالبة وسجل المحادثة والرد المُولَّد معاً.
- رموز الإدخال مقابل رموز الإخراج
- رموز الإدخال هي ما ترسله إلى النموذج (المطالبة والمستندات والسجل)، ورموز الإخراج هي ما يولّده النموذج. غالباً ما يحسب المزوّدون هذين النوعين بشكل منفصل وقد يسعّرونهما ويحددانهما بشكل مختلف.
- نسبة الكلمات لكل رمز
- متوسط عدد الكلمات التي يمثلها رمز واحد. تُعد نحو 0.75 قاعدة إبهام شائعة للنثر الإنجليزي (تقريباً 1 رمز ≈ 4 أحرف)، لكنها تقريب يتغير مع اللغة ونوع المحتوى.
الأسئلة الشائعة
هل نسبة 0.75 كلمة لكل توكن دقيقة دائمًا؟ لا، فهي قاعدة تقريبية شائعة للنصوص الإنجليزية. أما الأكواد والأرقام واللغات الأخرى فغالبًا ما تستهلك توكنز أكثر لكل كلمة، لذا استخدم نسبة أقل معها.
لماذا تهمّ التوكنز؟ لأن أسعار نماذج LLM وحدود السياق تُقاس بالتوكنز لا بالكلمات، فالتحويل يساعدك على تقدير التكلفة ومدى ملاءمة النص.
كيف أحصل على عدد دقيق؟ استخدم أداة التجزئة الرسمية الخاصة بالنموذج (مثل tiktoken لدى OpenAI). تقدّم هذه الحاسبة تقديرًا سريعًا وليس عددًا دقيقًا.