ما هي حاسبة متطلبات ذاكرة VRAM لنماذج اللغة الكبيرة؟
تساعدك هذه الأداة على تقدير حجم ذاكرة كرت الشاشة (VRAM) اللازمة لتحميل نموذج لغوي كبير (LLM) وتشغيله في مرحلة الاستدلال. يتحدد حجم الذاكرة المطلوب في المقام الأول بعدد معاملات النموذج وبدقة التمثيل الرقمي المستخدمة لتخزين كل وزن. أما عامل الهامش (الأمان الإضافي) فيأخذ في الحسبان ذاكرة الـ KV cache والتنشيطات وسياق CUDA، وهي عناصر تستهلك ذاكرة إضافية تتجاوز حجم الأوزان الخام وحده.
كيفية الاستخدام
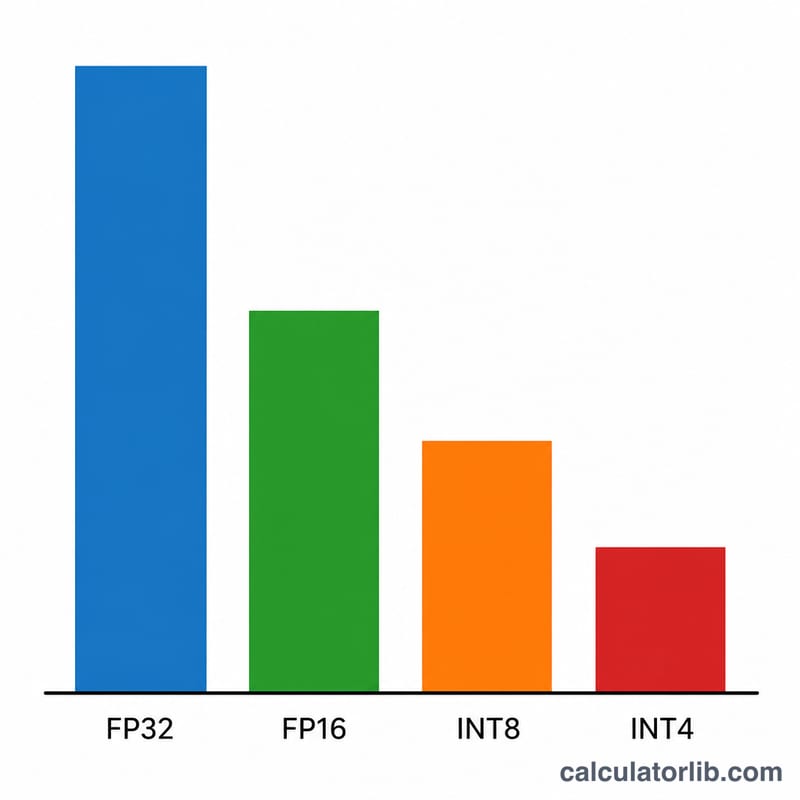
أدخل حجم النموذج بالمليارات من المعاملات (مثلاً 7 لنموذج بحجم 7B، أو 70 لنموذج Llama-3 70B). ثم اختر دقة التخزين: تستهلك دقة FP32 أربعة بايت لكل وزن، بينما تستهلك FP16/BF16 بايتين، وتستهلك INT8 بايتًا واحدًا، أما تكميم INT4 فيستهلك نصف بايت فقط. وأخيرًا حدّد عامل الهامش الإضافي — تُعدّ القيمة 1.2 (أي هامش إضافي بنسبة 20%) خيارًا افتراضيًا معقولًا للاستدلال ضمن سياق قصير، ويُنصح برفعها مع السياقات الطويلة أو معالجة الدفعات (batching).
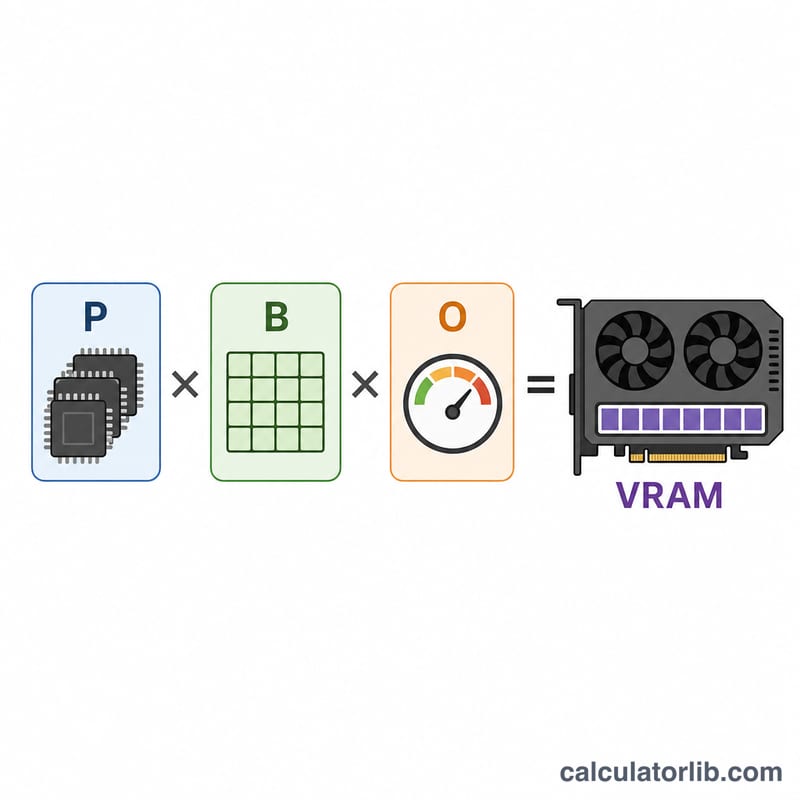
شرح المعادلة
$$\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times \text{Overhead}$$ وبما أن المليار بايت يساوي تقريبًا 1 جيجابايت، فإن ضرب عدد المعاملات بالمليارات في عدد البايتات لكل معامل يعطينا الناتج مباشرةً بالجيجابايت. ثم يأتي عامل الهامش ليضاعف هذه القيمة بما يكفي لتغطية ذاكرة التشغيل الفعلية.
مثال تطبيقي
لنموذج بحجم 7B بدقة FP16 وبعامل هامش 1.2: $$7 \times 2 \times 1.2 = 16.8 \text{ جيجابايت}$$ وهو ما يتسع له بأريحية كرت بسعة 24 جيجابايت. وأما النموذج نفسه بدقة INT4: $$7 \times 0.5 \times 1.2 = 4.2 \text{ جيجابايت}$$ وهو قابل للتشغيل بسهولة على كرت شاشة بسعة 8 جيجابايت.
تقديرات VRAM لأحجام النماذج الشائعة والدقات
يستخدم الجدول صيغة الحاسبة بمعامل الحمل الافتراضي 1.2: \(\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times 1.2\). عدد البايتات لكل معامل هو 2 لـ FP16، و1 لـ INT8، و0.5 لـ INT4. تقارن ملاحظات "يناسب" كل نتيجة بالسعة الاسمية لوحدة معالجة رسومية واحدة، والمقدار القابل للاستخدام فعليًا أقل قليلًا.
| حجم النموذج | FP16 (GB) | INT8 (GB) | INT4 (GB) |
|---|---|---|---|
| 7B | 16.8 | 8.4 | 4.2 |
| 13B | 31.2 | 15.6 | 7.8 |
| 34B | 81.6 | 40.8 | 20.4 |
| 70B | 168 | 84 | 42 |
| 405B | 972 | 486 | 243 |
أي فئة من وحدات معالجة الرسومات تستوعب كل تقدير
- 7B: يحتاج FP16 إلى بطاقة بسعة 24 GB (16.8 GB أكبر من أن تناسب 16 GB). يناسب INT8 سعة 16 GB. ويناسب INT4 سعة 8 GB.
- 13B: يحتاج FP16 إلى 48 GB. يكاد INT8 (15.6 GB) يناسب 16 GB فقط، لذا تكون 24 GB أكثر راحة. أما INT4 (7.8 GB) فهو ضيق جدًا على 8 GB، لذا فإن 16 GB هو الخيار العملي.
- 34B: يتجاوز FP16 (81.6 GB) بطاقة واحدة سعتها 80 GB، لذلك يحتاج إلى عدة وحدات معالجة رسومات. يناسب INT8 سعة 48 GB. ويناسب INT4 سعة 24 GB.
- 70B: يحتاج FP16 (168 GB) إلى ثلاث وحدات معالجة رسومات سعة كل منها 80 GB على الأقل. يتجاوز INT8 (84 GB) بطاقة واحدة بسعة 80 GB، لذلك يحتاج إلى وحدتين، مثل 2×48 GB أو 2×80 GB. ويناسب INT4 (42 GB) سعة 48 GB.
- 405B: تحتاج كل الدقات إلى عدة وحدات معالجة رسومات. يحتاج FP16 إلى ثلاث عشرة بطاقة سعة كل منها 80 GB على الأقل، ويحتاج INT8 إلى سبع بطاقات على الأقل، ويحتاج INT4 إلى أربع بطاقات على الأقل.
عندما يتجاوز التقدير ذاكرة بطاقة واحدة، يجب تقسيم النموذج على عدة وحدات معالجة رسومات (توازي الموترات أو توازي المراحل). عندئذ تصبح سرعة الربط بين الوحدات والنفقات الإضافية لكل وحدة مهمة، لذا اترك هامشًا إضافيًا يتجاوز القسمة البسيطة.
عدد البايتات لكل معامل حسب تنسيق الدقة
| التنسيق | البايتات لكل معامل | الاستخدام النموذجي |
|---|---|---|
| FP32 | 4 | خطوط أساس التدريب والبحث والأعمال الحساسة عدديًا؛ نادرًا ما يُستخدم لتشغيل نماذج اللغة الكبيرة |
| FP16 / BF16 | 2 | الاستدلال القياسي بالجودة الكاملة، وهو تنسيق التخزين المعتاد لنقاط الحفظ المنشورة |
| FP8 / INT8 | 1 | تشغيل فعّال مع فقدان ضئيل للجودة على العتاد والبرمجيات المدعومة |
| INT4 | 0.5 | تكميم مكثف للاستدلال المحلي ووحدات معالجة الرسومات الاستهلاكية، مع بعض فقدان الجودة |
ملاحظة حول تنسيقات 4 بت الفعلية: تخزن الأنظمة العملية ذات 4 بت، مثل GGUF Q4_K_M وGPTQ وAWQ، مقاييس لكل مجموعة وبيانات وصفية أخرى. لذلك تستخدم بايتات أكثر قليلًا من 0.5 لكل وزن، تقريبًا بين 0.55 و0.65. بالنسبة لهذه التنسيقات، ارفع معامل الحمل قليلًا، أو اعتبر نتيجة INT4 تقديرًا أقل من الواقع بقليل.
معاملات الحمل النموذجية حسب حالة الاستخدام
| حالة الاستخدام | معامل الحمل |
|---|---|
| سياق قصير، مستخدم واحد | نحو 1.2 |
| سياق طويل أو تجميع معتدل | نحو 1.5 إلى 2.0 |
| تجميع كثيف أو تشغيل بسياق طويل جدًا | 2.0 أو أكثر |
هذه قواعد إرشادية وليست معايير ثابتة. يحدد محرك الاستدلال لديك وطول السياق ودرجة التزامن القيمة الفعلية.
تفسير تقدير VRAM الخاص بك
النتيجة تقدير تقريبي من نوع الحد الأدنى للاستدلال. تأخذ الذاكرة اللازمة للأوزان وتضيف نسبة مئوية ثابتة لذاكرة KV cache والتفعيلات وسياق CUDA ومخازن الإطار المؤقتة. وهي ليست قياسًا دقيقًا، ولا تغطي التدريب. كما أن التدريب يخزن التدرجات وحالات المحسِّن، والتي قد تحتاج إلى عدة أضعاف من الذاكرة.
كيف تتغير ذاكرة KV cache
تنمو ذاكرة KV cache خطيًا مع طول السياق وحجم الدفعة وعدد الطبقات وعرض الإسقاطات الخاصة بالمفاتيح والقيم:
$$\text{KV cache (bytes)} \approx 2 \times L \times d_{kv} \times T \times B \times b$$
هنا \(L\) هو عدد الطبقات، و\(d_{kv}\) هو عرض المفاتيح/القيم، و\(T\) هو طول السياق بالرموز، و\(B\) هو حجم الدفعة (التسلسلات المتزامنة)، و\(b\) هو عدد البايتات لكل عنصر في الذاكرة المؤقتة. يغطي العامل 2 المفاتيح والقيم. كمثال، يحتاج نموذج ذو انتباه متعدد الرؤوس القياسي، و32 طبقة، وحجم مخفي 4096، وذاكرة KV cache بدقة FP16 عند 4096 رمزًا، إلى \(2 \times 32 \times 4096 \times 4096 \times 2 = 2{,}147{,}483{,}648\) بايت، أي نحو 2.1 GB لكل تسلسل. أما النماذج التي تستخدم انتباه الاستعلام المجمّع (grouped-query attention) فلها \(d_{kv}\) أصغر، وبالتالي ذاكرة cache أصغر بكثير. مع السياقات الطويلة أو عدد كبير من المستخدمين المتزامنين، قد تساوي ذاكرة cache الأوزان أو تتجاوزها، لذا ارفع معامل الحمل في تلك الحالات.
المقارنة مع الذاكرة القابلة للاستخدام
قارن التقدير بالذاكرة القابلة للاستخدام في وحدة معالجة الرسومات، وليس بالرقم الاسمي. يستهلك برنامج التشغيل وسياق CUDA والشاشة (إذا كانت وحدة المعالجة الرسومية تشغّل شاشة أيضًا) جزءًا من الذاكرة، وتحجز محركات الاستدلال عادةً نسبة من الباقي. فالبطاقة المعلنة بسعة 24 GB توفر للنموذج عادةً قدرًا أقل بوضوح. إذا كان تقديرك ضمن بضعة في المئة من سعة البطاقة، فافترض أنه لن يتسع.
وحدات معالجة رسومات متعددة
مع توازي الموترات، تُقسَّم الأوزان وذاكرة KV cache على وحدات المعالجة الرسومية، فتحمل كل بطاقة تقريبًا حصتها من الإجمالي. ومع ذلك، تحمل كل وحدة سياق CUDA ومخازنها المؤقتة الخاصة، وتضيف مخازن الاتصال المزيد، لذا يصبح الإجمالي عبر كل وحدات المعالجة الرسومية أعلى قليلًا من تقدير وحدة واحدة.
نماذج خليط الخبراء
بالنسبة لنماذج خليط الخبراء (MoE)، أدخل إجمالي عدد المعاملات، وليس عدد المعاملات النشطة. لا يعمل إلا بعض الخبراء مع كل رمز، مما يقلل الحوسبة، لكن جميع أوزان الخبراء يجب أن تبقى عادةً في VRAM حتى يتمكن الموجِّه من اختيار أيٍّ منهم.
هذه معلومات عامة لأغراض التخطيط. تحقق من الاستخدام الفعلي باستخدام برمجياتك وأعباء عملك الخاصة.
الأسئلة الشائعة
لماذا يكون الاستهلاك الفعلي أكبر من حجم الأوزان الخام؟ لأن ذاكرة الـ KV cache تتزايد مع طول السياق وحجم الدفعة، كما تحجز أطر العمل ذاكرة إضافية للتنشيطات والمخازن المؤقتة — وهذا تحديدًا ما يقدّره عامل الهامش الإضافي.
هل يشمل هذا التقدير مرحلة التدريب؟ لا. فالتدريب يحتاج إلى ذاكرة أكبر بنحو 3 إلى 4 أضعاف لتخزين حالات المُحسِّن (optimizer) والتدرجات؛ أما هذا التقدير فموجّه لمرحلة الاستدلال.
ما عامل الهامش المناسب؟ استخدم نحو 1.2 للمطالبات القصيرة، و1.5 إلى 2.0 أو أكثر مع السياقات الطويلة أو معالجة الدفعات الثقيلة.