LLM VRAM İhtiyacı Hesaplama Aracı nedir?
Bu araç, bir büyük dil modelini (LLM) çıkarım (inference) için yüklemek ve çalıştırmak amacıyla ne kadar GPU video belleğine (VRAM) ihtiyacınız olduğunu tahmin eder. Gereken bellek miktarını belirleyen başlıca iki etken, modelin parametre sayısı ve her ağırlığın saklandığı sayısal hassasiyettir. Bir güvenlik/ek yük faktörü ise; KV önbelleği, aktivasyonlar ve CUDA bağlamı gibi, ham ağırlıkların ötesinde bellek tüketen unsurları hesaba katar.
Nasıl kullanılır?
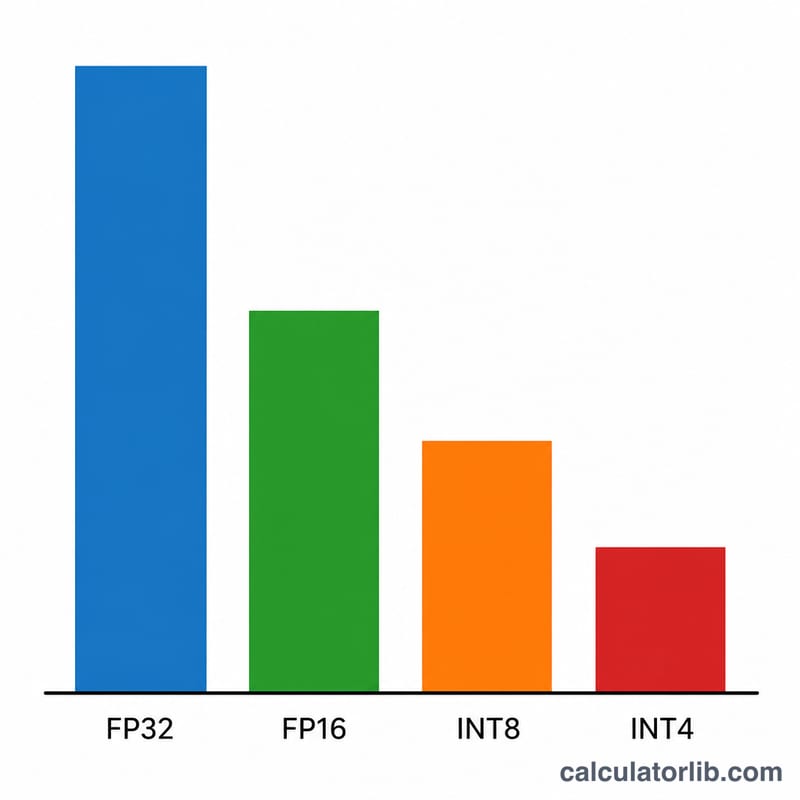
Model boyutunu milyar parametre cinsinden girin (örneğin 7B model için 7, Llama-3 70B için 70). Ardından hassasiyeti seçin: FP32 her ağırlık için 4 bayt, FP16/BF16 2 bayt, INT8 1 bayt ve INT4 nicemlemesi (quantization) 0,5 bayt kullanır. Son olarak ek yük faktörünü belirleyin — kısa bağlamlı çıkarım için 1,2 (yani %20'lik bir tampon) makul bir varsayılan değerdir; uzun bağlamlar veya toplu işlem (batching) için bu değeri artırın.
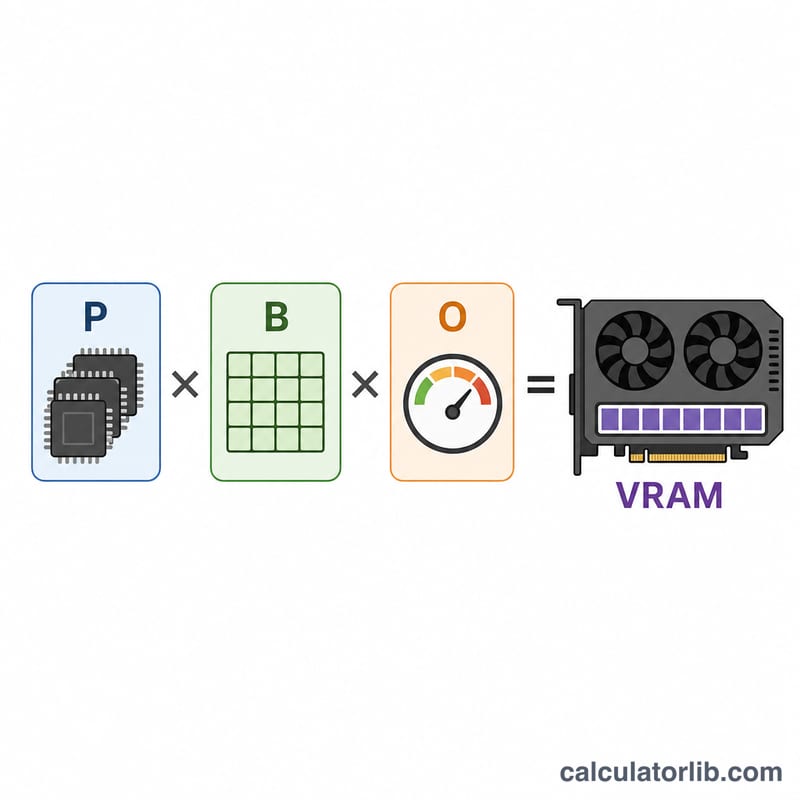
Formülün açıklaması
$$\text{VRAM (GB)} = \text{Parametre (milyar)} \times \text{Parametre başına bayt} \times \text{Ek yük}$$ 1 milyar bayt ≈ 1 GB olduğundan, milyar cinsinden parametre sayısını parametre başına bayt değeriyle çarpmak doğrudan gigabayt sonucunu verir. Ek yük faktörü de bu sonucu, çalışma zamanı belleğini kapsayacak şekilde ölçeklendirir.
Örnek hesaplama
FP16 formatında ve 1,2 ek yük faktörüyle 7B'lik bir model için: $$7 \times 2 \times 1{,}2 = 16{,}8 \text{ GB}$$ Bu değer, 24 GB'lık bir ekran kartına rahatlıkla sığar. Aynı model INT4 ile: $$7 \times 0{,}5 \times 1{,}2 = 4{,}2 \text{ GB}$$ yani 8 GB'lık bir GPU'da kolayca çalışır.
Yaygın Model Boyutları ve Hassasiyetleri için VRAM Tahminleri
Tablo, hesap makinesinin varsayılan 1,2 ek yük katsayısındaki formülünü kullanır: \(\text{VRAM (GB)} = \text{Params (B)} \times \text{Bytes/Param} \times 1.2\). Parametre başına bayt sayısı FP16 için 2, INT8 için 1 ve INT4 için 0,5'tir. "Sığar" notları her sonucu tek bir GPU'nun nominal kapasitesiyle karşılaştırır; gerçekte kullanılabilir bellek biraz daha düşüktür.
| Model boyutu | FP16 (GB) | INT8 (GB) | INT4 (GB) |
|---|---|---|---|
| 7B | 16.8 | 8.4 | 4.2 |
| 13B | 31.2 | 15.6 | 7.8 |
| 34B | 81.6 | 40.8 | 20.4 |
| 70B | 168 | 84 | 42 |
| 405B | 972 | 486 | 243 |
Her tahmini hangi GPU kademesi karşılayabilir
- 7B: FP16 için 24 GB'lık bir kart gerekir (16,8 GB, 16 GB için fazladır). INT8, 16 GB'a sığar. INT4, 8 GB'a sığar.
- 13B: FP16 için 48 GB gerekir. INT8 (15,6 GB) 16 GB'a ancak zar zor sığar, bu yüzden 24 GB daha rahattır. INT4 (7,8 GB) 8 GB'da çok sıkıdır, bu yüzden pratik seçim 16 GB'dır.
- 34B: FP16 (81,6 GB), tek bir 80 GB kartı aşar, bu yüzden birden fazla GPU gerekir. INT8, 48 GB'a sığar. INT4, 24 GB'a sığar.
- 70B: FP16 (168 GB) en az üç adet 80 GB GPU gerektirir. INT8 (84 GB), tek bir 80 GB kartı aştığı için iki GPU gerekir; örneğin 2×48 GB veya 2×80 GB. INT4 (42 GB) 48 GB'a sığar.
- 405B: her hassasiyet birden fazla GPU gerektirir. FP16 en az on üç adet 80 GB kart, INT8 en az yedi, INT4 ise en az dört kart gerektirir.
Tahmin tek bir kartın belleğini aştığında model birden fazla GPU'ya bölünmek zorundadır (tensör veya boru hattı paralelliği). Bu durumda bağlantı hızı ve GPU başına ek yük önem kazanır; bu yüzden basit bölmenin ötesinde biraz ek pay bırakın.
Hassasiyet Formatına Göre Parametre Başına Bayt
| Format | Parametre başına bayt | Tipik kullanım |
|---|---|---|
| FP32 | 4 | Eğitim referansları, araştırma ve sayısal olarak hassas işler; LLM sunumunda nadiren kullanılır |
| FP16 / BF16 | 2 | Standart tam kaliteli çıkarım ve yayımlanan kontrol noktalarının olağan depolama formatı |
| FP8 / INT8 | 1 | Desteklenen donanım ve yazılımda az kalite kaybıyla verimli sunum |
| INT4 | 0,5 | Yerel çıkarım ve tüketici GPU'ları için agresif nicemleme; bazı kalite kaybıyla |
Gerçek 4 bitlik formatlar hakkında not: GGUF Q4_K_M, GPTQ ve AWQ gibi pratik 4 bitlik şemalar grup başına ölçekleri ve diğer meta verileri saklar. Bu nedenle ağırlık başına 0,5 bayttan biraz fazla, yaklaşık 0,55 ile 0,65 bayt kullanırlar. Bu formatlarda ek yük katsayısını biraz artırın ya da INT4 sonucunu hafif bir alt tahmin olarak değerlendirin.
Kullanım durumuna göre tipik ek yük katsayıları
| Kullanım durumu | Ek yük katsayısı |
|---|---|
| Kısa bağlam, tek kullanıcı | yaklaşık 1,2 |
| Uzun bağlam veya orta düzeyde toplu işleme | yaklaşık 1,5 ile 2,0 |
| Yoğun toplu işleme veya çok uzun bağlam sunumu | 2,0 veya daha fazla |
Bunlar sabit standartlar değil, pratik kural niteliğinde yönlendirmelerdir. Çıkarım motorunuz, bağlam uzunluğunuz ve eşzamanlılık gerçek değeri belirler.
VRAM Tahmininizi Yorumlamak
Sonuç, çıkarım için yaklaşık, alt sınır niteliğinde bir tahmindir. Ağırlıkların belleğini alır ve KV önbelleği, aktivasyonlar, CUDA bağlamı ve çerçeve tamponları için sabit bir yüzde ekler. Kesin bir ölçüm değildir ve eğitimi kapsamaz. Eğitim ayrıca gradyanları ve optimizasyon durumlarını saklar; bu da birkaç kat daha fazla bellek gerektirebilir.
KV önbelleği nasıl ölçeklenir
KV önbelleği; bağlam uzunluğu, toplu iş boyutu, katman sayısı ve anahtar/değer projeksiyonlarının gizli boyutu ile doğrusal olarak büyür:
$$\text{KV cache (bytes)} \approx 2 \times L \times d_{kv} \times T \times B \times b$$
Burada \(L\) katman sayısı, \(d_{kv}\) anahtar/değer genişliği, \(T\) token cinsinden bağlam uzunluğu, \(B\) toplu iş boyutu (eşzamanlı diziler) ve \(b\) önbellek öğesi başına bayt sayısıdır. 2 çarpanı anahtarları ve değerleri kapsar. Örnek olarak, standart çok başlıklı dikkat kullanan, 32 katmanlı, gizli boyutu 4096 olan ve 4096 token'da FP16 önbellek kullanan bir model \(2 \times 32 \times 4096 \times 4096 \times 2 = 2{,}147{,}483{,}648\) bayt, yani dizi başına yaklaşık 2,1 GB gerektirir. Gruplandırılmış sorgu dikkati kullanan modellerin \(d_{kv}\) değeri daha küçüktür ve dolayısıyla önbellekleri çok daha küçüktür. Uzun bağlamlar veya çok sayıda eşzamanlı kullanıcıda önbellek ağırlıklara yetişebilir veya onları aşabilir; bu durumlarda ek yük katsayısını artırın.
Kullanılabilir bellekle karşılaştırın
Tahmini, nominal değer yerine GPU'nun kullanılabilir belleğiyle karşılaştırın. Sürücü, CUDA bağlamı ve ekran (GPU bir monitörü de sürüyorsa) bir miktar bellek kullanır; çıkarım motorları da kalanın bir kısmını genellikle ayırır. 24 GB olarak satılan bir kart, modele genellikle belirgin biçimde daha az yer açar. Tahmininiz kart boyutuna birkaç yüzde kadar yakınsa, sığmayacağını varsayın.
Birden fazla GPU
Tensör paralelliğinde ağırlıklar ve KV önbelleği GPU'lar arasında bölünür, bu nedenle her kart toplamın kabaca kendi payını taşır. Yine de her GPU kendi CUDA bağlamını ve tamponlarını taşır, iletişim tamponları da ek yük getirir; bu yüzden tüm GPU'lar üzerindeki toplam, tek GPU tahmininden biraz daha yüksek çıkar.
Karma uzman (Mixture-of-Experts) modelleri
Karma uzman (MoE) modelleri için aktif parametre sayısı yerine toplam parametre sayısını girin. Her token için yalnızca bazı uzmanlar çalışır, bu da hesaplamayı azaltır; ancak yönlendiricinin bunlardan herhangi birini seçebilmesi için tüm uzman ağırlıklarının normalde VRAM'de kalması gerekir.
Bu, planlama amaçlı genel bilgidir. Gerçek kullanımı kendi yazılımınız ve iş yükünüzle kontrol edin.
Sıkça Sorulan Sorular
Gerçek kullanım neden ham ağırlıklardan daha yüksek? KV önbelleği, bağlam uzunluğu ve toplu işlem boyutuyla birlikte büyür; ayrıca çerçeve (framework), aktivasyonlar ve tamponlar için bellek ayırır. İşte ek yük faktörü tam olarak bunu yaklaşık olarak hesaplar.
Bu hesaplama eğitimi (training) de kapsıyor mu? Hayır. Eğitim; optimizer durumları ve gradyanlar için kabaca 3–4 kat daha fazla bellek gerektirir. Bu tahmin yalnızca çıkarımı (inference) hedefler.
Hangi ek yük değerini kullanmalıyım? Kısa istemler (prompt) için yaklaşık 1,2; uzun bağlamlar veya yoğun toplu işlem için 1,5–2,0 ve üzeri değerler kullanın.