Qu'est-ce que le calculateur de VRAM pour LLM ?
Cet outil estime la quantité de mémoire vidéo GPU (VRAM) nécessaire pour charger et faire tourner un grand modèle de langage (LLM) en inférence. Cette mémoire dépend avant tout du nombre de paramètres du modèle et de la précision numérique utilisée pour stocker chaque poids. Un facteur de surcharge (marge de sécurité) prend en compte le cache KV, les activations et le contexte CUDA, qui consomment de la mémoire en plus des poids bruts.
Comment l'utiliser
Indiquez la taille du modèle en milliards de paramètres (par exemple 7 pour un modèle 7B, ou 70 pour Llama-3 70B). Choisissez la précision : le FP32 utilise 4 octets par poids, le FP16/BF16 en utilise 2, l'INT8 en utilise 1 et la quantification INT4 n'en utilise que 0,5. Réglez enfin le facteur de surcharge : 1,2 (soit une marge de 20 %) constitue une valeur par défaut raisonnable pour de l'inférence en contexte court ; augmentez-le pour les contextes longs ou le traitement par lots (batching).
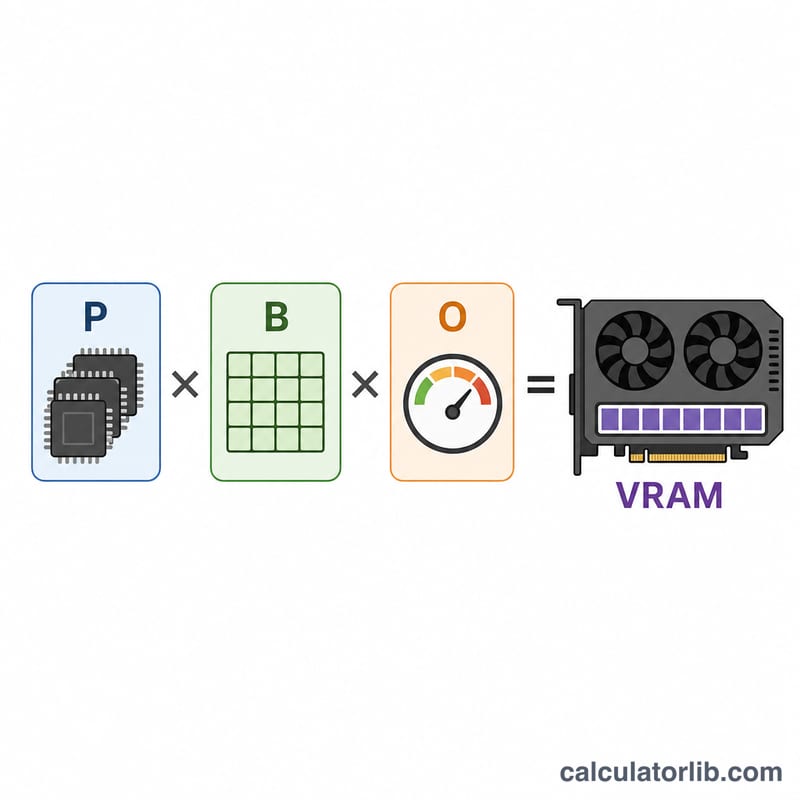
La formule expliquée
$$\text{VRAM (Go)} = \text{Paramètres (milliards)} \times \text{Octets par paramètre} \times \text{Surcharge}$$ Comme 1 milliard d'octets ≈ 1 Go, multiplier le nombre de paramètres exprimé en milliards par le nombre d'octets par paramètre donne directement un résultat en gigaoctets. Le facteur de surcharge vient ensuite majorer ce total pour couvrir la mémoire utilisée à l'exécution.
Exemple concret
Pour un modèle 7B en FP16 avec un facteur de surcharge de 1,2 : $$7 \times 2 \times 1{,}2 = 16{,}8 \text{ Go}$$ Cela tient confortablement sur une carte de 24 Go. Le même modèle en INT4 : $$7 \times 0{,}5 \times 1{,}2 = 4{,}2 \text{ Go}$$ qui tourne sans problème sur un GPU de 8 Go.
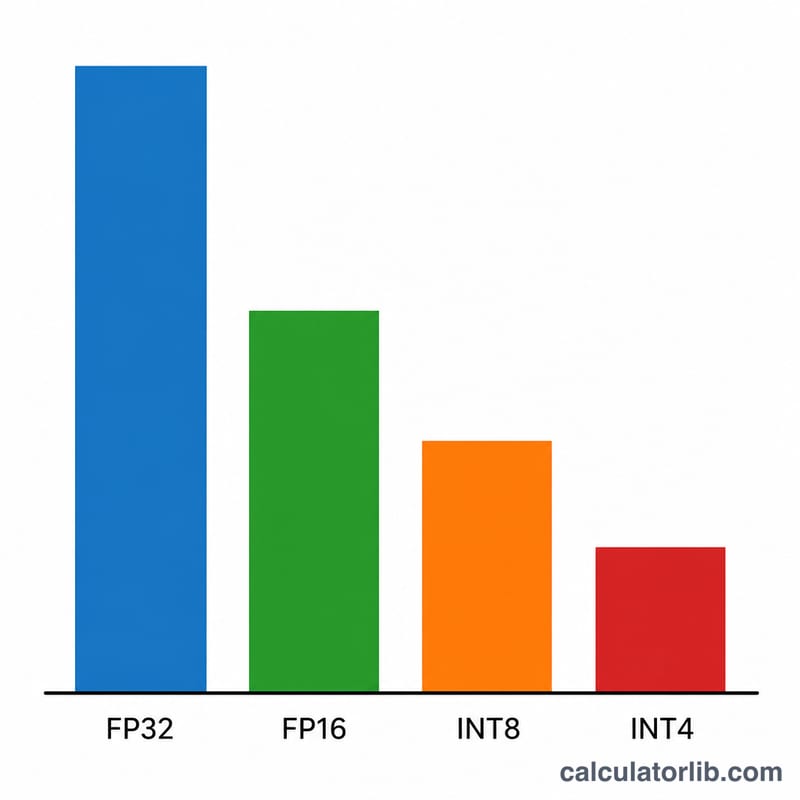
Estimations de VRAM pour les tailles de modèles et précisions courantes
Le tableau utilise la formule du calculateur avec le coefficient de surcharge par défaut de 1,2 : \(\text{VRAM (Go)} = \text{Paramètres (B)} \times \text{Octets/Paramètre} \times 1{,}2\). Le nombre d'octets par paramètre est de 2 pour FP16, 1 pour INT8 et 0,5 pour INT4. Les notes « Convient pour » comparent chaque résultat à la capacité nominale d'un seul GPU, et la quantité réellement utilisable est un peu plus faible.
| Taille du modèle | FP16 (Go) | INT8 (Go) | INT4 (Go) |
|---|---|---|---|
| 7B | 16,8 | 8,4 | 4,2 |
| 13B | 31,2 | 15,6 | 7,8 |
| 34B | 81,6 | 40,8 | 20,4 |
| 70B | 168 | 84 | 42 |
| 405B | 972 | 486 | 243 |
Quel niveau de GPU peut accueillir chaque estimation
- 7B : FP16 nécessite une carte de 24 Go (16,8 Go est trop pour 16 Go). INT8 tient dans 16 Go. INT4 tient dans 8 Go.
- 13B : FP16 nécessite 48 Go. INT8 (15,6 Go) tient tout juste dans 16 Go, donc 24 Go est plus confortable. INT4 (7,8 Go) est très serré sur 8 Go, donc 16 Go est le choix pratique.
- 34B : FP16 (81,6 Go) dépasse une carte unique de 80 Go, il faut donc plusieurs GPU. INT8 tient dans 48 Go. INT4 tient dans 24 Go.
- 70B : FP16 (168 Go) nécessite au moins trois GPU de 80 Go. INT8 (84 Go) dépasse une carte de 80 Go, il faut donc deux GPU, par exemple 2×48 Go ou 2×80 Go. INT4 (42 Go) tient dans 48 Go.
- 405B : toutes les précisions nécessitent plusieurs GPU. FP16 nécessite au moins treize cartes de 80 Go, INT8 au moins sept, et INT4 au moins quatre.
Lorsque l'estimation dépasse la mémoire d'une seule carte, le modèle doit être réparti sur plusieurs GPU (parallélisme de tenseurs ou de pipeline). La vitesse d'interconnexion et la surcharge par GPU entrent alors en jeu, il faut donc prévoir une marge supplémentaire au-delà de la simple division.
Octets par paramètre selon le format de précision
| Format | Octets par paramètre | Utilisation typique |
|---|---|---|
| FP32 | 4 | Références d'entraînement, recherche et travaux sensibles à la précision numérique ; rarement utilisé pour servir des LLM |
| FP16 / BF16 | 2 | Inférence standard en pleine qualité et format de stockage habituel des points de contrôle publiés |
| FP8 / INT8 | 1 | Service efficace avec peu de perte de qualité sur le matériel et les logiciels compatibles |
| INT4 | 0,5 | Quantification agressive pour l'inférence locale et les GPU grand public, avec une certaine perte de qualité |
Remarque sur les formats 4 bits réels : les schémas 4 bits pratiques comme GGUF Q4_K_M, GPTQ et AWQ stockent des échelles par groupe et d'autres métadonnées. Ils utilisent donc un peu plus de 0,5 octet par poids, environ 0,55 à 0,65. Pour ces formats, augmentez légèrement le coefficient de surcharge ou considérez le résultat INT4 comme une légère sous-estimation.
Coefficients de surcharge typiques selon le cas d'usage
| Cas d'usage | Coefficient de surcharge |
|---|---|
| Contexte court, utilisateur unique | environ 1,2 |
| Contexte long ou regroupement modéré de requêtes | environ 1,5 à 2,0 |
| Regroupement intensif ou service à contexte très long | 2,0 ou plus |
Il s'agit de règles empiriques, et non de normes fixes. Votre moteur d'inférence, la longueur du contexte et la concurrence déterminent la valeur réelle.
Interpréter votre estimation de VRAM
Le résultat est une estimation approximative de type borne inférieure pour l'inférence. Elle prend la mémoire des poids et ajoute un pourcentage forfaitaire pour le cache KV, les activations, le contexte CUDA et les tampons du framework. Ce n'est pas une mesure exacte, et elle ne couvre pas l'entraînement. L'entraînement stocke aussi les gradients et les états de l'optimiseur, qui peuvent nécessiter plusieurs fois plus de mémoire.
Évolution du cache KV
Le cache KV croît linéairement avec la longueur du contexte, la taille du lot, le nombre de couches et la taille cachée des projections clé/valeur :
$$\text{Cache KV (octets)} \approx 2 \times L \times d_{kv} \times T \times B \times b$$
Ici \(L\) est le nombre de couches, \(d_{kv}\) est la largeur clé/valeur, \(T\) est la longueur du contexte en jetons, \(B\) est la taille du lot (séquences simultanées) et \(b\) est le nombre d'octets par élément du cache. Le facteur 2 couvre les clés et les valeurs. Par exemple, un modèle à attention multi-têtes standard, avec 32 couches, une taille cachée de 4096 et un cache FP16 pour 4096 jetons, nécessite \(2 \times 32 \times 4096 \times 4096 \times 2 = 2{,}147{,}483{,}648\) octets, soit environ 2,1 Go par séquence. Les modèles qui utilisent l'attention à requêtes groupées ont un \(d_{kv}\) plus petit et donc un cache beaucoup plus réduit. Avec des contextes longs ou de nombreux utilisateurs simultanés, le cache peut égaler ou dépasser les poids, il faut donc augmenter le coefficient de surcharge dans ces cas.
Comparer à la mémoire utilisable
Comparez l'estimation à la mémoire utilisable du GPU, et non à la valeur nominale. Le pilote, le contexte CUDA et l'affichage (si le GPU alimente aussi un moniteur) occupent de la mémoire, et les moteurs d'inférence réservent généralement une fraction du reste. Une carte vendue comme 24 Go offre typiquement nettement moins pour le modèle. Si votre estimation se situe à quelques pour cent près de la taille de la carte, considérez qu'elle ne tiendra pas.
Plusieurs GPU
Avec le parallélisme de tenseurs, les poids et le cache KV sont répartis entre les GPU, si bien que chaque carte contient à peu près sa part du total. Chaque GPU conserve tout de même son propre contexte CUDA et ses tampons, et les tampons de communication en ajoutent, si bien que le total sur l'ensemble des GPU est un peu plus élevé que l'estimation pour un seul GPU.
Modèles à mélange d'experts
Pour les modèles à mélange d'experts (MoE), saisissez le nombre total de paramètres, et non le nombre actif. Seuls certains experts s'exécutent pour chaque jeton, ce qui réduit le calcul, mais tous les poids des experts doivent normalement rester résidents dans la VRAM afin que le routeur puisse en choisir n'importe lequel.
Ces informations sont générales et destinées à la planification. Vérifiez l'utilisation réelle avec vos propres logiciels et votre charge de travail.
FAQ
Pourquoi l'utilisation réelle dépasse-t-elle la taille des poids bruts ? Le cache KV grandit avec la longueur du contexte et la taille du lot, et le framework réserve de la mémoire pour les activations et les tampons : c'est précisément ce que le facteur de surcharge cherche à approximer.
Cela inclut-il l'entraînement ? Non. L'entraînement nécessite environ 3 à 4 fois plus de mémoire pour les états de l'optimiseur et les gradients ; cette estimation concerne uniquement l'inférence.
Quel facteur de surcharge utiliser ? Comptez environ 1,2 pour des prompts courts, et 1,5 à 2,0 (voire plus) pour les contextes longs ou un batching important.