Qu'est-ce que le calculateur de tokens en mots et coût ?
Les grands modèles de langage (LLM) comme GPT, Claude ou Gemini traitent le texte sous forme de tokens plutôt que de mots. Un token est un fragment de texte — souvent un morceau de mot d'environ quatre caractères. Ce calculateur estime le nombre de mots que représente un certain nombre de tokens, ainsi que le coût de ces tokens à partir du prix d'un modèle par million (1M) de tokens.
Comment l'utiliser
Indiquez le nombre de tokens, le ratio mots par token (0,75 est une bonne valeur par défaut pour un texte en anglais) et, si vous le souhaitez, le prix facturé par votre fournisseur pour 1M de tokens (laissez le champ vide pour ne compter que les mots). L'outil affiche immédiatement le nombre de mots estimé et, si vous avez saisi un prix, le coût en dollars.
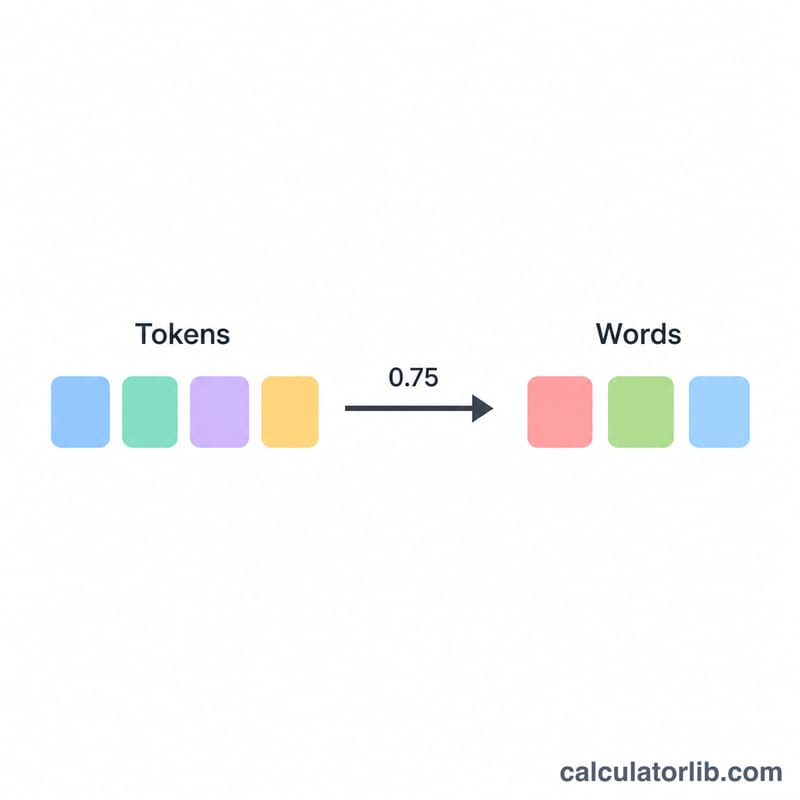
La formule expliquée
L'estimation du nombre de mots repose sur $$\text{mots} \approx \text{tokens} \times 0{,}75$$, ce qui reprend la règle empirique d'OpenAI pour l'anglais : 1 token ≈ 4 caractères ≈ 0,75 mot. Le coût se calcule par $$\text{coût} = \frac{\text{tokens}}{1\,000\,000} \times \text{prix pour 1M}$$, puisque la plupart des fournisseurs affichent leurs prix par million de tokens. Ajustez le ratio pour d'autres langues ou pour du code, qui ont tendance à consommer davantage de tokens par mot. À noter : le français produit généralement un peu plus de tokens que l'anglais, vous pouvez donc abaisser légèrement le ratio.
Exemple concret
Imaginons que vous ayez 1 000 tokens avec un ratio de 0,75 et un prix de 2 USD pour 1M de tokens. $$\text{Mots} = 1\,000 \times 0{,}75 = \textbf{750 mots}$$ $$\text{Coût} = \frac{1\,000}{1\,000\,000} \times 2 = \textbf{0,002 USD}$$
FAQ
Quelle est la fiabilité de l'estimation du nombre de mots ? Il s'agit d'une approximation. La tokenisation réelle varie selon le modèle et le contenu ; 0,75 mot par token reste une moyenne fiable pour l'anglais.
Les tokens d'entrée et de sortie coûtent-ils le même prix ? Non — de nombreux fournisseurs appliquent des tarifs différents. Lancez le calcul deux fois, avec chaque tarif, puis additionnez les résultats.
Pourquoi le code ou les textes non anglophones diffèrent-ils ? Ils contiennent souvent davantage de tokens par mot ; abaissez donc le ratio (par exemple 0,5) pour obtenir une meilleure estimation.