À quoi sert ce calculateur
Il transforme une charge de travail (tokens par requête et requêtes par mois) en facture mensuelle d'API, à partir des tarifs publics actuels des principaux fournisseurs de grands modèles de langage : Anthropic (Claude), OpenAI (GPT), Google (Gemini), Mistral et DeepSeek. Choisissez un modèle pour obtenir le détail ; le tableau sous le résultat chiffre la même charge sur tous les modèles de la liste, du moins cher au plus cher.
Mode d'emploi
- Choisissez un modèle.
- Saisissez les tokens d'entrée (prompt, prompt système, documents, définitions d'outils) et les tokens de sortie (la réponse) d'une requête type. Les réponses de l'API indiquent les deux.
- Saisissez le nombre de requêtes par mois.
- Si besoin, indiquez la part de l'entrée mise en cache, cochez Batch API pour les traitements asynchrones ou saisissez un prix personnalisé pour 1M de tokens pour un tarif négocié ou un modèle absent de la liste.
La formule
Les fournisseurs facturent les tokens d'entrée (ce que vous envoyez) et les tokens de sortie (ce que le modèle rédige) à des tarifs distincts, exprimés par million de tokens. L'entrée en cache, c'est-à-dire un préfixe de prompt déjà stocké par le fournisseur, est facturée à un tarif bien plus bas. Pour une requête :
$$\text{Cost} = \frac{(1-c)\,T_{in}\,P_{in} + c\,T_{in}\,P_{cache} + T_{out}\,P_{out} }{1\,000\,000}$$où \(T_{in}\) et \(T_{out}\) sont les tokens d'entrée et de sortie par requête, \(c\) la part de l'entrée servie depuis le cache et \(P\) les prix pour 1M de tokens. Le coût mensuel est le coût d'une requête multiplié par le nombre de requêtes par mois. L'option Batch API remplace \(P_{in}\) et \(P_{out}\) par les prix batch du fournisseur.
Exemple chiffré
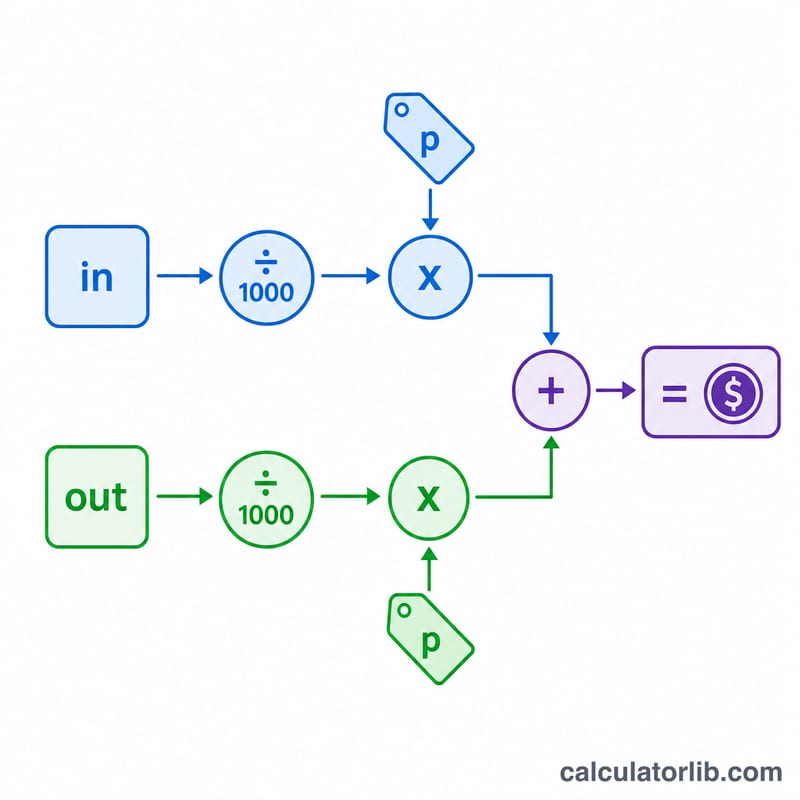
Un bot d'assistance envoie 2 000 tokens d'entrée et reçoit 500 tokens de sortie par requête, 10 000 fois par mois, sur un modèle facturé 2 USD pour 1M de tokens d'entrée et 10 USD pour 1M de tokens de sortie :
- Entrée : 2 000 × 2 ÷ 1 000 000 = 0,004 USD
- Sortie : 500 × 10 ÷ 1 000 000 = 0,005 USD
- Par requête : 0,009 USD ; par mois : 0,009 × 10 000 = 90 USD
La sortie ne représente que 20 % des tokens, mais 56 % de la facture : raccourcir les réponses longues fait généralement plus économiser que raccourcir les prompts. Si la moitié de l'entrée était un prompt système en cache facturé 0,10 USD pour 1M, la part de l'entrée passerait de 40 USD à 21 USD par mois.
Ce qui fait varier la facture
- Longueur de la sortie. Sur tous les modèles de la liste, les tokens de sortie coûtent plusieurs fois plus cher que les tokens d'entrée.
- Mise en cache des prompts. Un prompt système ou un document long et répété peut être lu depuis le cache pour une fraction du prix de l'entrée. Chez certains fournisseurs, l'écriture dans le cache est facturée en plus, ce que ce calculateur n'ajoute pas.
- Traitement par lots. Les traitements par lots asynchrones coûtent environ moitié moins cher chez les fournisseurs qui les proposent.
- Prompts longs. Certains modèles facturent plus cher au-delà d'un certain seuil de taille de prompt (par exemple 100 000 ou 200 000 tokens) ; le calculateur choisit la bonne tranche d'après vos tokens d'entrée.
- Tokens de raisonnement. Les modèles qui « réfléchissent » avant de répondre facturent ces tokens cachés comme de la sortie ; la page tarifaire de Google le précise explicitement. Mesurez-les dans vos propres logs.
- Les tokenizers diffèrent. Un même texte ne donne pas le même nombre de tokens selon le modèle : Anthropic indique que ses modèles les plus récents produisent environ 30 % de tokens en plus pour un même texte. Comparez les modèles sur des nombres de tokens mesurés avec chacun d'eux.
D'où viennent les prix
Les prix proviennent de la liste ouverte des prix de modèles de LiteLLM (model_prices_and_context_window.json, licence MIT), figée sur un commit daté, et chaque modèle est vérifié à la main par rapport à la page tarifaire du fournisseur ; la date de vérification et les liens vers les deux sources figurent sous le résultat. En cas d'écart, le calculateur retient la page du fournisseur. Les prix absents de LiteLLM, comme les changements futurs déjà annoncés (par exemple les nouveaux prix de Gemini chez Google à partir du 1er décembre 2026) et les tarifs heures creuses de DeepSeek, proviennent de la page du fournisseur et s'appliquent automatiquement à leur date. La liste est actualisée chaque semaine, et toute forte variation de prix est mise en attente jusqu'à une vérification humaine avant sa mise en ligne. Il s'agit des tarifs publics du niveau standard (paiement à l'usage) en dollars américains, hors taxes ; les remises entreprise, les surcoûts des endpoints régionaux et les niveaux prioritaires ne sont pas inclus. Si un prix diffère de celui affiché aujourd'hui sur la page du fournisseur, utilisez les champs de prix personnalisé et signalez-le-nous.
Questions fréquentes
- Le modèle le moins cher est-il le meilleur choix ?
- Non. Le prix par token n'est qu'un critère : la qualité, la vitesse, la longueur de contexte et le nombre de tokens dont un modèle a besoin pour une même tâche modifient tous le coût réel par tâche accomplie. Servez-vous de la comparaison pour présélectionner, puis testez.
- Pourquoi ma facture diffère-t-elle de l'estimation ?
- La facture compte chaque token réellement traité : nouvelles tentatives, définitions d'outils, prompts système, tokens de raisonnement et écritures dans le cache. Les taxes et les surcoûts régionaux s'appliquent également. Pour l'estimation la plus juste, partez des nombres de tokens indiqués dans les réponses de votre API.
- Comment convertir un prix pour 1K tokens ?
- Multipliez par 1 000 : 0,002 USD pour 1K tokens équivaut à 2 USD pour 1M de tokens.