Công cụ này làm gì
Công cụ chuyển một khối lượng công việc — số token mỗi yêu cầu và số yêu cầu mỗi tháng — thành hóa đơn API hằng tháng, dựa trên giá niêm yết hiện hành của các nhà cung cấp mô hình ngôn ngữ lớn chính: Anthropic (Claude), OpenAI (GPT), Google (Gemini), Mistral và DeepSeek. Chọn một mô hình để xem chi tiết; bảng bên dưới kết quả tính giá cùng khối lượng đó trên mọi mô hình trong danh sách, xếp từ rẻ nhất.
Cách sử dụng
- Chọn mô hình.
- Nhập số token đầu vào (prompt, system prompt, tài liệu, định nghĩa công cụ) và số token đầu ra (câu trả lời) của một yêu cầu điển hình. Phản hồi API của bạn đều báo cả hai con số này.
- Nhập số yêu cầu mỗi tháng.
- Nếu muốn, hãy nhập tỷ lệ đầu vào được lưu bộ nhớ đệm, đánh dấu Batch API cho tác vụ bất đồng bộ, hoặc nhập giá tùy chỉnh cho mỗi 1M token nếu bạn có mức giá thương lượng riêng hay dùng mô hình không có trong danh sách.
Công thức
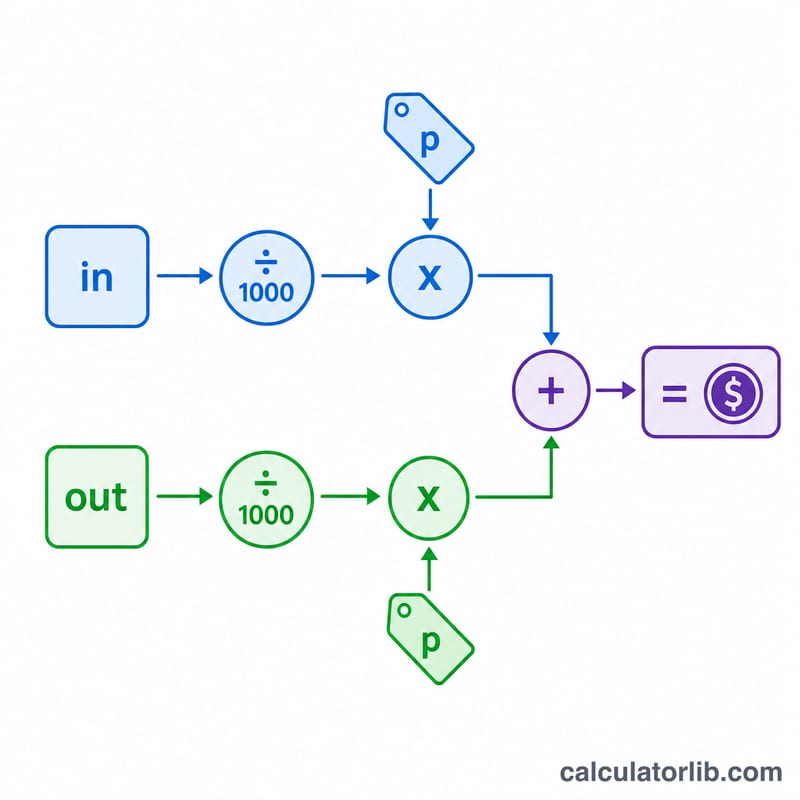
Nhà cung cấp tính token đầu vào (những gì bạn gửi) và token đầu ra (những gì mô hình viết) theo hai mức giá riêng, niêm yết cho mỗi triệu token. Đầu vào lưu bộ nhớ đệm — phần đầu prompt mà nhà cung cấp đã lưu sẵn — được tính giá thấp hơn nhiều. Với một yêu cầu:
$$\text{Cost} = \frac{(1-c)\,T_{in}\,P_{in} + c\,T_{in}\,P_{cache} + T_{out}\,P_{out} }{1\,000\,000}$$trong đó \(T_{in}\) và \(T_{out}\) là số token đầu vào và đầu ra mỗi yêu cầu, \(c\) là tỷ lệ đầu vào được lấy từ bộ nhớ đệm, còn \(P\) là giá cho mỗi 1M token. Chi phí hằng tháng bằng chi phí một yêu cầu nhân với số yêu cầu mỗi tháng. Tùy chọn Batch API thay \(P_{in}\) và \(P_{out}\) bằng giá batch của nhà cung cấp.
Ví dụ minh họa
Một chatbot hỗ trợ gửi 2.000 token đầu vào và nhận 500 token đầu ra mỗi yêu cầu, 10.000 lần mỗi tháng, trên một mô hình có giá 2 USD cho mỗi 1M token đầu vào và 10 USD cho mỗi 1M token đầu ra:
- Đầu vào: 2.000 × 2 ÷ 1.000.000 = 0,004 USD
- Đầu ra: 500 × 10 ÷ 1.000.000 = 0,005 USD
- Mỗi yêu cầu: 0,009 USD; mỗi tháng: 0,009 × 10.000 = 90 USD
Đầu ra chỉ chiếm 20% số token nhưng tới 56% hóa đơn — rút ngắn câu trả lời dài thường tiết kiệm hơn rút gọn prompt. Nếu một nửa đầu vào là system prompt lưu bộ nhớ đệm với giá 0,10 USD cho mỗi 1M token, phần đầu vào sẽ giảm từ 40 USD xuống 21 USD mỗi tháng.
Điều gì làm hóa đơn thay đổi
- Độ dài đầu ra. Trên mọi mô hình trong danh sách, token đầu ra đắt gấp nhiều lần token đầu vào.
- Lưu prompt vào bộ nhớ đệm. Một system prompt hay tài liệu dài, lặp lại nhiều lần có thể được đọc từ bộ nhớ đệm với giá chỉ bằng một phần nhỏ giá đầu vào. Một số nhà cung cấp tính thêm phí ghi vào bộ nhớ đệm; công cụ này không cộng khoản đó.
- Xử lý theo lô. Tác vụ batch bất đồng bộ rẻ khoảng một nửa ở những nhà cung cấp có hỗ trợ.
- Prompt dài. Một số mô hình tính giá cao hơn khi prompt vượt một ngưỡng kích thước (ví dụ 100.000 hoặc 200.000 token); công cụ tự chọn đúng bậc giá theo số token đầu vào của bạn.
- Token suy luận. Các mô hình “suy nghĩ” trước khi trả lời tính các token ẩn đó như token đầu ra; trang bảng giá của Google ghi rõ điều này. Hãy đo chúng trong log của chính bạn.
- Bộ tách token khác nhau. Cùng một đoạn văn bản có thể ra số token khác nhau trên các mô hình khác nhau — Anthropic cho biết các mô hình mới hơn của họ tạo ra nhiều hơn khoảng 30% token cho cùng một văn bản. Hãy so sánh các mô hình dựa trên số token đo bằng chính từng mô hình.
Giá lấy từ đâu
Giá được lấy từ danh sách giá mô hình mở của LiteLLM (model_prices_and_context_window.json, giấy phép MIT), cố định theo một commit có ghi ngày, và từng mô hình đều được đối chiếu thủ công với trang bảng giá chính thức của nhà cung cấp; ngày kiểm tra và liên kết đến cả hai nguồn được in dưới kết quả. Khi hai nguồn không khớp, công cụ dùng giá trên trang của nhà cung cấp. Những mức giá LiteLLM không có — các thay đổi đã công bố cho thời gian tới, như giá Gemini mới của Google từ ngày 1/12/2026, và giá giờ thấp điểm của DeepSeek — được lấy từ trang của nhà cung cấp và tự động chuyển sang đúng ngày hiệu lực. Danh sách được làm mới hằng tuần, và mọi thay đổi giá lớn đều được giữ lại để người kiểm tra trước khi áp dụng. Đây là giá niêm yết của bậc tiêu chuẩn (trả theo mức dùng) tính bằng đô la Mỹ, chưa gồm thuế; không bao gồm chiết khấu doanh nghiệp, phụ phí endpoint theo khu vực và các bậc ưu tiên. Nếu thấy giá khác với trang của nhà cung cấp hôm nay, hãy dùng các ô giá tùy chỉnh và báo cho chúng tôi.
Câu hỏi thường gặp
- Mô hình rẻ nhất có phải là lựa chọn tốt nhất?
- Không. Giá mỗi token chỉ là một yếu tố; chất lượng, tốc độ, độ dài ngữ cảnh và số token mô hình cần cho cùng một việc đều làm thay đổi chi phí thực tế cho mỗi việc hoàn thành. Hãy dùng bảng so sánh để lọc danh sách ngắn, rồi thử nghiệm.
- Vì sao hóa đơn của tôi khác với ước tính?
- Hóa đơn tính mọi token thực sự được xử lý: các lần gọi lại, định nghĩa công cụ, system prompt, token suy luận và lượt ghi vào bộ nhớ đệm. Ngoài ra còn có thuế và phụ phí theo khu vực. Để ước tính chính xác nhất, hãy bắt đầu từ số token mà phản hồi API của bạn báo về.
- Làm sao quy đổi giá cho mỗi 1K token?
- Nhân với 1.000: 0,002 USD cho mỗi 1K token tương đương 2 USD cho mỗi 1M token.