

Công cụ này trả lời câu hỏi gì
Nên thuê GPU để tự chạy một mô hình mở, hay trả tiền API theo từng token? Câu trả lời phụ thuộc vào ba con số: GPU của bạn thực sự tạo ra bao nhiêu token mỗi giây, bạn giữ chúng bận rộn đến mức nào, và mỗi tháng bạn cần bao nhiêu token. Công cụ ước tính con số đầu tiên từ datasheet của GPU và cấu trúc của mô hình, quy ra chi phí cho mỗi 1 triệu token, rồi so sánh với giá API ở cùng tỷ lệ token prompt và token đầu ra.
Thông lượng được ước tính thế nào
Để sinh một token cho mọi chuỗi trong batch (một bước decode), GPU phải đọc toàn bộ trọng số mô hình từ bộ nhớ một lần, cộng với KV cache (key/value) của từng chuỗi. Bước đó cũng tốn khoảng \( 2N \) phép tính dấu phẩy động cho mỗi token với mô hình có \( N \) tham số, cộng một phần attention tăng theo độ dài ngữ cảnh (Kaplan và cộng sự, 2020, phương trình 2.2). Theo mô hình roofline của Williams, Waterman và Patterson, thời gian một bước bằng giới hạn chậm hơn trong hai giới hạn:
$$ t_{\text{step}} = \max\left( \frac{N b + B \bar{S} k}{\eta \, G \, BW},\; \frac{B \, (2N + 2 \, n_{\text{layer}} \bar{S} d)}{m \, G \, F} \right) $$Trong đó \( b \) là số byte mỗi trọng số, \( B \) là số chuỗi chạy đồng thời, \( \bar{S} \) là độ dài ngữ cảnh trung bình khi decode (prompt cộng một nửa phần đầu ra), \( k \) là số byte KV cache mỗi token, \( G \) là số GPU, \( BW \) là băng thông bộ nhớ, \( F \) là TFLOPS dense đỉnh ở độ chính xác đang dùng, \( \eta \) là hiệu suất băng thông và \( m \) là hiệu suất tính toán (MFU). KV cache mỗi token là \( k = 2 \, n_{\text{layer}} \, n_{\text{kv}} \, (d / n_{\text{head}}) \, b_{\text{kv}} \).
Phần prompt được xử lý trước và song song (prefill), nên thường bị giới hạn bởi năng lực tính toán. Giống Pope và cộng sự (2022), một batch mất thời gian prefill cộng với một bước decode cho mỗi token đầu ra; số token đầu ra mỗi giây bằng \( B \) nhân số token đầu ra mỗi yêu cầu, chia cho thời gian của batch.
Ở batch nhỏ, phần bộ nhớ chiếm ưu thế và tốc độ mỗi người dùng xấp xỉ băng thông chia cho kích thước mô hình. Batch lớn hơn chia sẻ mỗi lần đọc trọng số cho nhiều chuỗi hơn, nên tổng thông lượng tăng cho tới khi KV cache hoặc năng lực tính toán trở thành giới hạn.
Từ token mỗi giây đến chi phí mỗi 1 triệu token
$$ \text{Chi phí mỗi 1 triệu token} = \frac{p_{\text{GPU}} \times G}{\text{token/giây} \times 3600 \times u} \times 10^{6} $$\( p_{\text{GPU}} \) là giá mỗi GPU-giờ, \( u \) là mức sử dụng trung bình: tỷ lệ số giờ bạn trả tiền mà GPU thực sự phục vụ ở tốc độ đã mô hình hóa. Một cụm chỉ bận một nửa thời gian sẽ trả gấp đôi cho mỗi token. Phía API lấy giá đầu vào và đầu ra, có trọng số theo số token prompt và đầu ra mỗi yêu cầu, để hai bên được tính trên cùng một lượng token.
Khối lượng hòa vốn
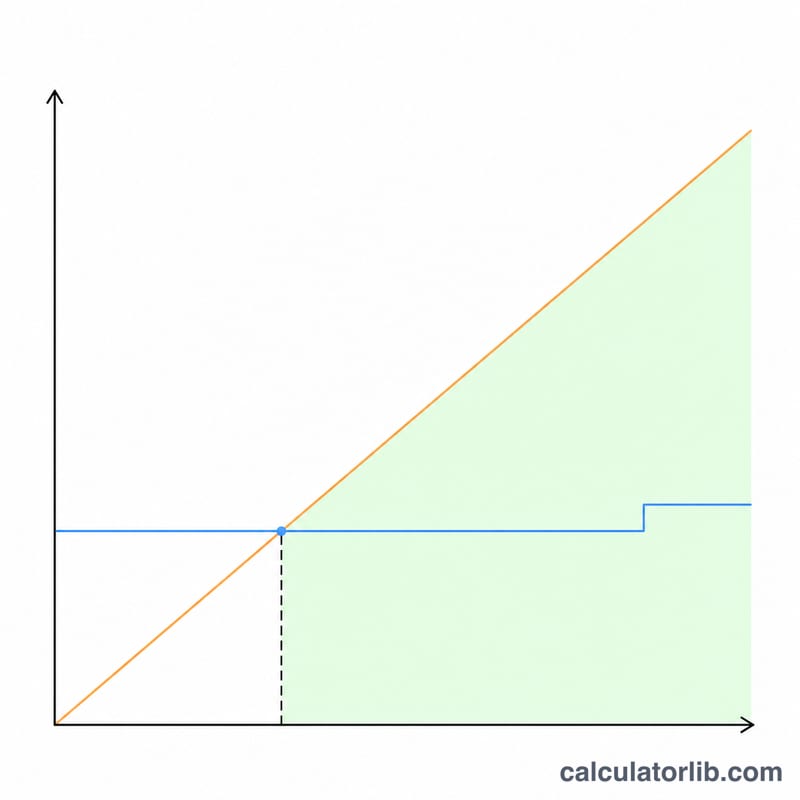
Một cụm chạy liên tục tốn cùng một khoản mỗi tháng: giá GPU-giờ × số GPU × 730 giờ. Hóa đơn API thì tăng theo khối lượng. Điểm hòa vốn là khối lượng hằng tháng mà hai bên bằng nhau, tức chi phí cố định hằng tháng chia cho giá API mỗi token. Con số này chỉ có ý nghĩa khi một cụm phục vụ được khối lượng đó; vượt quá công suất thì bạn cần thêm cụm, vì vậy đường tự vận hành trên biểu đồ tăng theo bậc.
Với dữ liệu mặc định (Llama 3 70B BF16 trên hai GPU H100 SXM, giá ví dụ 2,50 USD mỗi GPU-giờ, 16 chuỗi đồng thời, 1.500 token prompt và 500 token đầu ra mỗi yêu cầu), ước tính đạt khoảng 397 token đầu ra mỗi giây và 1,75 USD cho mỗi 1 triệu token ở mức sử dụng 50%. So với giá API ví dụ 1 USD đầu vào và 5 USD đầu ra mỗi 1 triệu token, điểm hòa vốn vào khoảng 1.825 triệu token mỗi tháng.
Thông số GPU được dùng
Các cấu hình có sẵn dùng datasheet của chính nhà sản xuất. Hiệu năng tensor thường được công bố kèm structured sparsity, gấp đôi mức dense; suy luận thông thường chạy dense, nên bảng và công cụ đều dùng số dense.
| GPU | Bộ nhớ (GB) | Băng thông (GB/s) | TFLOPS FP16/BF16 dense | TFLOPS FP8 dense |
|---|---|---|---|---|
| NVIDIA H100 SXM5 | 80 | 3,352 | 989.4 | 1,978.9 |
| NVIDIA H100 PCIe | 80 | 2,039 | 756 | 1,513 |
| NVIDIA H200 SXM | 141 | 4,800 | 989.5 | 1,979 |
| NVIDIA A100 80GB SXM | 80 | 2,039 | 312 | — |
| NVIDIA A100 80GB PCIe | 80 | 1,935 | 312 | — |
| NVIDIA L40S | 48 | 864 | 362.05 | 733 |
| NVIDIA L4 | 24 | 300 | 121 | 242.5 |
| AMD Instinct MI300X | 192 | 5,300 | 1,307.45 | 2,614.9 |
Nếu GPU của bạn không có trong danh sách, hãy chọn GPU tự nhập và điền bộ nhớ, băng thông cùng TFLOPS dense của nó.
Những gì ước tính chưa tính đến
- Mỗi engine phục vụ một khác: continuous batching, paged KV cache, speculative decoding và kernel tối ưu có thể làm thông lượng thay đổi đáng kể. Hãy đo trên hệ thống của bạn và nhập kết quả.
- Chia mô hình qua nhiều GPU sinh thêm thời gian truyền thông mà ước tính bỏ qua.
- Mô hình mixture-of-experts chỉ đọc các expert đang hoạt động cho mỗi token: hãy nhập số tham số hoạt động để tính tốc độ, nhưng kiểm tra bộ nhớ với tổng số tham số.
- Các mô hình dùng tokenizer khác nhau, nên cùng một đoạn văn có thể ra số token khác nhau.
- Điện năng, nhân sự, dung lượng dự phòng cho giờ cao điểm và phí truyền dữ liệu ra ngoài chưa được tính, trừ khi bạn cộng chúng vào giá theo giờ.
Để tính bộ nhớ GPU chi tiết hơn, hãy dùng công cụ tính VRAM GPU cần thiết.
















