LLM 자체 호스팅 vs API 비용 계산기

LLM 자체 호스팅 vs API 비용 계산기

신흥 AI Skill PRO

계산 입력

GPU 구성

시간당 가격은 예시입니다. 클라우드 견적 단가나 자체 하드웨어의 감가상각 비용을 입력하세요.

모델

기본값은 Llama 3 70B(레이어 80개, 차원 8,192, 헤드 64개, 키/값 헤드 8개)입니다. 사용하는 모델의 값은 설정 파일이나 논문에서 가져오세요.

GPU 필요 VRAM 계산기

워크로드

효율

두 효율 값은 수정 가능한 가정이며 측정값이 아닙니다. 실제 배치 크기로 자체 서빙 환경을 벤치마크한 값이 가장 좋은 입력입니다.

비교할 API

공식

100만 토큰당 비용=GPU 시간당 가격×G토큰/초×3600×u×106\text{100만 토큰당 비용} = \dfrac{\text{GPU 시간당 가격} \times G}{\text{토큰/초} \times 3600 \times u} \times 10^{6}
계산 단계 보기 (3)
  1. 디코드 단계 시간(루프라인)

    tstep=max⁡(Nb+BS‾kηGBW,B(2N+2nlayerS‾d)mGF)t_{\text{step}} = \max\left(\dfrac{N b + B \bar{S} k}{\eta\, G\, BW},\; \dfrac{B (2N + 2\, n_{\text{layer}} \bar{S} d)}{m\, G\, F}\right)

    디코드 한 단계는 가중치(N·b 바이트)와 모든 시퀀스의 KV 캐시(B·S̄·k 바이트)를 실효 대역폭 η·G·BW로 읽고, B·(2N + 2·n_layer·S̄·d) FLOP을 m·G·F로 계산합니다. 더 느린 쪽이 단계 시간을 결정합니다(Williams·Waterman·Patterson, Kaplan 외 2020 식 2.2).

  2. 토큰당 KV 캐시

    k=2nlayernkvdnheadbkvk = 2\, {{n_{\text{layer}}}}\, {{n_{\text{kv}}}}\, \dfrac{d}{{{n_{\text{head}}}}}\, b_{\text{kv}}

    모든 레이어의 키와 값: 크기 d ÷ n_head인 키/값 헤드 n_kv개, 값당 b_kv 바이트.

  3. 월 손익분기 사용량

    V∗=pGPU×G×730pAPI/106V^{*} = \dfrac{{{p_{\text{GPU}}}} \times G \times 730}{p_{\text{API}} / 10^{6}}

    상시 가동 구성의 월 고정비(GPU 시간당 가격 × G × 730시간)를 프롬프트/출력 비율로 가중한 API 토큰당 가격으로 나눈 값입니다. 구성 1개의 처리 용량보다 작을 때만 도달할 수 있습니다.

사용 통계

광고

결과

자체 호스팅 100만 토큰당 비용
$1.75
입력 + 출력 토큰, 입력한 가동률 기준
API 100만 토큰당 비용
$2.00
Claude Haiku 4.5
현재 월간 사용량에서 더 저렴한 쪽: API
월 비용 차이: $1,650
손익분기 사용량(상시 가동): 1,825 백만 토큰/월
초당 출력 토큰
397
추정값, 전체 구성
사용자당 속도(디코드)
31.5
시퀀스당 토큰/초
전체 초당 토큰
1,587
프롬프트 + 출력
자체 호스팅 출력 100만 토큰당 비용
$7.00
프롬프트 처리 포함
API 출력 100만 토큰당 비용
$8.00
해당 프롬프트 비용 포함
구성 1개의 처리 용량
2,085
백만 토큰/월

현재 사용량의 월 비용

월간 사용량(백만 토큰) 1,000
시간당 GPU 비용(전체 GPU) $5.00
필요한 구성 수 1
자체 호스팅, 상시 가동(730시간) $3,650.00
API $2,000.00

비용 곡선

월간 토큰 사용량별 월 비용 02,0004,0006,000 01,0002,000
자체 호스팅(계단 = 구성 추가) API 현재 사용량 손익분기점

가로축: 월 백만 토큰. 세로축: 월 비용(미국 달러).

처리량 추정

GPU NVIDIA H100 SXM5 80GB × 2
디코드 병목 메모리 대역폭
디코드 단계당 메모리 시간(ms)
31.79
디코드 단계당 연산 시간(ms)
2.88
배치 1개의 프리필 시간(ms) 4,275
추정 초당 출력 토큰 397
적용한 최대 TFLOPS(dense, GPU당) 989.4

메모리 점검

모델 가중치(GB) 140.0
토큰당 KV 캐시(MB) 0.328
KV 캐시, 모든 시퀀스 최대 길이 기준(GB) 10.5
필요량 / 보유량(GB)
150.5 / 160
GPU 메모리 수용 여부 예
수용 가능한 최대 시퀀스 수 30

런타임 버퍼, 활성값, 메모리 단편화도 공간을 차지하므로 여유를 두세요.

적용한 API 가격

입력 100만 토큰당 가격 $1.00
출력 100만 토큰당 가격 $5.00
출력 토큰 1개당 프롬프트 토큰 3

정가 출처: BerriAI (LiteLLM), 2026-11-02

같은 프롬프트·출력 비율의 다른 API 모델

모델 100만 토큰당 월
Gemini 2.5 Flash-Lite $0.17 $175
Claude Haiku 5.5 $0.20 $200
gpt-6-luna $0.20 $200
DeepSeek Flash (off-peak) $0.26 $263
deepseek-flash $0.53 $525
Mistral Large $0.75 $750
Gemini 3.5 Flash-Lite $0.85 $850
Gemini 2.5 Flash $0.85 $850
DeepSeek V4 Pro (off-peak) $0.99 $990
Gemini 3.8 Flash $1.50 $1,500
deepseek-v4-pro $1.98 $1,980
Claude Haiku 4.5 $2.00 $2,000
gpt-6.1-terra $2.00 $2,000
Gemini 2.5 Pro $3.44 $3,438
Claude Sonnet 5.5 $4.00 $4,000
gpt-6.1-sol $4.00 $4,000
Gemini 4 Argon $4.00 $4,000
Gemini 3.1 Pro Preview $4.50 $4,500
Claude Sonnet 4.6 $6.00 $6,000
Claude Opus 5.5 $8.00 $8,000
Claude Opus 5 $10.00 $10,000
Claude Fable 5.1 $20.00 $20,000
gpt-6-astra $20.00 $20,000

파란색: 현재 사용량에서 자체 호스팅보다 저렴. 주황색: 자체 호스팅이 더 저렴.

데이터시트 최대 성능(dense, 희소성 미적용)과 입력한 효율 가정을 바탕으로 한 추정입니다. 실제 처리량은 서빙 엔진, 커널, 트래픽에 따라 달라지므로 결정 전에는 실측값을 입력하세요.

이 페이지의 오류 신고

이 계산기가 답하는 질문

GPU를 빌려 오픈 웨이트 모델을 직접 운영할까, 아니면 토큰당 요금을 내고 API를 쓸까? 답은 세 가지 숫자에 달려 있습니다. GPU가 실제로 초당 몇 토큰을 만들어 내는지, 얼마나 꾸준히 바쁘게 돌리는지, 그리고 매달 몇 토큰이 필요한지입니다. 이 계산기는 첫 번째 값을 GPU 데이터시트와 모델 구조로 추정하고, 100만 토큰당 비용으로 바꾼 뒤 같은 프롬프트·출력 토큰 비율의 API 가격과 비교합니다.

처리량 추정 방법

배치의 모든 시퀀스에 대해 토큰을 하나씩 생성하는 디코드 한 단계에서는 모델 가중치 전체를 GPU 메모리에서 한 번 읽고, 시퀀스마다 키/값(KV) 캐시도 읽습니다. 연산량은 파라미터가 \( N \)개인 모델에서 토큰당 약 \( 2N \)회의 부동소수점 연산에, 문맥 길이에 따라 커지는 어텐션 항이 더해집니다(Kaplan 외, 2020, 식 2.2). Williams, Waterman, Patterson의 루프라인 모델에 따르면 한 단계의 시간은 두 한계 중 더 느린 쪽으로 정해집니다.

$$ t_{\text{step}} = \max\left( \frac{N b + B \bar{S} k}{\eta \, G \, BW},\; \frac{B \, (2N + 2 \, n_{\text{layer}} \bar{S} d)}{m \, G \, F} \right) $$

\( b \)는 가중치당 바이트, \( B \)는 동시 처리 시퀀스 수, \( \bar{S} \)는 디코드 중 평균 문맥 길이(프롬프트 + 출력의 절반), \( k \)는 토큰당 KV 캐시 바이트, \( G \)는 GPU 수, \( BW \)는 메모리 대역폭, \( F \)는 해당 정밀도의 dense 최대 FLOPS, \( \eta \)는 대역폭 효율, \( m \)은 연산 효율(MFU)입니다. 토큰당 KV 캐시는 \( k = 2 \, n_{\text{layer}} \, n_{\text{kv}} \, (d / n_{\text{head}}) \, b_{\text{kv}} \)입니다.

프롬프트는 먼저 한꺼번에 병렬로 처리되므로(프리필) 보통 연산 성능이 병목입니다. Pope 외(2022)와 같이 배치 하나의 시간은 프리필 시간에 출력 토큰마다 디코드 한 단계를 더한 값이고, 초당 출력 토큰은 \( B \) × 요청당 출력 토큰 ÷ 배치 시간입니다.

배치가 작으면 메모리 항이 지배적이어서 사용자당 속도는 대략 대역폭 ÷ 모델 크기가 됩니다. 배치를 키우면 가중치 읽기 한 번을 더 많은 시퀀스가 나눠 쓰므로 KV 캐시나 연산 성능이 한계가 될 때까지 전체 처리량이 늘어납니다.
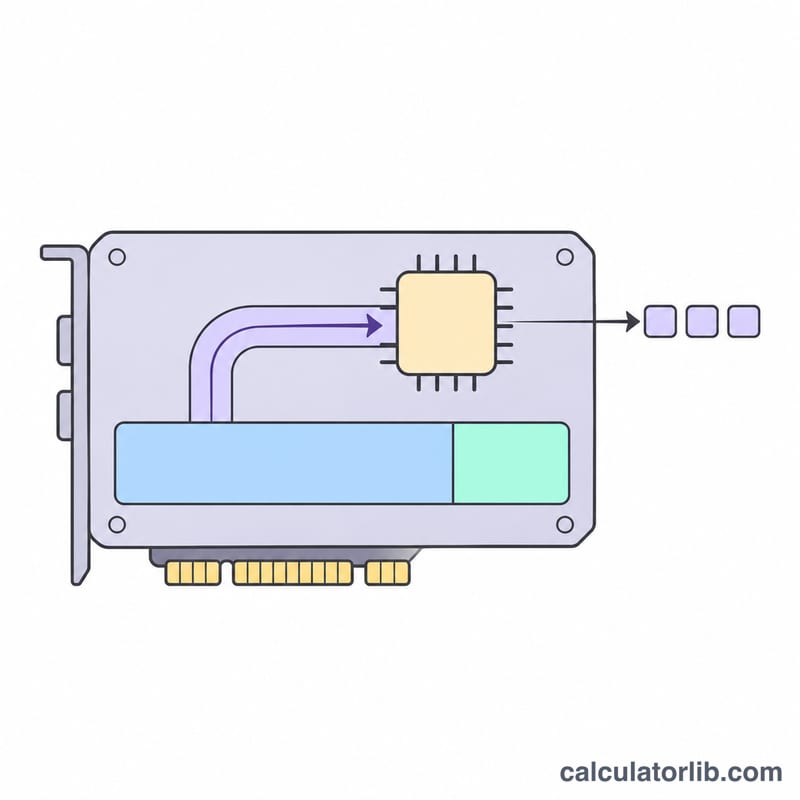
메모리가 모델 가중치와 KV 캐시로 나뉘고, 대역폭 파이프가 연산 칩에 데이터를 공급하는 GPU 일러스트
디코딩 속도는 주로 GPU가 메모리에서 모델 가중치를 얼마나 빠르게 읽어오는지에 달려 있어, 메모리 대역폭이 처리량 상한을 결정합니다.

초당 토큰에서 100만 토큰당 비용으로

$$ \text{100만 토큰당 비용} = \frac{p_{\text{GPU}} \times G}{\text{토큰/초} \times 3600 \times u} \times 10^{6} $$

\( p_{\text{GPU}} \)는 GPU 1시간당 가격, \( u \)는 평균 가동률로, 비용을 낸 시간 중 GPU가 모델링한 속도로 서비스하는 비율입니다. 절반만 바쁜 구성은 토큰당 두 배를 냅니다. API 쪽은 입력·출력 가격을 요청당 프롬프트·출력 토큰 수로 가중하므로 두 방식을 같은 토큰 기준으로 비교합니다.
광고
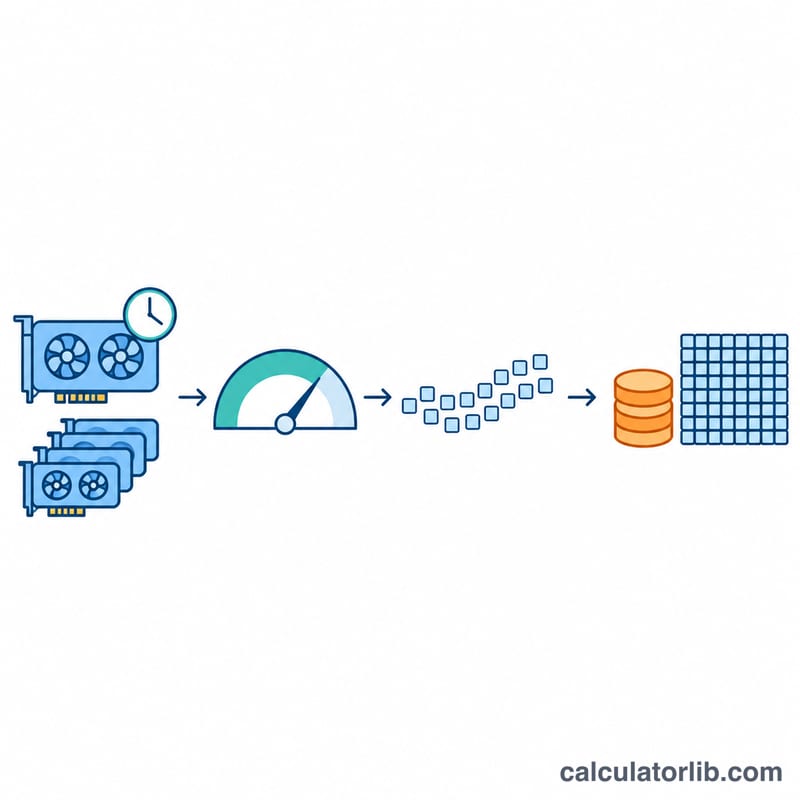
GPU 시간당 가격과 GPU 수를 가동률과 처리량으로 조정해 100만 토큰당 비용으로 바꾸는 흐름도
자체 호스팅 시 100만 토큰당 비용: GPU 시간당 비용을 실제 가동률에서 시간당 생성되는 토큰 수로 나눈 값입니다.

손익분기 사용량

상시 가동 구성은 매달 같은 비용이 듭니다. GPU 시간당 가격 × GPU 수 × 730시간입니다. API 요금은 사용량에 따라 늘어납니다. 손익분기점은 두 비용이 같아지는 월 사용량, 즉 월 고정비 ÷ API 토큰당 가격입니다. 다만 구성 하나가 그 사용량을 처리할 수 있을 때만 의미가 있습니다. 처리 용량을 넘으면 구성을 하나 더 늘려야 하므로 차트의 자체 호스팅 선이 계단처럼 올라갑니다.

기본값(Llama 3 70B를 BF16으로 H100 SXM 2장에 올리고, 예시 가격 GPU 1시간당 2.50 USD, 동시 시퀀스 16개, 요청당 프롬프트 1,500·출력 500 토큰)에서는 초당 약 397 출력 토큰, 가동률 50%에서 100만 토큰당 1.75 USD로 추정됩니다. 예시 API 가격(100만 토큰당 입력 1 USD, 출력 5 USD)과 비교하면 손익분기점은 월 약 18억 2,500만 토큰입니다.
광고
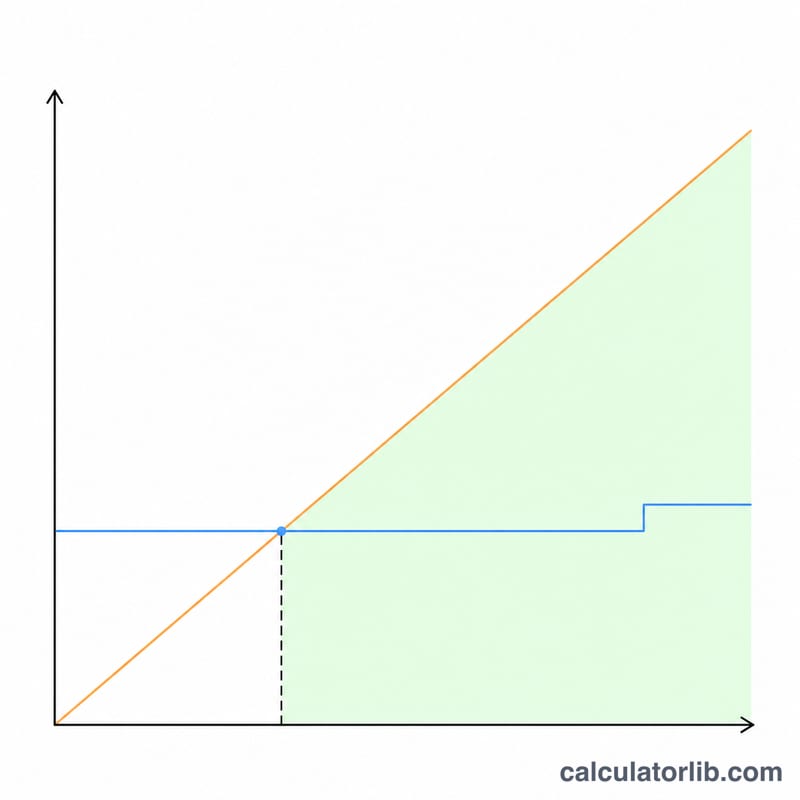
상승하는 API 비용 선이 수평한 자체 호스팅 비용 선과 손익분기 지점에서 교차하는 선 그래프
손익분기점: 월간 처리량이 교차점을 넘으면 고정비 GPU가 토큰당 과금하는 API보다 저렴해집니다.

사용한 GPU 수치

프리셋은 각 제조사 데이터시트의 값입니다. 텐서 연산 성능은 구조적 희소성을 적용한 값으로 발표되는 경우가 많은데, 이는 dense 성능의 두 배입니다. 일반 추론은 dense로 실행되므로 표와 계산기는 dense 값을 씁니다.

GPU 메모리(GB) 대역폭(GB/s) FP16/BF16 TFLOPS(dense) FP8 TFLOPS(dense)
NVIDIA H100 SXM5 80 3,352 989.4 1,978.9
NVIDIA H100 PCIe 80 2,039 756 1,513
NVIDIA H200 SXM 141 4,800 989.5 1,979
NVIDIA A100 80GB SXM 80 2,039 312 —
NVIDIA A100 80GB PCIe 80 1,935 312 —
NVIDIA L40S 48 864 362.05 733
NVIDIA L4 24 300 121 242.5
AMD Instinct MI300X 192 5,300 1,307.45 2,614.9

목록에 없는 GPU는 '사용자 지정 GPU'를 고르고 메모리, 대역폭, dense TFLOPS를 입력하세요.

추정에 포함되지 않는 것

  • 서빙 엔진마다 차이가 큽니다. continuous batching, paged KV 캐시, 추측 디코딩, 최적화된 커널에 따라 처리량이 크게 달라지므로 자체 환경에서 측정한 값을 입력하세요.
  • 모델을 여러 GPU에 나누면 통신 시간이 추가되지만 추정에는 반영하지 않습니다.
  • Mixture-of-Experts 모델은 토큰마다 활성 전문가만 읽습니다. 속도에는 활성 파라미터 수를 넣고, 메모리는 전체 파라미터 수로 확인하세요.
  • 모델마다 토크나이저가 달라 같은 문장도 토큰 수가 다를 수 있습니다.
  • 전력, 인건비, 피크 대비 예비 용량, 외부 전송 비용은 시간당 가격에 더하지 않는 한 포함되지 않습니다.

GPU 메모리를 더 자세히 산정하려면 GPU 필요 VRAM 계산기를 사용하세요.

출처 및 참고 자료

최종 업데이트:

산업별 인기 계산기

산업별 계산기 전체 보기