حاسبة تكلفة استضافة LLM ذاتيًا مقابل API

حاسبة تكلفة استضافة LLM ذاتيًا مقابل API

في نمو AI Skill PRO

أدخل الحساب

إعداد وحدات GPU

السعر بالساعة مثال فقط. أدخل السعر من عرض مزود السحابة أو تكلفة الاستهلاك لعتادك الخاص.

النموذج

القيم الافتراضية: Llama 3 70B (80 طبقة، بُعد 8192، 64 رأسًا، 8 رؤوس مفتاح/قيمة). انسخ قيم نموذجك من ملف إعداداته أو ورقته البحثية.

حاسبة ذاكرة VRAM المطلوبة لوحدة GPU

عبء العمل

الكفاءة

قيمتا الكفاءة افتراضان قابلان للتعديل وليستا قياسًا. أفضل مدخل هو قياس أداء منظومة التشغيل الخاصة بك بحجم الدفعة الذي تستخدمه.

واجهة API للمقارنة

صيغة رياضية

التكلفة لكل مليون رمز=سعر ساعة GPU×Gرمز/ثانية×3600×u×106\text{التكلفة لكل مليون رمز} = \dfrac{\text{سعر ساعة GPU} \times G}{\text{رمز/ثانية} \times 3600 \times u} \times 10^{6}
عرض خطوات الحساب (3)
  1. زمن خطوة فك الترميز (roofline)

    tstep=max⁡(Nb+BS‾kηGBW,B(2N+2nlayerS‾d)mGF)t_{\text{step}} = \max\left(\dfrac{N b + B \bar{S} k}{\eta\, G\, BW},\; \dfrac{B (2N + 2\, n_{\text{layer}} \bar{S} d)}{m\, G\, F}\right)

    تقرأ خطوة فك الترميز الأوزان (N·b بايت) وذاكرة KV المؤقتة لكل التسلسلات (B·S̄·k بايت) بعرض النطاق الفعلي η·G·BW، وتنفّذ B·(2N + 2·n_layer·S̄·d) عملية FLOP بمعدل m·G·F. الأبطأ بينهما يحدد زمن الخطوة (Williams وWaterman وPatterson؛ Kaplan وآخرون 2020، المعادلة 2.2).

  2. ذاكرة KV المؤقتة لكل رمز

    k=2nlayernkvdnheadbkvk = 2\, {{n_{\text{layer}}}}\, {{n_{\text{kv}}}}\, \dfrac{d}{{{n_{\text{head}}}}}\, b_{\text{kv}}

    المفاتيح والقيم لكل طبقة: n_kv من رؤوس المفتاح/القيمة بحجم d ÷ n_head، وb_kv بايت لكل قيمة.

  3. حجم التعادل الشهري

    V∗=pGPU×G×730pAPI/106V^{*} = \dfrac{{{p_{\text{GPU}}}} \times G \times 730}{p_{\text{API}} / 10^{6}}

    التكلفة الشهرية الثابتة لإعداد يعمل باستمرار (سعر ساعة GPU × G × 730 ساعة) مقسومة على سعر API لكل رمز وفق نسبة الموجّه إلى المخرجات لديك. لا يمكن بلوغه إلا إذا كان أقل من سعة إعداد واحد.

إحصاءات الاستخدام

اعلان

نتائج

تكلفة الاستضافة الذاتية لكل مليون رمز
$١٫٧٥
رموز الإدخال + الإخراج، بنسبة الاستغلال التي أدخلتها
تكلفة API لكل مليون رمز
$٢٫٠٠
Claude Haiku 4.5
الأرخص عند حجمك الشهري: API
الفرق الشهري: $١٬٦٥٠
حجم التعادل (تشغيل دائم): ١٬٨٢٥ مليون رمز شهريًا
رموز المخرجات في الثانية
٣٩٧
تقدير، للإعداد كاملًا
السرعة لكل مستخدم (فك الترميز)
٣١٫٥
رمز/ثانية لكل تسلسل
كل الرموز في الثانية
١٬٥٨٧
الموجّه + المخرجات
تكلفة الاستضافة الذاتية لكل مليون رمز مخرجات
$٧٫٠٠
تشمل معالجة الموجّه
تكلفة API لكل مليون رمز مخرجات
$٨٫٠٠
مع الموجّهات اللازمة لها
سعة إعداد واحد
٢٬٠٨٥
مليون رمز شهريًا

التكلفة الشهرية عند حجمك

الحجم الشهري (مليون رمز) ١٬٠٠٠
تكلفة GPU بالساعة (كل الوحدات) $٥٫٠٠
عدد الإعدادات اللازمة 1
استضافة ذاتية، تشغيل دائم (730 ساعة) $٣٬٦٥٠٫٠٠
API $٢٬٠٠٠٫٠٠

منحنى التكلفة

التكلفة الشهرية حسب حجم الرموز الشهري ٠٢٬٠٠٠٤٬٠٠٠٦٬٠٠٠ ٠١٬٠٠٠٢٬٠٠٠
استضافة ذاتية (كل درجة = إعداد إضافي) API حجمك نقطة التعادل

المحور الأفقي: مليون رمز شهريًا. المحور الرأسي: دولار أمريكي شهريًا.

تقدير الإنتاجية

GPU NVIDIA H100 SXM5 80GB × 2
فك الترميز محدود بـ عرض نطاق الذاكرة
زمن الذاكرة لكل خطوة فك ترميز (مللي ثانية)
٣١٫٧٩
زمن الحوسبة لكل خطوة فك ترميز (مللي ثانية)
٢٫٨٨
زمن التعبئة المسبقة لدفعة واحدة (مللي ثانية) ٤٬٢٧٥
رموز المخرجات المقدّرة في الثانية ٣٩٧
ذروة TFLOPS الكثيفة المستخدمة (لكل GPU) ٩٨٩٫٤

فحص الذاكرة

أوزان النموذج (غيغابايت) ١٤٠٫٠
ذاكرة KV المؤقتة لكل رمز (ميغابايت) ٠٫٣٢٨
ذاكرة KV المؤقتة لكل التسلسلات بطولها الكامل (غيغابايت) ١٠٫٥
المطلوب مقابل المتاح (غيغابايت)
١٥٠٫٥ / ١٦٠
يتسع في ذاكرة GPU نعم
أقصى عدد من التسلسلات يتسع ٣٠

تحتاج مخازن وقت التشغيل والتنشيطات والتجزؤ أيضًا إلى ذاكرة، لذا اترك هامشًا.

سعر API المستخدم

سعر الإدخال لكل مليون رمز $١٫٠٠
سعر الإخراج لكل مليون رمز $٥٫٠٠
رموز الموجّه لكل رمز مخرجات ٣

السعر المعلن من BerriAI (LiteLLM), 2026-11-02

نماذج API أخرى بنفس نسبة الموجّه إلى المخرجات

النموذج لكل مليون رمز شهريًا
Gemini 2.5 Flash-Lite $٠٫١٧ $١٧٥
Claude Haiku 5.5 $٠٫٢٠ $٢٠٠
gpt-6-luna $٠٫٢٠ $٢٠٠
DeepSeek Flash (off-peak) $٠٫٢٦ $٢٦٣
deepseek-flash $٠٫٥٣ $٥٢٥
Mistral Large $٠٫٧٥ $٧٥٠
Gemini 3.5 Flash-Lite $٠٫٨٥ $٨٥٠
Gemini 2.5 Flash $٠٫٨٥ $٨٥٠
DeepSeek V4 Pro (off-peak) $٠٫٩٩ $٩٩٠
Gemini 3.8 Flash $١٫٥٠ $١٬٥٠٠
deepseek-v4-pro $١٫٩٨ $١٬٩٨٠
Claude Haiku 4.5 $٢٫٠٠ $٢٬٠٠٠
gpt-6.1-terra $٢٫٠٠ $٢٬٠٠٠
Gemini 2.5 Pro $٣٫٤٤ $٣٬٤٣٨
Claude Sonnet 5.5 $٤٫٠٠ $٤٬٠٠٠
gpt-6.1-sol $٤٫٠٠ $٤٬٠٠٠
Gemini 4 Argon $٤٫٠٠ $٤٬٠٠٠
Gemini 3.1 Pro Preview $٤٫٥٠ $٤٬٥٠٠
Claude Sonnet 4.6 $٦٫٠٠ $٦٬٠٠٠
Claude Opus 5.5 $٨٫٠٠ $٨٬٠٠٠
Claude Opus 5 $١٠٫٠٠ $١٠٬٠٠٠
Claude Fable 5.1 $٢٠٫٠٠ $٢٠٬٠٠٠
gpt-6-astra $٢٠٫٠٠ $٢٠٬٠٠٠

الأزرق: أرخص من الاستضافة الذاتية عند حجمك. البرتقالي: الاستضافة الذاتية أرخص.

تقديرات مبنية على قيم الذروة في أوراق المواصفات (كثيفة، دون التناثر) وعلى افتراضات الكفاءة لديك. تعتمد الإنتاجية الفعلية على محرك التشغيل والنوى البرمجية وحركة المرور؛ أدخل قيمة مقيسة قبل اتخاذ القرار.

الإبلاغ عن خطأ في هذه الصفحة

ما الذي تجيب عنه هذه الحاسبة

هل تستأجر وحدات GPU وتشغّل نموذجًا مفتوح الأوزان بنفسك، أم تدفع لواجهة API مقابل كل رمز؟ تعتمد الإجابة على ثلاثة أرقام: كم رمزًا في الثانية تنتجه وحداتك فعليًا، وإلى أي حد تبقيها مشغولة، وكم رمزًا تحتاج كل شهر. تقدّر الحاسبة الرقم الأول من ورقة مواصفات GPU وبنية النموذج، وتحوّله إلى تكلفة لكل مليون رمز، ثم تقارنه بسعر API للمزيج نفسه من رموز الموجّه والمخرجات.

كيف تُقدَّر الإنتاجية

توليد رمز واحد لكل تسلسل في الدفعة (خطوة فك ترميز) يتطلب قراءة جميع أوزان النموذج من ذاكرة GPU مرة واحدة، إضافةً إلى ذاكرة المفتاح/القيمة (KV) المؤقتة لكل تسلسل. ويكلّف كذلك نحو \( 2N \) عملية فاصلة عائمة لكل رمز في نموذج ذي \( N \) معامل، مع حد للانتباه يزداد بطول السياق (Kaplan وآخرون، 2020، المعادلة 2.2). وفق نموذج roofline لـ Williams وWaterman وPatterson، تستغرق الخطوة زمن الأبطأ بين الحدّين:

$$ t_{\text{step}} = \max\left( \frac{N b + B \bar{S} k}{\eta \, G \, BW},\; \frac{B \, (2N + 2 \, n_{\text{layer}} \bar{S} d)}{m \, G \, F} \right) $$

حيث \( b \) عدد البايتات لكل وزن، و\( B \) عدد التسلسلات المتزامنة، و\( \bar{S} \) متوسط السياق أثناء فك الترميز (الموجّه مع نصف المخرجات)، و\( k \) بايتات ذاكرة KV المؤقتة لكل رمز، و\( G \) عدد وحدات GPU، و\( BW \) عرض نطاق الذاكرة، و\( F \) ذروة FLOPS الكثيفة للدقة المختارة، و\( \eta \) كفاءة عرض النطاق، و\( m \) استغلال الحوسبة (MFU). وذاكرة KV المؤقتة لكل رمز هي \( k = 2 \, n_{\text{layer}} \, n_{\text{kv}} \, (d / n_{\text{head}}) \, b_{\text{kv}} \).

يُعالَج الموجّه أولًا وبالتوازي (التعبئة المسبقة)، لذا يكون عادةً محدودًا بالحوسبة. كما في Pope وآخرين (2022)، تستغرق الدفعة زمن التعبئة المسبقة مضافًا إليه خطوة فك ترميز لكل رمز مخرجات، ورموز المخرجات في الثانية تساوي \( B \) مضروبًا في رموز المخرجات لكل طلب ومقسومًا على زمن الدفعة.

في الدفعات الصغيرة يهيمن حد الذاكرة، وتقترب السرعة لكل مستخدم من عرض النطاق مقسومًا على حجم النموذج. أما الدفعات الأكبر فتتقاسم كل قراءة للأوزان بين تسلسلات أكثر، فترتفع الإنتاجية الكلية حتى تصبح ذاكرة KV المؤقتة أو الحوسبة هي الحد.
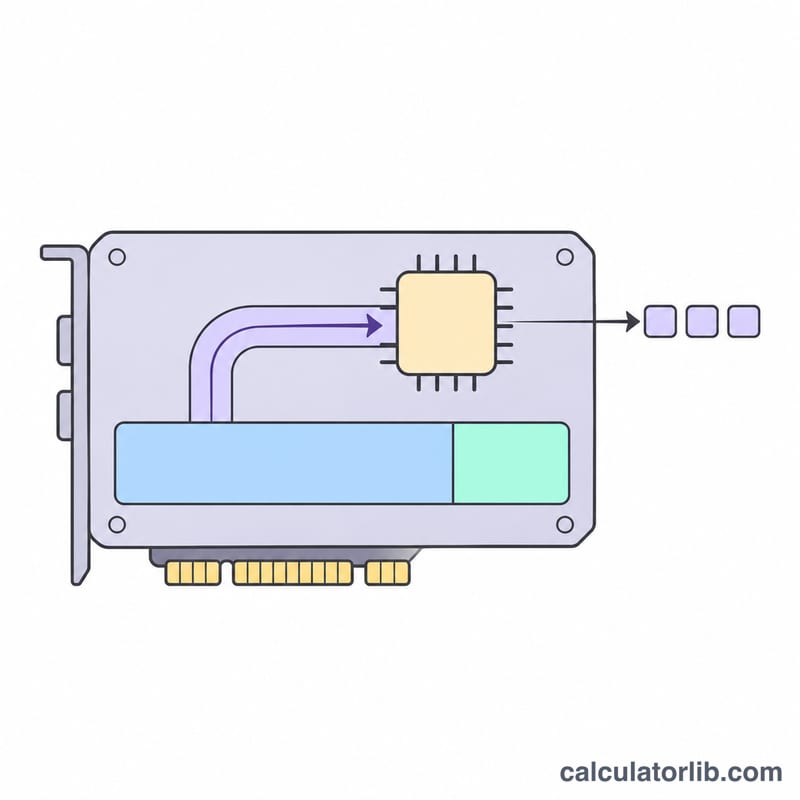
رسم توضيحي لوحدة معالجة رسوميات تنقسم ذاكرتها بين أوزان النموذج وذاكرة KV المؤقتة، مع أنبوب عرض نطاق يغذّي شريحة الحوسبة
تعتمد سرعة فك التشفير غالبًا على مدى سرعة قراءة وحدة المعالجة لأوزان النموذج من الذاكرة، لذا يحدد عرض نطاق الذاكرة الحد الأقصى للإنتاجية.

من الرموز في الثانية إلى التكلفة لكل مليون رمز

$$ \text{التكلفة لكل مليون رمز} = \frac{p_{\text{GPU}} \times G}{\text{رمز/ثانية} \times 3600 \times u} \times 10^{6} $$

\( p_{\text{GPU}} \) سعر ساعة GPU، و\( u \) متوسط الاستغلال، أي نسبة الساعات المدفوعة التي تخدم فيها الوحدات بالمعدل المحسوب. الإعداد المشغول نصف الوقت يدفع ضعف التكلفة لكل رمز. أما في API فتُرجَّح أسعار الإدخال والإخراج برموز الموجّه والمخرجات لكل طلب، حتى يُحسب الخياران على الرموز نفسها.
اعلان
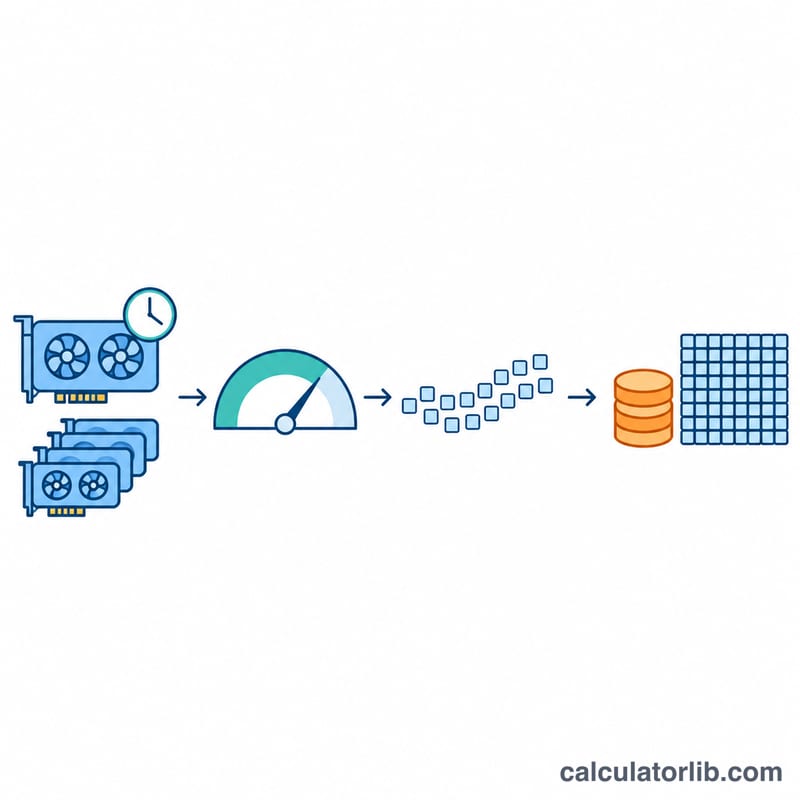
مخطط انسيابي يوضّح سعر ساعة وحدة معالجة الرسوميات وعددها، معدّلًا حسب الاستخدام والإنتاجية، ليتحول إلى تكلفة لكل مليون رمز
التكلفة الذاتية لكل مليون رمز: تكلفة ساعة وحدة معالجة الرسوميات مقسومة على عدد الرموز التي تُنتَج فعليًا كل ساعة حسب معدل استخدامك.

حجم التعادل

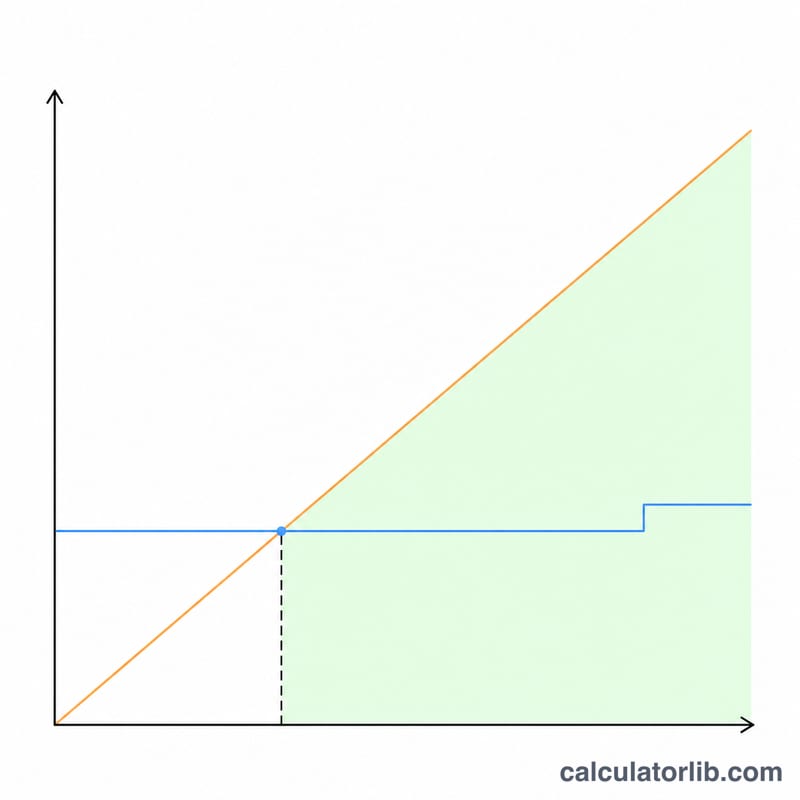
يكلّف الإعداد الذي يعمل باستمرار المبلغ نفسه كل شهر: سعر ساعة GPU × عدد الوحدات × 730 ساعة. أما فاتورة API فتزداد مع الحجم. نقطة التعادل هي الحجم الشهري الذي تتساوى عنده التكلفتان: التكلفة الشهرية الثابتة مقسومة على سعر API لكل رمز. ولا معنى لها إلا إذا استطاع إعداد واحد خدمة ذلك الحجم؛ وبعد تجاوز سعته يلزم إعداد آخر، ولهذا يرتفع خط الاستضافة الذاتية في الرسم على شكل درجات.

بالقيم الافتراضية (Llama 3 70B بدقة BF16 على وحدتي H100 SXM بسعر مثالي 2.50 دولار لساعة GPU، و16 تسلسلًا متزامنًا، و1,500 رمز موجّه و500 رمز مخرجات لكل طلب) يكون التقدير نحو 397 رمز مخرجات في الثانية و1.75 دولار لكل مليون رمز عند استغلال 50%. ومقابل سعر API مثالي قدره 1 دولار للإدخال و5 دولارات للإخراج لكل مليون رمز، تقع نقطة التعادل عند نحو 1,825 مليون رمز شهريًا.
اعلان
رسم خطي يتقاطع فيه خط تكلفة واجهة البرمجة المتصاعد مع خط التكلفة الذاتية الأفقي عند حجم التعادل
نقطة التعادل: عندما يتجاوز الحجم الشهري نقطة التقاطع، تصبح وحدة المعالجة ذات التكلفة الثابتة أرخص من الدفع لواجهة البرمجة لكل رمز.

بيانات GPU المستخدمة

تأتي الإعدادات المسبقة من ورقة مواصفات كل شركة مصنّعة. كثيرًا ما تُعلن إنتاجية أنوية Tensor مع التناثر البنيوي، وهي ضعف المعدل الكثيف؛ والاستدلال المعتاد يعمل بشكل كثيف، لذا يستخدم الجدول والحاسبة القيم الكثيفة.

GPU الذاكرة (غيغابايت) عرض النطاق (GB/s) TFLOPS كثيفة FP16/BF16 TFLOPS كثيفة FP8
NVIDIA H100 SXM5 80 3,352 989.4 1,978.9
NVIDIA H100 PCIe 80 2,039 756 1,513
NVIDIA H200 SXM 141 4,800 989.5 1,979
NVIDIA A100 80GB SXM 80 2,039 312 —
NVIDIA A100 80GB PCIe 80 1,935 312 —
NVIDIA L40S 48 864 362.05 733
NVIDIA L4 24 300 121 242.5
AMD Instinct MI300X 192 5,300 1,307.45 2,614.9

إذا لم تكن وحدتك في القائمة، فاختر «GPU مخصص» وأدخل ذاكرتها وعرض نطاقها وTFLOPS الكثيفة لها.

ما لا يشمله التقدير

  • تختلف محركات التشغيل: التجميع المستمر، وذاكرة KV المؤقتة المجزأة إلى صفحات، وفك الترميز التخميني، والنوى المحسّنة قد تغيّر الإنتاجية كثيرًا. قِس منظومتك وأدخل النتيجة.
  • توزيع النموذج على عدة وحدات GPU يضيف زمن اتصال لا يحسبه التقدير.
  • نموذج mixture-of-experts يقرأ الخبراء النشطين فقط لكل رمز: أدخل المعاملات النشطة لحساب السرعة، وتحقق من الذاكرة بالعدد الكلي.
  • تستخدم النماذج مقسّمات رموز مختلفة، فقد يعطي النص نفسه عددًا مختلفًا من الرموز.
  • الكهرباء ووقت الموظفين والسعة الاحتياطية لأوقات الذروة ورسوم نقل البيانات الصادرة غير مشمولة ما لم تضفها إلى السعر بالساعة.

لتقدير ذاكرة GPU بتفصيل أكبر، استخدم حاسبة ذاكرة VRAM المطلوبة لوحدة GPU.

المصادر والمراجع

آخر تحديث:

الأكثر شيوعًا في خاص بالصناعة

عرض جميع حاسبات خاص بالصناعة