ماذا تفعل هذه الحاسبة
تجيب عن الأسئلة الثلاثة في أي تجربة على معدل التحويل. تخطيط اختبار يبيّن عدد الزوار الذي تحتاجه كل نسخة لكشف الزيادة التي تختارها، وعدد الأيام اللازمة بحسب حركة الزيارات لديك. العينة الثابتة تعمل بالعكس: لعدد الزوار المتوفر لديك تعطي القوة الإحصائية لكشف الأثر الذي تريده، وأصغر أثر يمكن كشفه عند القوة المستهدفة. تحليل النتائج يأخذ التحويلات والزوار في A وB ويعيد الزيادة الملاحظة، والقيمة الاحتمالية لاختبار z لنسبتين مع فترة الثقة، والاحتمال البايزي لتفوق B على A، وكلها محسوبة بدقة من دون محاكاة عشوائية.
تُفتح الصفحة بقيم مثال: معدل حالي 5%، وMDE نسبي 10%، وα = 5% ثنائي الطرف، وقوة 80%. استبدلها بأرقامك.
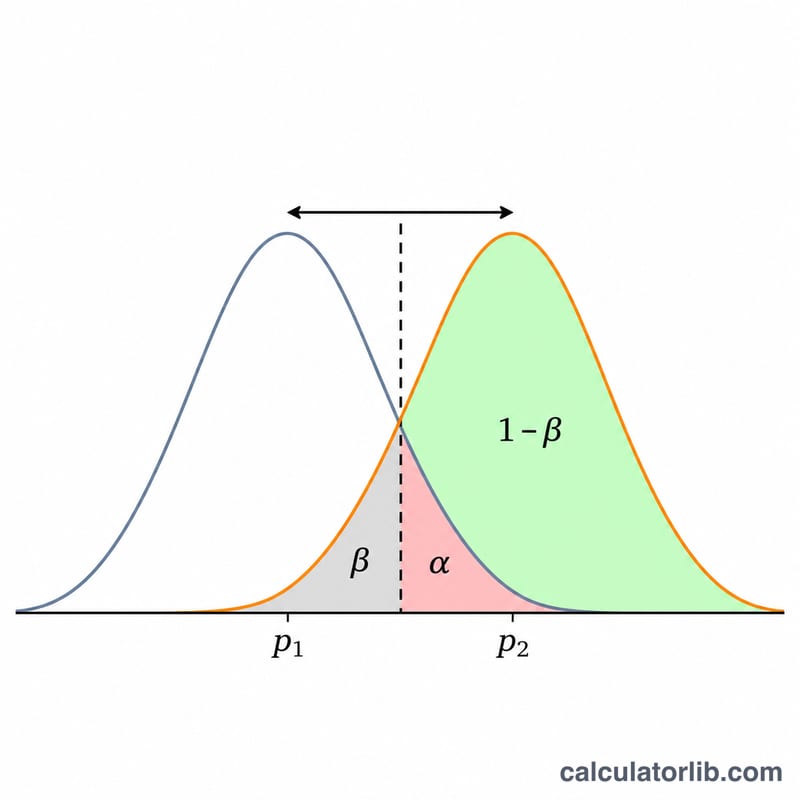
معادلة حجم العينة
لمجموعتين متساويتين في الحجم معدلا تحويلهما \( p_1 \) (التحكم) و\( p_2 \) (النسخة التجريبية)، يكون عدد الزوار اللازم لكل مجموعة
$$ n = \frac{\left( z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} + z_{1-\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2-p_1)^2}, \qquad \bar p = \frac{p_1+p_2}{2} $$حيث \( s = 2 \) للاختبار ثنائي الطرف و\( s = 1 \) للاختبار أحادي الطرف، و\( z \) هو مئين التوزيع الطبيعي المعياري. هذه المعادلة 4.14 في كتاب Fleiss وLevin وPaik Statistical Methods for Rates and Proportions (الطبعة الثالثة، 2003): يُحسب الانحراف المعياري تحت فرضية العدم من المعدل المجمّع \( \bar p \)، وتحت الفرضية البديلة من كل معدل على حدة. وهو التقريب الطبيعي نفسه لاختبار z المجمّع الذي ستجريه في النهاية، فيتطابق التخطيط مع التحليل. تُقرَّب النتيجة إلى العدد الصحيح الأعلى.
يعرض الجدول أيضًا الحجم مع تصحيح الاستمرارية لـ Fleiss وTytun وUry (1980): \( n_{cc} = \frac{n}{4}\left(1+\sqrt{1+\frac{4}{n\,|p_2-p_1|} }\right)^2 \). وغالبًا ما تطبع جداول الكتب هذا الرقم الأكبر والأكثر تحفظًا.
أمثلة يمكنك التحقق منها
Fleiss وLevin وPaik، الصفحة 74: \( p_1 = 0.60 \)، \( p_2 = 0.70 \)، α = 1% ثنائي الطرف، قوة 95%. تعطي المعادلة 807.07، أي 808 لكل مجموعة، و827 مع تصحيح الاستمرارية، وهو الرقم الوارد في الكتاب. وعند قوة 75% تعطي 479.6 (480)، و499.4 مع التصحيح: يطبع الكتاب 499، وتقرّب الحاسبة إلى 500. لإعادة الحساب هنا اختر الأثر المطلق، وأدخل 60 للمعدل الحالي و10 للأثر.
Ryan (2013)، كما تحقق منه دليل NCSS PASS: α = 5% أحادي الطرف، قوة 80%، 55% مقابل 65% → 295.7، أي 296 لكل مجموعة.
المثال الافتراضي: معدل حالي 5% وزيادة نسبية 10% يعنيان التمييز بين 5.5% و5%. مع α = 5% ثنائي الطرف وقوة 80% تحتاج إلى 31,234 زائرًا لكل نسخة، أي 62,468 إجمالًا، أو 32 يومًا بمعدل 2,000 زائر يوميًا.
MDE نسبي أم مطلق
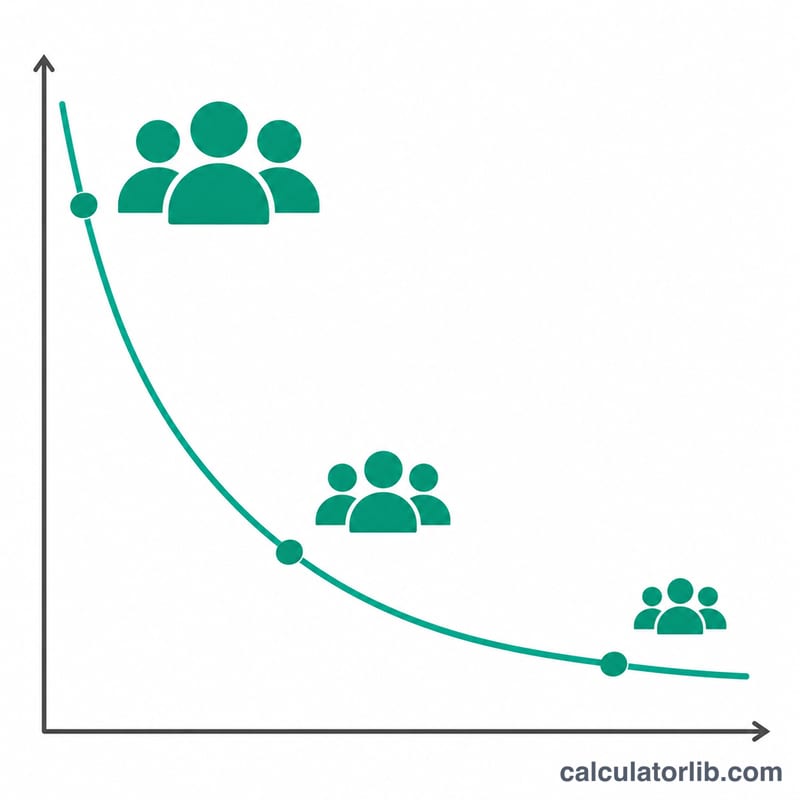
الأثر النسبي 10% على أساس 5% يعني 5.5% (\( p_2 = p_1(1+\text{MDE}) \)). والأثر المطلق بمقدار نقطة مئوية واحدة يعني 6% (\( p_2 = p_1 + \text{MDE} \)). تقليص الأثر إلى النصف يضاعف العينة نحو أربع مرات، لأن \( n \) يتناسب مع \( 1/(p_2-p_1)^2 \). المعدلات المنخفضة مكلفة: الزيادة النسبية نفسها على معدل 1% تحتاج إلى نحو خمسة أضعاف الزوار مقارنةً بمعدل 5%.
عدة نسخ وتصحيح بونفيروني
مع \( k \) نسخة بما فيها التحكم، تُقارَن كل نسخة من النسخ المنافسة الـ \( k-1 \) بنسخة التحكم، وتحصل كل مجموعة على \( n \) نفسه، فيكون الإجمالي \( k \cdot n \). كل مقارنة إضافية فرصة أخرى لاختيار فائز زائف. يختبر تصحيح بونفيروني (Dunn، 1961) كل مقارنة عند \( \alpha/(k-1) \)، فيبقى احتمال ظهور إيجابية كاذبة واحدة على الأقل عند \( \alpha \) أو أقل. وهو تصحيح متحفظ يرفع \( n \) لكل المجموعات.
القوة الإحصائية وMDE لعينة ثابتة
بحل المعادلة نفسها بالنسبة إلى القوة:
$$ 1-\beta = \Phi\!\left( \frac{|p_2-p_1|\sqrt{n} - z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} }{\sqrt{p_1(1-p_1)+p_2(1-p_2)} } \right) $$تحسبها الحاسبة للأثر الذي أدخلته، ثم تبحث عن أصغر زيادة تبلغ القوة المستهدفة. استخدم هذا الوضع عندما تكون حركة الزيارات محددة مسبقًا، مثل حملة تستمر أسبوعين أيًّا كانت النتيجة: إذا كانت الزيادة القابلة للكشف أكبر بكثير من أي تغيّر واقعي، فلن يخبرك الاختبار بالكثير.
قراءة النتائج: القيمة الاحتمالية وفترة الثقة
مع \( x_A \) تحويلًا من \( n_A \) زائرًا و\( x_B \) من \( n_B \)، تكون إحصاءة z المجمّعة \( z = (\hat p_B-\hat p_A)/\sqrt{\hat p(1-\hat p)(1/n_A+1/n_B)} \) حيث \( \hat p = (x_A+x_B)/(n_A+n_B) \). القيمة الاحتمالية ثنائية الطرف هي \( 2(1-\Phi(|z|)) \)، وأحادية الطرف لفرضية أن B أفضل هي \( 1-\Phi(z) \). تستخدم فترة الثقة للفرق الخطأ المعياري غير المجمّع: \( (\hat p_B-\hat p_A) \pm z_{1-\alpha/2}\sqrt{\hat p_A(1-\hat p_A)/n_A+\hat p_B(1-\hat p_B)/n_B} \). مثال: 500 من 10,000 مقابل 560 من 10,000 يعطي z = 1.894 وp = 0.0583، فالزيادة الملاحظة البالغة 12% ليست دالة عند 5%، وفترة الثقة 95% للفرق B − A تمتد من −0.02 إلى +1.22 نقطة مئوية.
الاحتمال البايزي لتفوق B على A
مع توزيع قبلي منتظم Beta(1, 1)، يكون التوزيع البعدي لمعدل التحويل بعد \( x \) تحويلًا من \( n \) زائرًا هو Beta(\( 1+x \), \( 1+n-x \)) (Gelman وآخرون، Bayesian Data Analysis، الطبعة الثالثة، الفصل 2). ولأن هذه المعاملات أعداد صحيحة، فلاحتمال أن يكون معدل B أعلى مجموعٌ منتهٍ دقيق:
$$ P(p_B>p_A) = \sum_{i=0}^{\alpha_B-1} \frac{B(\alpha_A+i,\ \beta_A+\beta_B)}{(\beta_B+i)\,B(1+i,\ \beta_B)\,B(\alpha_A,\ \beta_A)} $$حيث \( \alpha = 1+x \) و\( \beta = 1+n-x \) و\( B \) هي دالة بيتا، وفق اشتقاق Evan Miller. تحسبه الحاسبة على مقياس لوغاريتمي، فلا يعتمد على سحب عشوائي ويعطي النتيجة نفسها في كل مرة. أما الخسارة المتوقعة عند اعتماد B، \( E[\max(p_A-p_B, 0)] \)، فتأتي من المجموع نفسه بمعاملات مُزاحة: إنها معدل التحويل الذي يُتوقع أن تخسره إذا كانت B في الواقع أسوأ. في المثال السابق P(B > A) = 97.08%، والخسارة المتوقعة عند اعتماد B هي 0.0036 نقطة مئوية. عبارتا «أفضل باحتمال 97%» و«غير دالّ عند 5%» تجيبان عن سؤالين مختلفين، ولا تبرر أيٌّ منهما إيقاف الاختبار مبكرًا.
لماذا يفسد التلصص على النتائج اختبارًا بأفق ثابت
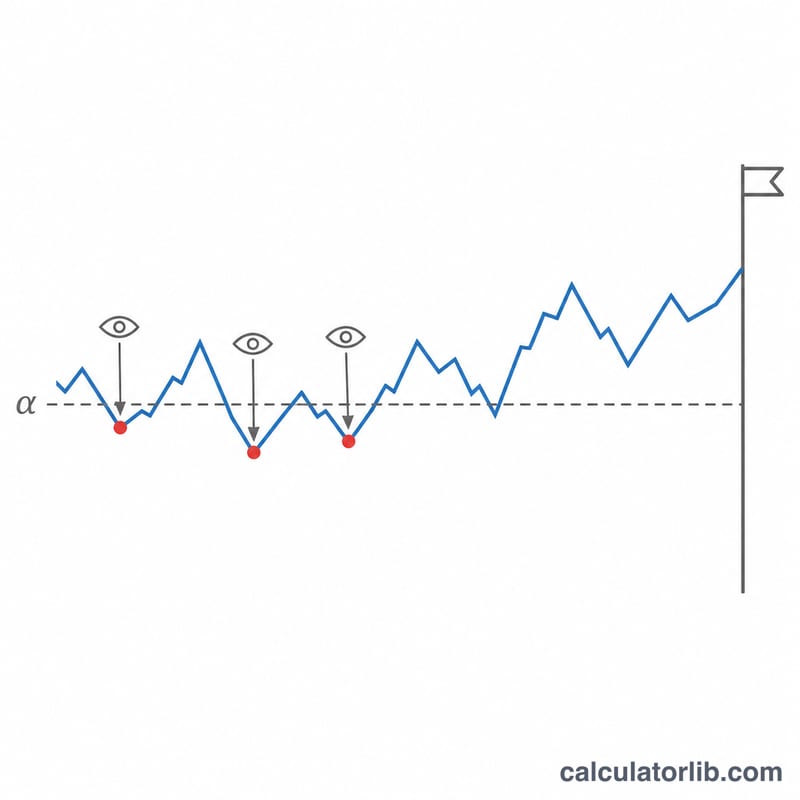
يفترض حجم العينة أعلاه أنك تنظر إلى البيانات مرة واحدة في النهاية. إذا فحصتها بعد كل دفعة وتوقفت عند أول p < 0.05، فكل فحص فرصة أخرى لإيجابية كاذبة. وكان Armitage وMcPherson وRowe (1969) أول من قاس هذا الأثر. فيما يلي القيم التي حسبناها بالتكامل العددي الدقيق للتوزيع الطبيعي المشترك لإحصاءات الاختبار، لاختبار ثنائي الطرف عند 5% مع فحوص متساوية التباعد ومن دون فرق حقيقي:
| عدد مرات فحص البيانات | احتمال اختيار فائز زائف |
|---|---|
| 1 | 5.0% |
| 2 | 8.3% |
| 3 | 10.7% |
| 5 | 14.2% |
| 10 | 19.3% |
| 20 | 24.8% |
إذا احتجت إلى مراقبة الاختبار أثناء تشغيله، فاستخدم تصميمًا معدًّا لذلك. الحدود التتابعية الجماعية مثل حدود O'Brien وFleming (1979) تنفق قدرًا ضئيلًا جدًا من α في الفحوص المبكرة وتحافظ على المعدل الكلي للإيجابيات الكاذبة عند α. ويسمح أسلوب إنفاق ألفا لـ Lan وDeMets (1983) بالفحص في أوقات لم تُحدَّد مسبقًا. أما الاستدلال الصالح دائمًا القائم على اختبار نسبة الاحتمال التتابعي المختلط (mSPRT؛ Johari وKoomen وPekelis وWalsh) فيعطي قيمًا احتمالية يمكنك فحصها في أي لحظة. وفي المقابل تحتاج جميعها إلى عينة قصوى أكبر من الاختبار بأفق ثابت.
الافتراضات والحدود
تفترض المعادلات استقلال الزوار، وثبات معدل التحويل طوال الاختبار، وتوزيعًا عشوائيًا عادلًا. شغّل الاختبار أسابيع كاملة لتغطية أنماط أيام الأسبوع، وتحقق من أن توزيع الزيارات يطابق الخطة، واحسب كل زائر مرة واحدة. مع العينات الصغيرة جدًا أو المعدلات القريبة من 0% أو 100% يصبح التقريب الطبيعي تقريبيًا جدًا، والاختبار الدقيق أكثر أمانًا حينها.
أدوات ذات صلة
هل انتهى اختبارك؟ تتحقق حاسبة الدلالة الإحصائية لاختبار A/B مما إذا كان الفرق بين معدلَي التحويل دالًا إحصائيًا، مع درجة Z والقيمة الاحتمالية.
هل تُعدّ استبيانًا؟ تحسب لك حاسبة حجم العينة عدد الإجابات اللازمة لمستوى ثقة وهامش خطأ محددين.