Công cụ này làm được gì
Công cụ trả lời ba câu hỏi của mọi thử nghiệm tỷ lệ chuyển đổi. Lập kế hoạch cho biết mỗi phiên bản cần bao nhiêu lượt truy cập để phát hiện mức tăng bạn chọn và mất bao nhiêu ngày với lưu lượng hiện có. Cỡ mẫu cố định làm theo chiều ngược lại: với số lượt truy cập bạn đã có, công cụ cho biết độ mạnh để phát hiện hiệu ứng của bạn và hiệu ứng nhỏ nhất có thể phát hiện ở độ mạnh mục tiêu. Phân tích kết quả nhận số chuyển đổi và lượt truy cập của A và B, trả về mức tăng quan sát được, p-value của kiểm định z hai tỷ lệ kèm khoảng tin cậy, và xác suất Bayes để B tốt hơn A — tất cả tính chính xác, không dùng mô phỏng ngẫu nhiên.
Trang mở sẵn số liệu ví dụ: tỷ lệ hiện tại 5%, MDE tương đối 10%, α = 5% hai phía và độ mạnh 80%. Hãy thay bằng số liệu của bạn.
Công thức cỡ mẫu
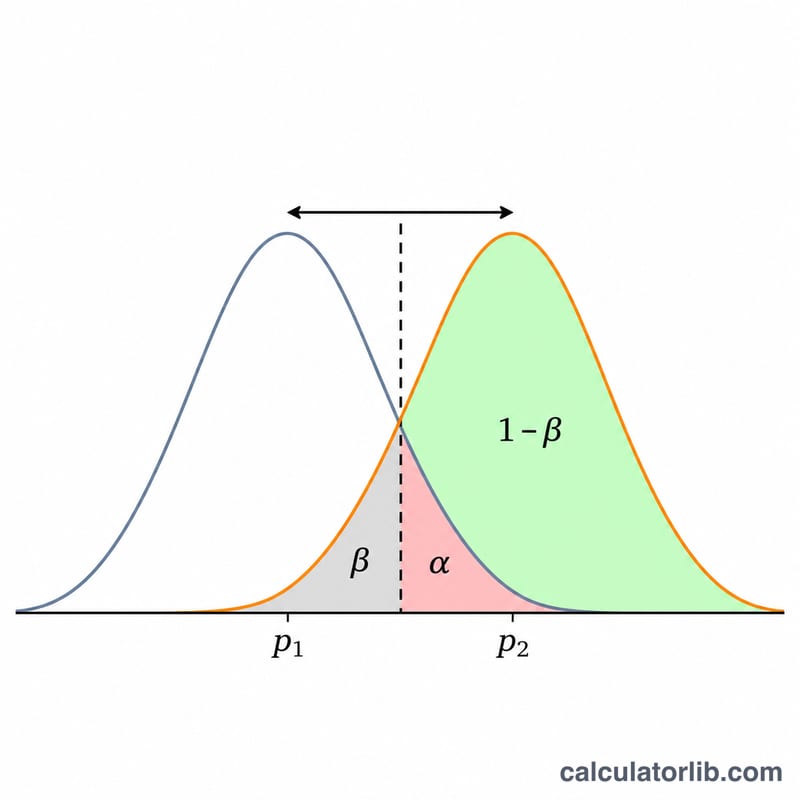
Với hai nhóm bằng nhau có tỷ lệ chuyển đổi \( p_1 \) (bản gốc) và \( p_2 \) (biến thể), số lượt truy cập cần cho mỗi nhóm là
$$ n = \frac{\left( z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} + z_{1-\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2-p_1)^2}, \qquad \bar p = \frac{p_1+p_2}{2} $$trong đó \( s = 2 \) với kiểm định hai phía và \( s = 1 \) với kiểm định một phía, còn \( z \) là phân vị của phân phối chuẩn tắc. Đây là công thức 4.14 trong sách của Fleiss, Levin và Paik, Statistical Methods for Rates and Proportions (tái bản lần 3, 2003): độ lệch chuẩn dưới giả thuyết không dùng tỷ lệ gộp \( \bar p \), dưới giả thuyết đối dùng riêng từng tỷ lệ. Đây cũng là xấp xỉ chuẩn của kiểm định z gộp mà bạn chạy khi kết thúc, nên kế hoạch và phân tích khớp nhau. Kết quả được làm tròn lên thành số nguyên.
Bảng kết quả còn có cỡ mẫu với hiệu chỉnh liên tục của Fleiss, Tytun và Ury (1980), \( n_{cc} = \frac{n}{4}\left(1+\sqrt{1+\frac{4}{n\,|p_2-p_1|} }\right)^2 \). Các bảng tra trong sách thường in con số lớn hơn, thận trọng hơn này.
Ví dụ có thể tự kiểm tra
Fleiss, Levin và Paik, trang 74: \( p_1 = 0{,}60 \), \( p_2 = 0{,}70 \), α = 1% hai phía, độ mạnh 95%. Công thức cho 807,07, tức 808 mỗi nhóm, và 827 khi có hiệu chỉnh liên tục — đúng số in trong sách. Với độ mạnh 75%, kết quả là 479,6 (480), và 499,4 khi hiệu chỉnh: sách in 499, công cụ làm tròn lên 500. Để tái hiện, chọn kiểu hiệu ứng tuyệt đối, tỷ lệ hiện tại 60 và hiệu ứng 10.
Ryan (2013), được kiểm chứng trong tài liệu NCSS PASS: α = 5% một phía, độ mạnh 80%, 55% so với 65% → 295,7, tức 296 mỗi nhóm.
Ví dụ mặc định: tỷ lệ hiện tại 5% và mức tăng tương đối 10% nghĩa là cần phân biệt 5,5% với 5%. Với α = 5% hai phía và độ mạnh 80%, cần 31.234 lượt truy cập mỗi phiên bản, tổng 62.468, tức 32 ngày nếu mỗi ngày có 2.000 lượt.
MDE tương đối hay tuyệt đối
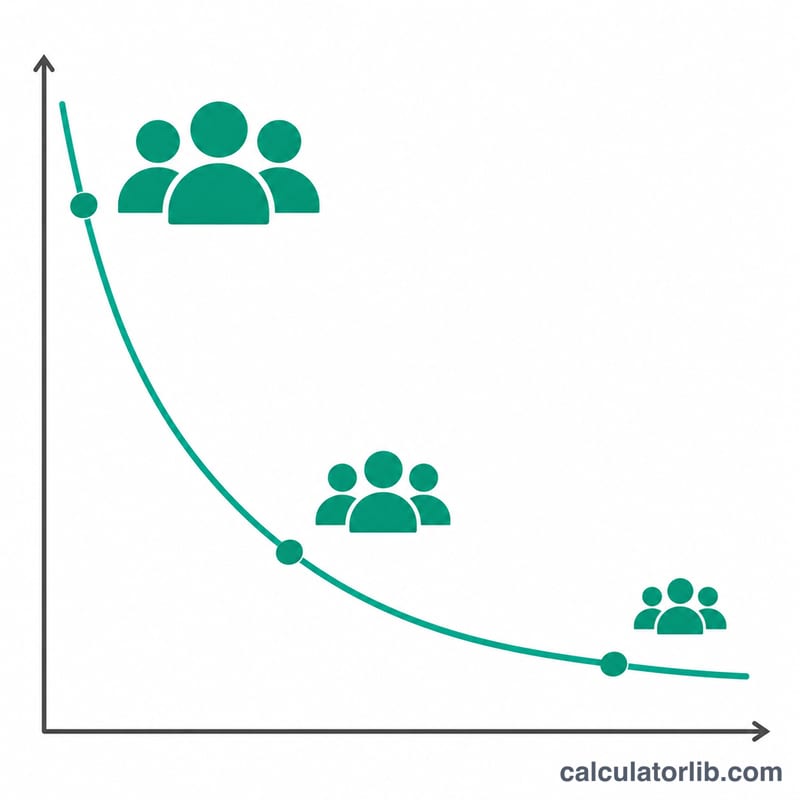
Hiệu ứng tương đối 10% trên nền 5% nghĩa là 5,5% (\( p_2 = p_1(1+\text{MDE}) \)). Hiệu ứng tuyệt đối 1 điểm phần trăm nghĩa là 6% (\( p_2 = p_1 + \text{MDE} \)). Giảm hiệu ứng đi một nửa thì cỡ mẫu tăng khoảng bốn lần, vì \( n \) tỷ lệ với \( 1/(p_2-p_1)^2 \). Tỷ lệ nền thấp rất tốn mẫu: cùng mức tăng tương đối trên nền 1% cần khoảng gấp năm lần số lượt so với nền 5%.
Nhiều phiên bản và hiệu chỉnh Bonferroni
Với \( k \) phiên bản kể cả bản gốc, mỗi biến thể trong \( k-1 \) biến thể được so với bản gốc và mọi nhóm có cùng \( n \), nên tổng là \( k \cdot n \). Mỗi phép so sánh thêm là thêm một cơ hội chọn nhầm “người thắng”. Hiệu chỉnh Bonferroni (Dunn, 1961) kiểm định mỗi phép so sánh ở mức \( \alpha/(k-1) \), giữ xác suất có ít nhất một dương tính giả không vượt quá \( \alpha \). Cách này thận trọng và làm tăng \( n \) cho mọi nhóm.
Độ mạnh và MDE khi cỡ mẫu cố định
Giải cùng phương trình theo độ mạnh:
$$ 1-\beta = \Phi\!\left( \frac{|p_2-p_1|\sqrt{n} - z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} }{\sqrt{p_1(1-p_1)+p_2(1-p_2)} } \right) $$Công cụ tính giá trị này cho hiệu ứng của bạn rồi tìm mức tăng nhỏ nhất đạt độ mạnh mục tiêu. Dùng chế độ này khi lưu lượng đã cố định, chẳng hạn một chiến dịch chạy đúng hai tuần: nếu mức tăng phát hiện được lớn hơn nhiều so với mọi thay đổi thực tế, thử nghiệm sẽ khó cho bạn kết luận hữu ích.
Đọc kết quả: p-value và khoảng tin cậy
Với \( x_A \) chuyển đổi trên \( n_A \) lượt và \( x_B \) trên \( n_B \), thống kê z gộp là \( z = (\hat p_B-\hat p_A)/\sqrt{\hat p(1-\hat p)(1/n_A+1/n_B)} \) với \( \hat p = (x_A+x_B)/(n_A+n_B) \). P-value hai phía là \( 2(1-\Phi(|z|)) \); p-value một phía, cho giả thuyết B tốt hơn, là \( 1-\Phi(z) \). Khoảng tin cậy của chênh lệch dùng sai số chuẩn không gộp: \( (\hat p_B-\hat p_A) \pm z_{1-\alpha/2}\sqrt{\hat p_A(1-\hat p_A)/n_A+\hat p_B(1-\hat p_B)/n_B} \). Ví dụ: 500/10.000 so với 560/10.000 cho z = 1,894 và p = 0,0583, nên mức tăng quan sát 12% chưa có ý nghĩa ở mức 5%, và khoảng tin cậy 95% của B − A trải từ −0,02 đến +1,22 điểm phần trăm.
Xác suất Bayes để B tốt hơn A
Với tiên nghiệm đều Beta(1, 1), phân phối hậu nghiệm của tỷ lệ chuyển đổi sau \( x \) chuyển đổi trên \( n \) lượt là Beta(\( 1+x \), \( 1+n-x \)) (Gelman và cộng sự, Bayesian Data Analysis, tái bản lần 3, chương 2). Vì các tham số là số nguyên, xác suất tỷ lệ của B cao hơn có dạng tổng hữu hạn chính xác:
$$ P(p_B>p_A) = \sum_{i=0}^{\alpha_B-1} \frac{B(\alpha_A+i,\ \beta_A+\beta_B)}{(\beta_B+i)\,B(1+i,\ \beta_B)\,B(\alpha_A,\ \beta_A)} $$với \( \alpha = 1+x \), \( \beta = 1+n-x \) và \( B \) là hàm beta, theo cách dẫn của Evan Miller. Công cụ tính tổng này trong thang logarit nên không phụ thuộc vào rút mẫu ngẫu nhiên và luôn cho cùng một đáp số. Tổn thất kỳ vọng khi chọn B, \( E[\max(p_A-p_B, 0)] \), đến từ cùng tổng với tham số dịch đi: đó là phần tỷ lệ chuyển đổi bạn dự kiến mất nếu thực ra B kém hơn. Với ví dụ trên, P(B > A) = 97,08% và tổn thất kỳ vọng khi chọn B là 0,0036 điểm phần trăm. “97% khả năng tốt hơn” và “chưa có ý nghĩa ở mức 5%” trả lời hai câu hỏi khác nhau; không câu nào cho phép dừng thử nghiệm sớm.
Vì sao “nhìn trộm” làm hỏng thử nghiệm kỳ hạn cố định
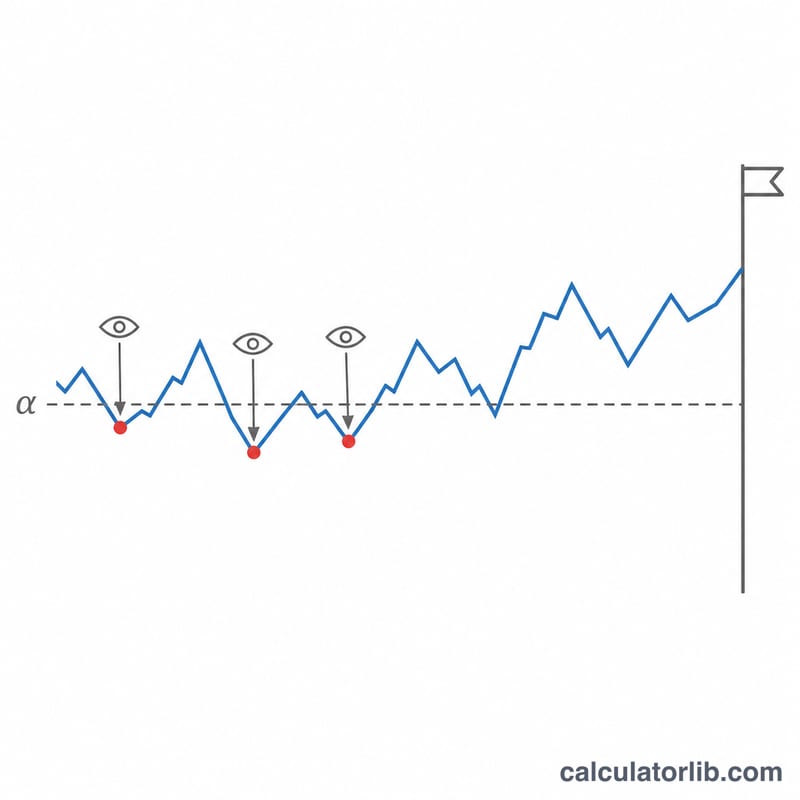
Cỡ mẫu ở trên giả định bạn chỉ xem dữ liệu một lần, khi kết thúc. Nếu xem sau mỗi đợt và dừng ngay khi p < 0,05, mỗi lần xem là thêm một cơ hội dương tính giả. Armitage, McPherson và Rowe (1969) là những người đầu tiên đo hiệu ứng này. Dưới đây là kết quả chúng tôi tính bằng tích phân số chính xác trên phân phối chuẩn đồng thời của các thống kê kiểm định, cho kiểm định hai phía 5% với các lần xem cách đều và không có khác biệt thật:
| Số lần xem dữ liệu | Xác suất chọn nhầm người thắng |
|---|---|
| 1 | 5,0% |
| 2 | 8,3% |
| 3 | 10,7% |
| 5 | 14,2% |
| 10 | 19,3% |
| 20 | 24,8% |
Nếu cần theo dõi khi thử nghiệm đang chạy, hãy dùng thiết kế dành cho việc đó. Biên tuần tự theo nhóm như O'Brien và Fleming (1979) chỉ “tiêu” rất ít α ở các lần xem sớm và giữ tỷ lệ dương tính giả tổng thể ở mức α. Cách chi tiêu alpha của Lan và DeMets (1983) cho phép xem ở những thời điểm không định trước. Suy luận luôn hợp lệ bằng kiểm định tỷ số xác suất tuần tự hỗn hợp (mSPRT; Johari, Koomen, Pekelis và Walsh) cho p-value có thể xem bất cứ lúc nào. Đổi lại, tất cả đều cần cỡ mẫu tối đa lớn hơn thử nghiệm kỳ hạn cố định.
Giả định và giới hạn
Các công thức giả định người truy cập độc lập, tỷ lệ chuyển đổi ổn định trong thời gian thử nghiệm và phân chia ngẫu nhiên công bằng. Hãy chạy trọn tuần để bao quát thói quen theo ngày trong tuần, kiểm tra tỷ lệ chia lưu lượng đúng như kế hoạch và chỉ đếm mỗi người một lần. Với mẫu rất nhỏ hoặc tỷ lệ gần 0% hay 100%, xấp xỉ chuẩn khá thô; khi đó nên dùng kiểm định chính xác.
Công cụ liên quan
Đã có kết quả thử nghiệm? Công cụ kiểm định ý nghĩa A/B test cho biết chênh lệch giữa hai tỷ lệ chuyển đổi có ý nghĩa thống kê hay không, kèm z-score và p-value.
Bạn đang làm khảo sát? Công cụ tính cỡ mẫu cho biết cần thu bao nhiêu phản hồi để đạt độ tin cậy và sai số mong muốn.