이 계산기로 할 수 있는 일
전환율 실험에서 늘 나오는 세 가지 질문에 답합니다. 테스트 계획은 원하는 상승을 검출하려면 변형마다 방문자가 몇 명 필요한지, 현재 트래픽으로 며칠이 걸리는지 알려 줍니다. 표본이 정해진 경우는 반대로, 이미 확보한 방문자 수로 입력한 효과를 검출할 검정력과 목표 검정력에서 검출할 수 있는 가장 작은 효과를 보여 줍니다. 결과 분석은 A와 B의 전환 수와 방문자 수로 관측된 상승률, 두 비율 z검정의 p값과 신뢰구간, 그리고 B가 A보다 좋을 베이즈 확률을 계산합니다. 모두 무작위 시뮬레이션 없이 정확하게 계산합니다.
처음 화면은 예시 값입니다: 현재 전환율 5%, 상대 MDE 10%, 양측 α = 5%, 검정력 80%. 실제 수치로 바꿔 입력하세요.
표본 크기 공식
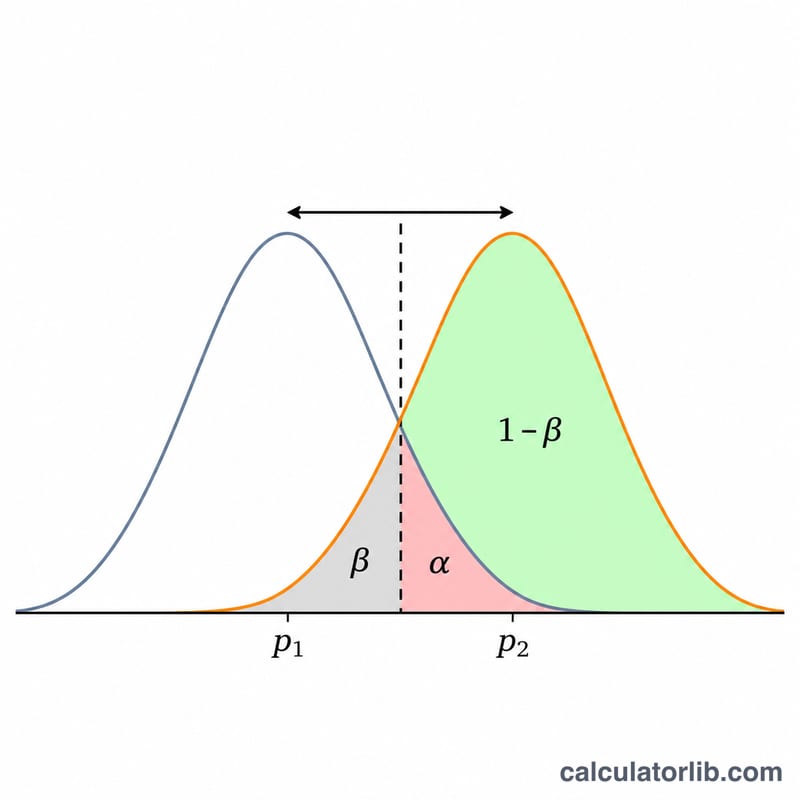
전환율이 \( p_1 \)(대조군)과 \( p_2 \)(실험군)인 같은 크기의 두 그룹에서 그룹당 필요한 방문자 수는
$$ n = \frac{\left( z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} + z_{1-\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2-p_1)^2}, \qquad \bar p = \frac{p_1+p_2}{2} $$입니다. 양측 검정이면 \( s = 2 \), 단측 검정이면 \( s = 1 \)이고 \( z \)는 표준정규분포의 분위수입니다. Fleiss, Levin, Paik의 Statistical Methods for Rates and Proportions(3판, 2003) 식 4.14로, 귀무가설에서의 표준편차는 합동 비율 \( \bar p \)를, 대립가설에서는 각 비율을 따로 씁니다. 마지막에 수행하는 합동 z검정과 같은 정규 근사이므로 계획과 분석이 일치합니다. 결과는 정수로 올림합니다.
표에는 Fleiss, Tytun, Ury(1980)의 연속성 보정을 적용한 크기 \( n_{cc} = \frac{n}{4}\left(1+\sqrt{1+\frac{4}{n\,|p_2-p_1|} }\right)^2 \)도 표시합니다. 교과서 표에는 이처럼 더 크고 보수적인 값이 실린 경우가 많습니다.
직접 확인할 수 있는 예시
Fleiss, Levin, Paik 74쪽: \( p_1 = 0.60 \), \( p_2 = 0.70 \), 양측 α = 1%, 검정력 95%. 공식 값은 807.07로 그룹당 808명이고, 연속성 보정을 적용하면 책에 실린 827명이 됩니다. 검정력 75%에서는 479.6(480)명, 보정 시 499.4명입니다. 책에는 499명으로 실려 있고, 이 계산기는 올림해 500명으로 표시합니다. 재현하려면 효과 측정 방식을 절대 변화로 고르고 현재 전환율 60, 효과 10을 입력하세요.
Ryan(2013), NCSS PASS 매뉴얼의 검증 예시: 단측 α = 5%, 검정력 80%, 55% 대 65% → 295.7, 즉 그룹당 296명.
기본 예시: 현재 전환율 5%에서 상대 10% 상승은 5%와 5.5%를 구분하는 것입니다. 양측 α = 5%, 검정력 80%이면 변형당 31,234명, 총 62,468명이 필요하고, 하루 2,000명이면 32일이 걸립니다.
상대 MDE와 절대 MDE
5%에 대한 상대 10% 효과는 5.5%를 뜻합니다(\( p_2 = p_1(1+\text{MDE}) \)). 절대 1%p 효과는 6%입니다(\( p_2 = p_1 + \text{MDE} \)). \( n \)은 \( 1/(p_2-p_1)^2 \)에 비례하므로 효과를 절반으로 줄이면 표본은 약 4배가 됩니다. 기준 전환율이 낮을수록 비용이 큽니다. 같은 상대 상승이라도 1% 전환율에서는 5% 전환율보다 약 5배의 방문자가 필요합니다.
여러 변형과 본페로니 보정
대조군을 포함해 변형이 \( k \)개이면 \( k-1 \)개의 실험군을 각각 대조군과 비교하고 모든 그룹에 같은 \( n \)을 배정하므로 총합은 \( k \cdot n \)입니다. 비교가 하나 늘 때마다 잘못된 승자를 고를 기회도 늘어납니다. 본페로니 보정(Dunn, 1961)은 각 비교를 \( \alpha/(k-1) \)로 검정해 위양성이 하나라도 나올 확률을 \( \alpha \) 이하로 유지합니다. 보수적인 방법이라 모든 그룹의 \( n \)이 커집니다.
표본이 정해진 경우의 검정력과 MDE
같은 식을 검정력에 대해 풀면 다음과 같습니다.
$$ 1-\beta = \Phi\!\left( \frac{|p_2-p_1|\sqrt{n} - z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} }{\sqrt{p_1(1-p_1)+p_2(1-p_2)} } \right) $$입력한 효과에 대해 이 값을 계산한 뒤, 목표 검정력에 도달하는 가장 작은 상승을 찾습니다. 결과와 상관없이 2주 동안만 진행하는 캠페인처럼 트래픽이 정해져 있을 때 사용하세요. 검출 가능한 상승이 현실적인 변화보다 훨씬 크다면 그 테스트로 알 수 있는 것은 많지 않습니다.
결과 읽기: p값과 신뢰구간
\( n_A \)명 중 \( x_A \)건, \( n_B \)명 중 \( x_B \)건이 전환되었을 때 합동 z 통계량은 \( z = (\hat p_B-\hat p_A)/\sqrt{\hat p(1-\hat p)(1/n_A+1/n_B)} \)이고, 여기서 \( \hat p = (x_A+x_B)/(n_A+n_B) \)입니다. 양측 p값은 \( 2(1-\Phi(|z|)) \), B가 더 좋다는 가설에 대한 단측 p값은 \( 1-\Phi(z) \)입니다. 차이의 신뢰구간은 합동하지 않은 표준오차를 씁니다: \( (\hat p_B-\hat p_A) \pm z_{1-\alpha/2}\sqrt{\hat p_A(1-\hat p_A)/n_A+\hat p_B(1-\hat p_B)/n_B} \). 예: 10,000명 중 500건과 10,000명 중 560건이면 z = 1.894, p = 0.0583으로, 관측된 12% 상승은 5% 수준에서 유의하지 않으며 B − A의 95% 신뢰구간은 −0.02~+1.22%p입니다.
B가 A보다 좋을 베이즈 확률
균등 사전분포 Beta(1, 1)에서 \( n \)명 중 \( x \)건 전환 후 전환율의 사후분포는 Beta(\( 1+x \), \( 1+n-x \))입니다(Gelman 외, Bayesian Data Analysis 3판, 2장). 모수가 정수이므로 B의 전환율이 더 높을 확률은 정확한 유한합으로 표현됩니다.
$$ P(p_B>p_A) = \sum_{i=0}^{\alpha_B-1} \frac{B(\alpha_A+i,\ \beta_A+\beta_B)}{(\beta_B+i)\,B(1+i,\ \beta_B)\,B(\alpha_A,\ \beta_A)} $$여기서 \( \alpha = 1+x \), \( \beta = 1+n-x \), \( B \)는 베타 함수이며 Evan Miller의 유도를 따릅니다. 로그 공간에서 계산하므로 난수에 의존하지 않고 매번 같은 답을 냅니다. B를 채택할 때의 기대 손실 \( E[\max(p_A-p_B, 0)] \)은 모수를 옮긴 같은 합으로 구합니다. 실제로는 B가 더 나쁠 경우 잃을 것으로 예상되는 전환율입니다. 위 예시에서 P(B > A) = 97.08%, B를 채택할 때의 기대 손실은 0.0036%p입니다. "97% 확률로 더 좋다"와 "5% 수준에서 유의하지 않다"는 서로 다른 질문의 답이며, 어느 쪽도 테스트를 일찍 멈춰도 된다는 뜻은 아닙니다.
중간에 결과를 들여다보면 고정 기간 테스트가 깨지는 이유
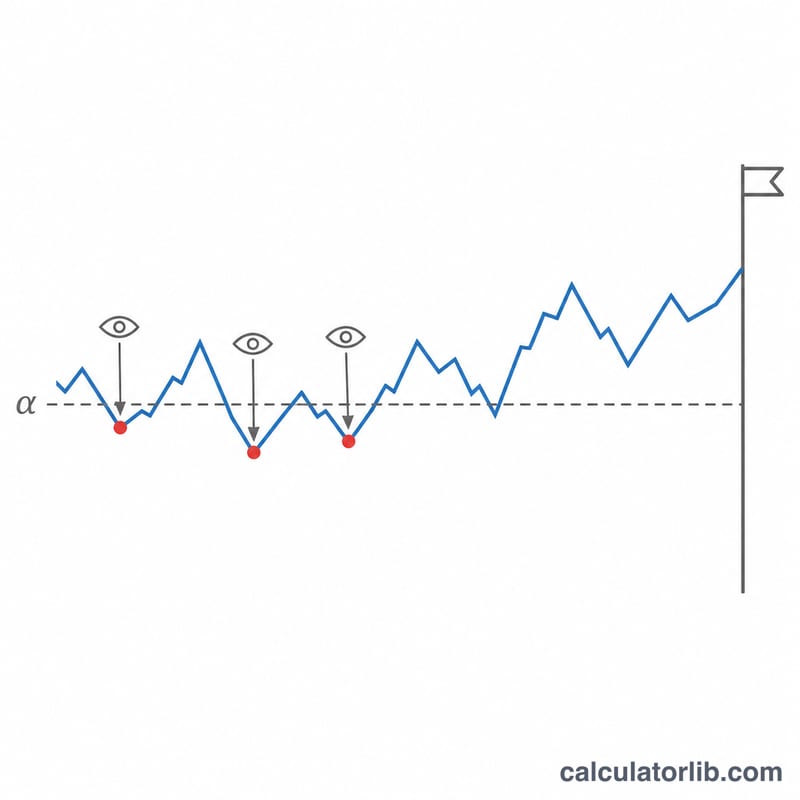
위의 표본 크기는 마지막에 한 번만 데이터를 본다고 가정합니다. 배치마다 확인하다가 처음 p < 0.05가 나올 때 멈추면 확인할 때마다 위양성 기회가 늘어납니다. 이 효과를 처음 측정한 것은 Armitage, McPherson, Rowe(1969)입니다. 아래는 검정 통계량의 결합 정규분포를 수치 적분으로 정확히 계산한 값입니다(양측 5% 검정, 같은 간격의 확인, 실제 차이 없음).
| 데이터 확인 횟수 | 잘못된 승자를 고를 확률 |
|---|---|
| 1 | 5.0% |
| 2 | 8.3% |
| 3 | 10.7% |
| 5 | 14.2% |
| 10 | 19.3% |
| 20 | 24.8% |
진행 중에 모니터링해야 한다면 그 목적에 맞는 설계를 쓰세요. O'Brien과 Fleming(1979) 같은 군 순차 경계는 초기 확인에서 α를 아주 조금만 쓰면서 전체 위양성률을 α로 유지합니다. Lan과 DeMets(1983)의 알파 소비 방식은 미리 정하지 않은 시점에도 확인할 수 있게 해 줍니다. 혼합 순차 확률비 검정(mSPRT; Johari, Koomen, Pekelis, Walsh)을 이용한 항상 유효한 추론은 언제 확인해도 유효한 p값을 줍니다. 대신 모두 고정 기간 테스트보다 큰 최대 표본이 필요합니다.
가정과 한계
공식은 방문자가 서로 독립이고, 테스트 기간 동안 전환율이 안정적이며, 공정하게 무작위 배정된다고 가정합니다. 요일 패턴을 고르게 반영하도록 주 단위로 진행하고, 트래픽 배분이 계획과 같은지 확인하며, 방문자는 한 번만 세세요. 표본이 아주 작거나 전환율이 0%나 100%에 가까우면 정규 근사가 거칠어지므로 정확 검정이 더 안전합니다.
함께 보면 좋은 계산기
테스트가 끝났다면 A/B 테스트 유의성 계산기로 두 전환율의 차이가 통계적으로 유의한지 Z값과 p값으로 확인해 보세요.
설문조사를 준비 중이라면 표본 크기 계산기로 원하는 신뢰수준과 오차범위에 필요한 응답 수를 계산할 수 있습니다.