이 계산기는 무엇을 하나요?
이 계산기는 모집단 비율을 원하는 오차범위 이내에서, 설정한 신뢰수준으로 추정하려면 몇 명을 조사해야 하는지 알려줍니다. 시장조사, 여론조사(정치 여론조사), 품질관리, 학술 설문 등 다양한 분야에서 폭넓게 활용됩니다. 이 도구는 특정 국가에 종속되지 않습니다. 순수한 통계 공식을 기반으로 하므로 어느 나라에서나 동일하게 적용할 수 있습니다.
사용 방법
먼저 신뢰수준(90%, 95%, 99%)을 선택하세요. 그다음 허용할 수 있는 오차범위(예: 5%)를 입력하고, 예상 비율을 넣습니다. 사전에 추정할 만한 값이 없다면 50%를 사용하세요. 50%는 가장 보수적인 값으로, 가장 크고 안전한 표본 크기를 산출합니다. 전체 모집단 크기를 알고 있다면 추가로 입력해 유한모집단 보정을 적용할 수 있는데, 모집단이 작을 때 필요한 표본 수를 줄여 줍니다.
공식 설명
핵심 공식은 다음과 같습니다.
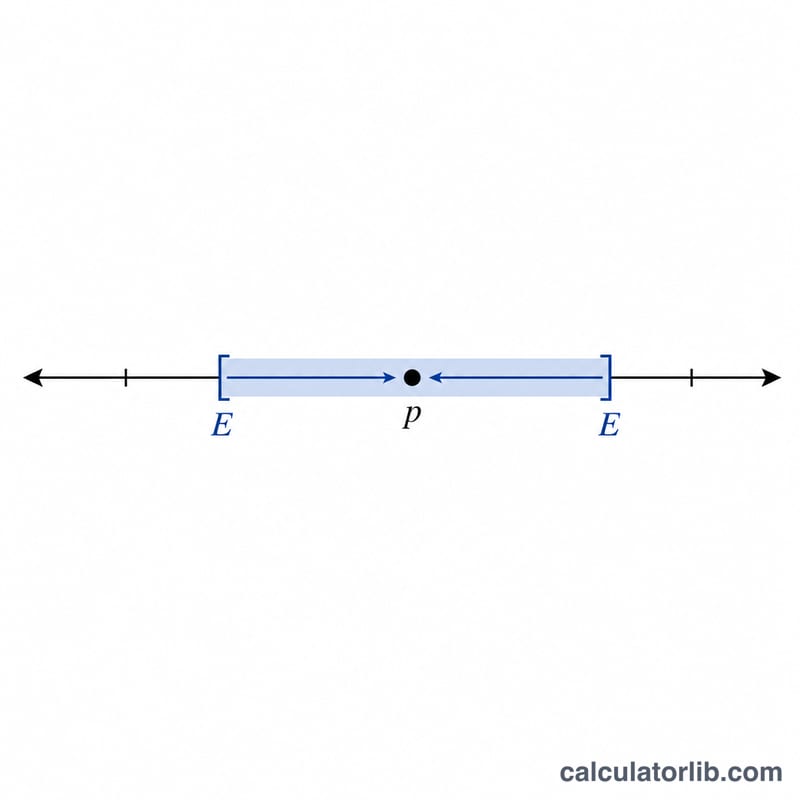
$$n = \dfrac{z^2 \cdot \hat{p}\,(1 - \hat{p})}{E^2}$$여기서 \(z\)는 신뢰수준에 해당하는 표준정규분포의 임계값(90%일 때 1.645, 95%일 때 1.96, 99%일 때 2.576)이고, \(\hat{p}\)는 소수로 나타낸 예상 비율, \(E\)는 소수로 나타낸 오차범위입니다. \(\hat{p}(1 - \hat{p})\) 항은 \(\hat{p} = 0.5\)일 때 가장 커지므로, 50%에서 표본 크기가 최대가 됩니다. 유한모집단 \(N\)이 주어지면 보정계수를 적용해 결과를 줄여 줍니다. 즉
$$n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}$$입니다.
계산 예시
95% 신뢰수준(\(z = 1.96\)), 5% 오차범위(\(E = 0.05\)), 그리고 \(\hat{p} = 0.5\)를 가정한다고 해 봅시다. 그러면
$$n = \dfrac{1.96^2 \times 0.5 \times 0.5}{0.05^2} = \dfrac{3.8416 \times 0.25}{0.0025} = \dfrac{0.9604}{0.0025} = 384.16$$이 되고, 올림하면 385명의 응답자가 필요합니다.
신뢰수준별 Z-점수 임계값
| 양측 신뢰수준 | 임계값 z |
|---|---|
| 80% | 1.282 |
| 85% | 1.440 |
| 90% | 1.645 |
| 95% | 1.960 |
| 98% | 2.326 |
| 99% | 2.576 |
| 99.9% | 3.291 |
이 값들은 확률 \(1 - \alpha/2\)에서의 표준정규분포 분위수입니다. 여기서 \(\alpha = 1 - \text{신뢰수준}\)입니다. 95% 신뢰수준의 경우 \(\alpha = 0.05\)이므로, z는 표준정규분포의 97.5 백분위수이며 약 1.960입니다.
필요 표본 크기 해석하기
- 오차 한계가 다루는 내용: 이 공식은 단순 무작위 표본을 가정하고, 주어진 신뢰수준에서 단일 비율을 추정합니다. 이는 무작위 표본추출 오차만을 반영합니다. 무응답, 포괄 범위 문제, 표본 편향은 고려하지 않으므로, 이 숫자는 발송한 초대장 수가 아니라 필요한 완료된 유효 응답의 수입니다. 응답률이 20%로 예상된다면, n보다 훨씬 많은 사람에게 초대장을 보내야 합니다.
- 95% 신뢰수준의 의미: 설문을 여러 번 반복하면서 매번 이 방법으로 구간을 만든다면, 그 구간들의 약 95%가 실제 모집단 비율을 포함할 것입니다. 이는 특정하게 계산된 한 구간에 실제 값이 들어있을 확률이 95%라는 뜻이 아닙니다.
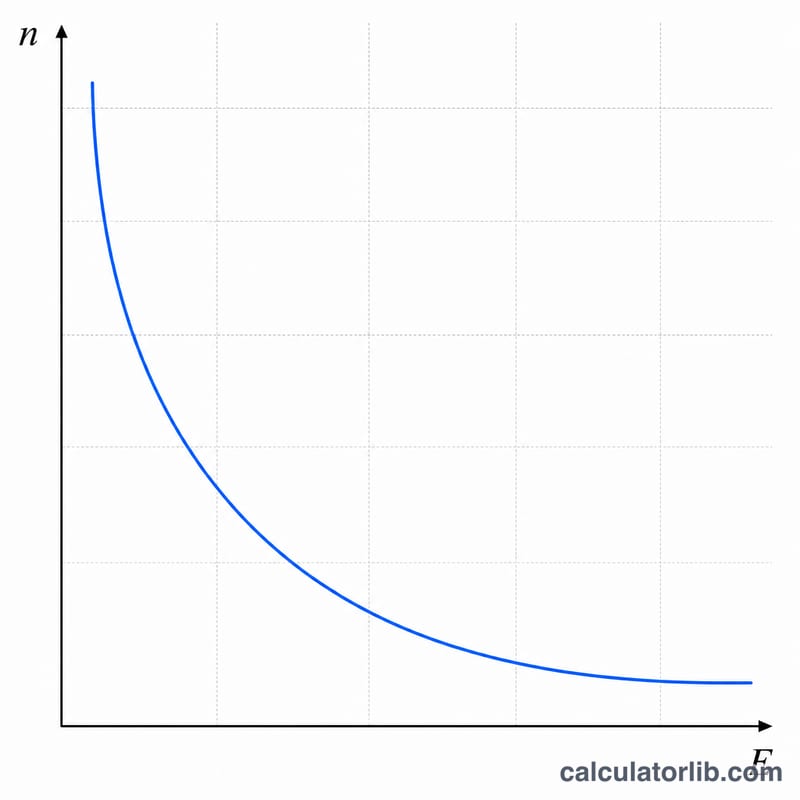
- 체감 수익: n은 \(1/E^2\)에 비례하여 증가하므로, 오차 한계를 줄이는 비용은 빠르게 커집니다. 95% 신뢰수준에서 5%에서 3%로 줄이면 n이 385에서 1,068로 늘어나는 반면, 10%에서 5%로 줄이면 응답이 약 288개만 추가됩니다.
- p의 선택: \(\hat{p} = 0.5\)일 때 \(\hat{p}(1-\hat{p})\)가 최대가 되어 가장 크고 가장 안전한 n을 얻습니다. 신뢰할 만한 사전 추정값이 있을 때에만 다른 값을 사용하십시오.
- 유한 모집단 보정: \(n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}\) 조정은 주로 \(n_0\)이 모집단 크기 N의 약 5%를 넘을 때 중요합니다. 대규모 모집단에서는 거의 변화가 없으며, 소규모 모집단에서는 필요한 표본 크기를 눈에 띄게 줄일 수 있습니다.
- 하위집단: 오차 한계는 전체 표본에 적용됩니다. 하위집단(예: 연령 또는 지역별) 결과는 각 하위집단이 충분한 표본 크기를 개별적으로 갖추지 않는 한 오차 한계가 더 큽니다.
자주 묻는 질문
추정값이 전혀 없을 때는 어떤 비율을 써야 하나요? 50%를 사용하세요. 필요한 표본 크기를 최대로 만들어, 목표한 오차범위가 반드시 충족되도록 보장합니다.
왜 올림을 하나요? 표본 크기는 정수여야 하며, 올림을 해야 오차범위가 초과되지 않기 때문입니다.
모집단 크기는 언제 중요한가요? 유한모집단 보정은 모집단이 \(n_0\)에 비해 작을 때(예: 수천 명 이하)에만 표본 수를 의미 있게 줄여 줍니다.