这个计算器有什么用
这个工具能告诉你:要在指定的置信水平下,把总体比例的估计误差控制在某个范围内,到底需要调查多少人。它在市场调研、民意调查、质量控制和学术问卷中都很常用。该计算器与国家或地区无关——它纯粹是统计学原理,放在任何地方都适用。
使用方法
先选定置信水平(90%、95% 或 99%),再填入你能接受的误差幅度(例如 5%),然后给出一个预估比例。如果你心里没底、没有任何先验估计,就填 50%——这是最保守的取值,会得出最大、最稳妥的样本量。如果你知道总体的总人数,也可以填进去,从而启用「有限总体校正」,在总体规模较小时减少所需样本量。
公式详解
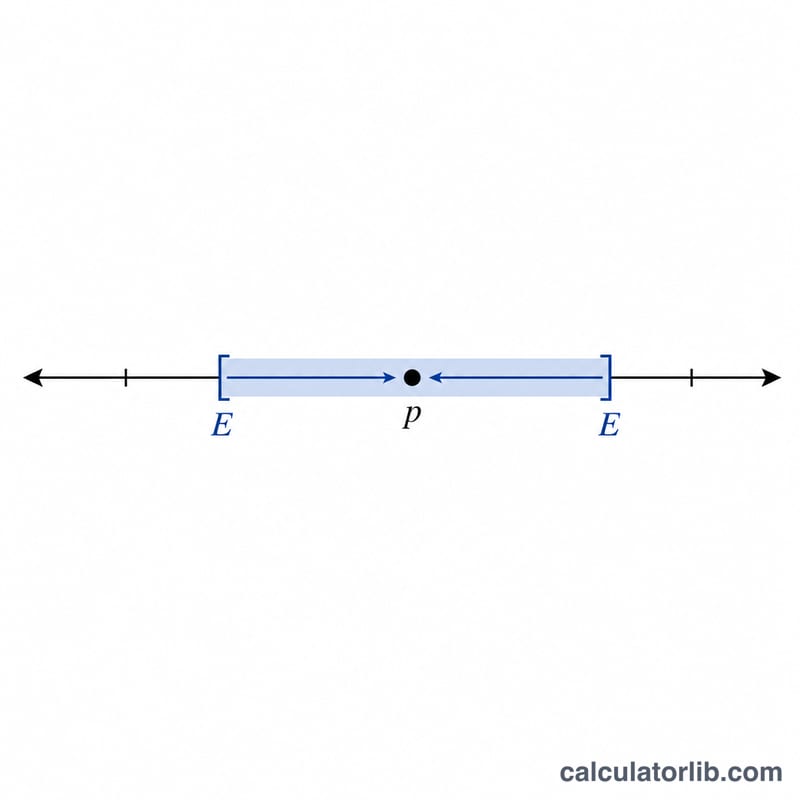
核心公式为 $$n = \dfrac{z^2 \cdot \hat{p}\,(1 - \hat{p})}{e^2}$$。其中 \(z\) 是对应置信水平的标准正态临界值(90% 取 1.645,95% 取 1.96,99% 取 2.576),\(p\) 是以小数表示的预期比例,\(E\) 是以小数表示的误差幅度。\(p(1 - p)\) 这一项在 \(p = 0.5\) 时取得最大值,这正是为什么 50% 会对应最大样本量。当你提供了有限总体规模 \(N\) 时,结果会再乘以校正系数缩小:$$n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}$$
实例演算
假设你希望达到 95% 的置信水平(\(z = 1.96\))、误差幅度为 5%(\(E = 0.05\)),并假定 \(p = 0.5\)。那么 $$n = \dfrac{1.96^2 \times 0.5 \times 0.5}{0.05^2} = \dfrac{3.8416 \times 0.25}{0.0025} = \dfrac{0.9604}{0.0025} = 384.16$$,向上取整后为 385 名受访者。
按置信水平划分的 Z 分数临界值
| 双侧置信水平 | 临界值 z |
|---|---|
| 80% | 1.282 |
| 85% | 1.440 |
| 90% | 1.645 |
| 95% | 1.960 |
| 98% | 2.326 |
| 99% | 2.576 |
| 99.9% | 3.291 |
这些是概率为 \(1 - \alpha/2\) 时的标准正态分位数,其中 \(\alpha = 1 - \text{置信水平}\)。对于 95% 的置信水平,\(\alpha = 0.05\),因此 z 为标准正态分布的第 97.5 百分位数,约为 1.960。
解读所需样本量
- 误差范围涵盖的内容:该公式假设采用简单随机抽样,并在给定置信水平下估计单一比例。它只反映随机抽样误差。它没有考虑无应答、覆盖范围问题或抽样偏差,因此这里的数字是你需要的已完成且有效的回复数,而不是发出的邀请数。如果你预计回复率为 20%,则需要邀请远多于 n 的人数。
- 95% 置信水平的含义:如果你多次重复调查,并每次都用该方法构建一个区间,那么大约 95% 的区间会包含真实的总体比例。这并不意味着真实值落在某一个具体计算出的区间内的概率是 95%。
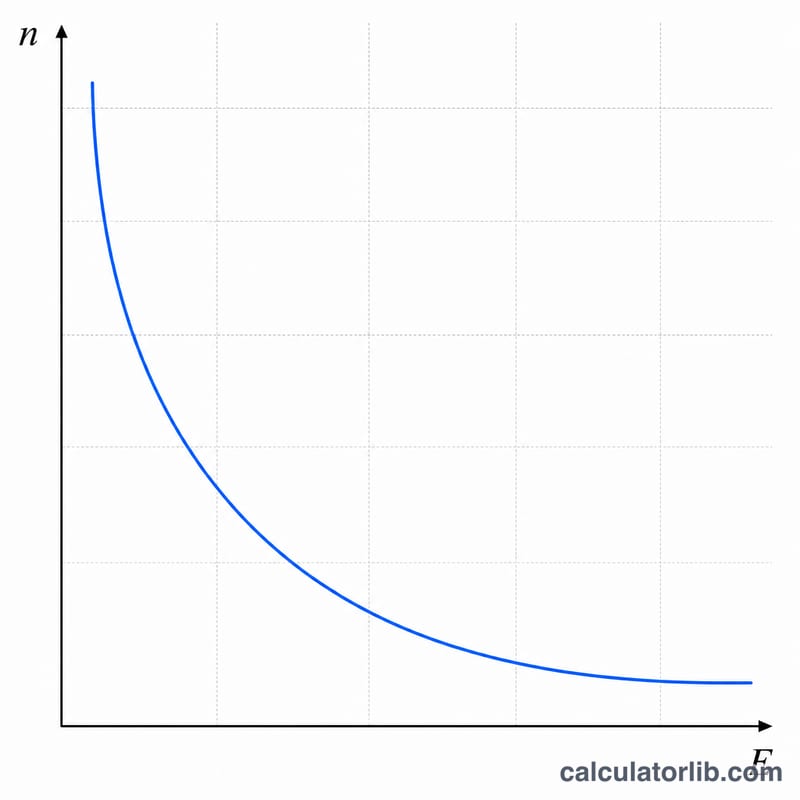
- 收益递减:n 随 \(1/E^2\) 增长,因此收窄误差范围的成本会迅速上升。在 95% 置信水平下,将误差从 5% 降至 3%,会使 n 从 385 增至 1,068;而将误差从 10% 降至 5%,只需额外增加约 288 份回复。
- p 的选择:\(\hat{p} = 0.5\) 使 \(\hat{p}(1-\hat{p})\) 最大化,并给出最大、最稳妥的 n。只有在你拥有可靠的先验估计时,才使用其他值。
- 有限总体校正:调整公式 \(n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}\) 主要在 \(n_0\) 超过总体规模 N 的约 5% 时起作用。对于大型总体,它几乎没有影响;对于小型总体,它可能会显著降低所需样本量。
- 子群体:误差范围适用于整个样本。子群体(例如按年龄或地区划分)的结果误差范围更大,除非每个子群体都有各自足够的样本量。
常见问题
没有任何预估比例时该填多少?填 50%——它会让所需样本量达到最大,从而保证实际误差不会超过你设定的目标。
为什么要向上取整?样本量必须是整数,而向上取整能确保误差幅度不会被突破。
总体规模在什么时候才重要?只有当总体相对于 \(n_0\) 较小(例如几千人或更少)时,有限总体校正才会明显减少所需样本量;总体很大时这一校正几乎可以忽略。