यह कैलकुलेटर क्या करता है
यह कैलकुलेटर बताता है कि किसी आबादी के किसी अनुपात (प्रोपोर्शन) का अनुमान, तय मार्जिन ऑफ एरर और कॉन्फ़िडेंस लेवल के भीतर लगाने के लिए आपको कितने लोगों का सर्वे करना होगा। इसका इस्तेमाल मार्केट रिसर्च, चुनावी सर्वे (ओपिनियन पोल), क्वालिटी कंट्रोल और अकादमिक अध्ययनों में बड़े पैमाने पर होता है। यह टूल किसी देश या क़ानून से बंधा नहीं है — यह शुद्ध आँकड़ाशास्त्र (स्टैटिस्टिक्स) है और हर जगह समान रूप से लागू होता है।
इसका इस्तेमाल कैसे करें
अपना कॉन्फ़िडेंस लेवल चुनें (90%, 95% या 99%), जितना मार्जिन ऑफ एरर आप सह सकते हैं वह दर्ज करें (जैसे 5%), और एक अनुमानित अनुपात भरें। अगर आपके पास पहले से कोई अनुमान नहीं है, तो 50% का इस्तेमाल करें — यह सबसे सुरक्षित (कन्ज़र्वेटिव) मान है और इससे सबसे बड़ा, सबसे भरोसेमंद सैंपल निकलता है। चाहें तो अपनी कुल आबादी का आकार भी दर्ज करें ताकि फ़ाइनाइट पॉपुलेशन करेक्शन लागू हो सके, जो आबादी छोटी होने पर ज़रूरी सैंपल को घटा देता है।
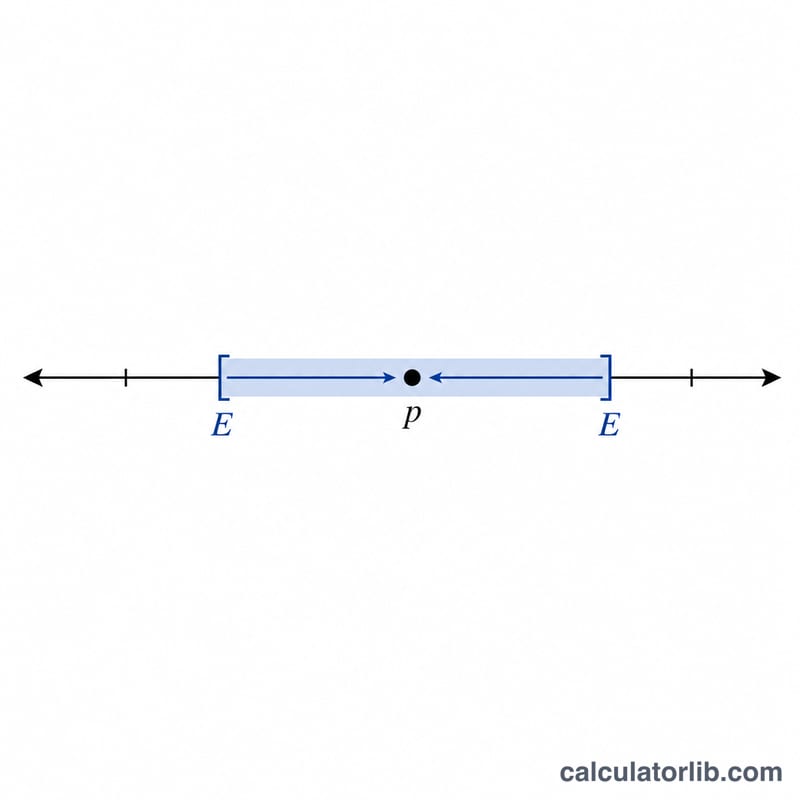
फ़ॉर्मूला समझें
मूल समीकरण है $$n = \dfrac{z^2 \cdot \hat{p}\,(1 - \hat{p})}{e^2}$$ यहाँ \(z\) आपके कॉन्फ़िडेंस लेवल के लिए स्टैंडर्ड नॉर्मल क्रिटिकल वैल्यू है (90% के लिए 1.645, 95% के लिए 1.96, और 99% के लिए 2.576), \(p\) दशमलव में दर्शाया गया अपेक्षित अनुपात है, और \(E\) दशमलव में मार्जिन ऑफ एरर है। पद \(p(1 - p)\) तब सबसे बड़ा होता है जब \(p = 0.5\) हो, इसीलिए 50% पर सैंपल साइज़ अधिकतम आता है। जब कोई सीमित आबादी \(N\) दी जाती है, तो परिणाम को करेक्शन फ़ैक्टर $$n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}$$ से घटाया जाता है।
हल किया हुआ उदाहरण
मान लीजिए आपको 95% कॉन्फ़िडेंस चाहिए (\(z = 1.96\)), 5% मार्जिन ऑफ एरर (\(E = 0.05\)), और आप मानते हैं कि \(p = 0.5\)। तब $$n = \frac{1.96^2 \times 0.5 \times 0.5}{0.05^2} = \frac{3.8416 \times 0.25}{0.0025} = \frac{0.9604}{0.0025} = 384.16$$ जिसे ऊपर की ओर पूर्णांकित करने पर 385 उत्तरदाता मिलते हैं।
Z-स्कोर क्रिटिकल मान विश्वास स्तर के अनुसार
| द्विपक्षीय विश्वास स्तर | क्रिटिकल मान z |
|---|---|
| 80% | 1.282 |
| 85% | 1.440 |
| 90% | 1.645 |
| 95% | 1.960 |
| 98% | 2.326 |
| 99% | 2.576 |
| 99.9% | 3.291 |
ये मानक सामान्य वितरण के क्वांटाइल हैं, जो प्रायिकता \(1 - \alpha/2\) पर हैं, जहाँ \(\alpha = 1 - \text{विश्वास स्तर}\) है। 95% विश्वास के लिए \(\alpha = 0.05\) है, इसलिए z मानक सामान्य वितरण का 97.5वाँ प्रतिशतक है, लगभग 1.960।
आवश्यक नमूना आकार की व्याख्या
- त्रुटि की सीमा (मार्जिन ऑफ एरर) किन बातों को कवर करती है: यह सूत्र एक सरल यादृच्छिक नमूना मानता है और दिए गए विश्वास स्तर पर एक एकल अनुपात का अनुमान लगाता है। यह केवल यादृच्छिक नमूनाकरण त्रुटि को दर्शाता है। यह गैर-प्रतिक्रिया, कवरेज समस्याओं या नमूना पूर्वाग्रह का हिसाब नहीं रखता, इसलिए यह संख्या पूर्ण, उपयोगी प्रतिक्रियाओं की गिनती है जो आपको चाहिए, न कि भेजे गए आमंत्रणों की। यदि आपको 20% प्रतिक्रिया दर की उम्मीद है, तो आपको n से कहीं अधिक लोगों को आमंत्रित करना होगा।
- 95% विश्वास का अर्थ: यदि आप सर्वेक्षण को कई बार दोहराएँ और हर बार इस विधि से एक अंतराल बनाएँ, तो लगभग 95% अंतराल वास्तविक जनसंख्या अनुपात को शामिल करेंगे। इसका अर्थ यह नहीं है कि किसी एक विशिष्ट गणना किए गए अंतराल में वास्तविक मान के होने की 95% प्रायिकता है।
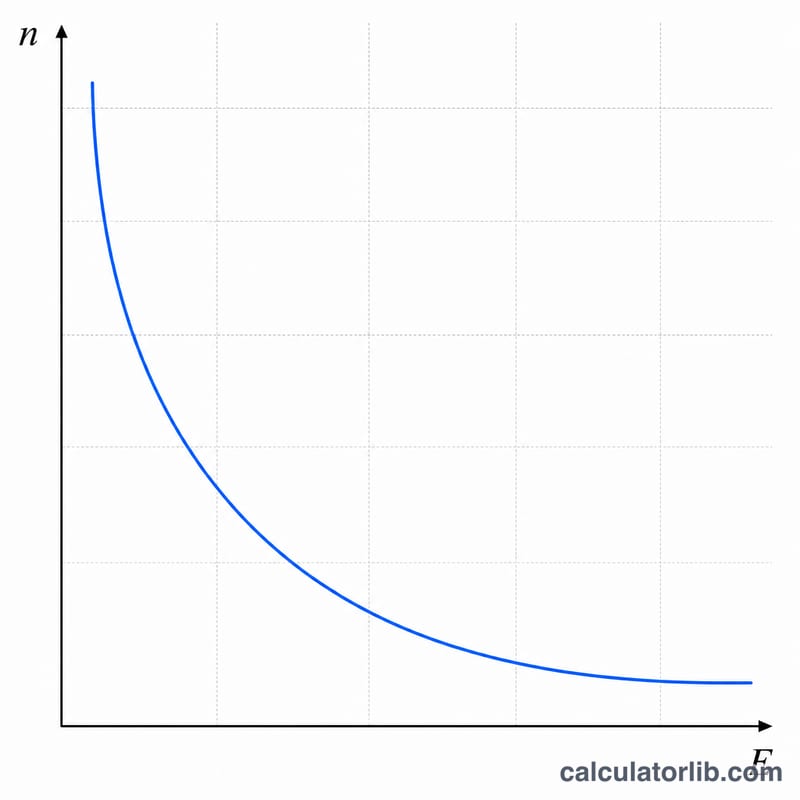
- घटते प्रतिफल: n, \(1/E^2\) के साथ बढ़ता है, इसलिए त्रुटि की सीमा को कम करना जल्दी महंगा हो जाता है। 95% विश्वास पर 5% से 3% तक जाने से n 385 से बढ़कर 1,068 हो जाता है, जबकि 10% से 5% तक जाने में केवल लगभग 288 प्रतिक्रियाएँ जुड़ती हैं।
- p का चयन: \(\hat{p} = 0.5\) \(\hat{p}(1-\hat{p})\) को अधिकतम करता है और सबसे बड़ा, सबसे सुरक्षित n देता है। किसी अन्य मान का उपयोग तभी करें जब आपके पास कोई विश्वसनीय पूर्व अनुमान हो।
- परिमित जनसंख्या सुधार: समायोजन \(n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}\) मुख्य रूप से तब मायने रखता है जब \(n_0\) जनसंख्या आकार N के लगभग 5% से अधिक हो। बड़ी जनसंख्या के लिए यह लगभग कुछ नहीं बदलता; छोटी जनसंख्या के लिए यह आवश्यक नमूने को उल्लेखनीय रूप से कम कर सकता है।
- उपसमूह: त्रुटि की सीमा पूरे नमूने पर लागू होती है। उपसमूहों (उदाहरण के लिए, आयु या क्षेत्र के अनुसार) के परिणामों की त्रुटि सीमा बड़ी होती है, जब तक कि प्रत्येक उपसमूह का अपना पर्याप्त नमूना आकार न हो।
अक्सर पूछे जाने वाले सवाल
अगर मेरे पास कोई अनुमान न हो तो कौन-सा अनुपात लूँ? 50% लें — यह ज़रूरी सैंपल को अधिकतम कर देता है और इस बात की गारंटी देता है कि आपका मार्जिन ऑफ एरर पूरा होगा।
ऊपर की ओर पूर्णांकन (राउंड अप) क्यों? सैंपल साइज़ हमेशा पूर्ण संख्या होनी चाहिए, और ऊपर की ओर पूर्णांकन यह पक्का करता है कि मार्जिन ऑफ एरर तय सीमा से ज़्यादा न हो।
आबादी का आकार कब मायने रखता है? फ़ाइनाइट पॉपुलेशन करेक्शन सैंपल को तभी सार्थक रूप से घटाता है जब आपकी आबादी \(n_0\) की तुलना में छोटी हो (जैसे कुछ हज़ार या उससे कम)।