यह कैलकुलेटर क्या करता है
जब किसी टीवी प्रोग्राम की रेटिंग (ऑडियंस शेयर) मापी जाती है, तो वह हर घर पर नहीं मापी जाती — इसका अनुमान कुछ चुने हुए मॉनिटर किए गए घरों के एक सैंपल से लगाया जाता है। इसीलिए जो आँकड़ा बताया जाता है वह एक सांख्यिकीय अनुमान होता है, जिसमें कुछ अनिश्चितता रहती है। यह कैलकुलेटर सैंपल में देखी गई रेटिंग लेता है और बताता है कि पूरी आबादी की असली रेटिंग किस दायरे में होने की सबसे अधिक संभावना है, वह भी आपके चुने हुए कॉन्फ़िडेंस लेवल पर। उदाहरण भले ही टीवी रेटिंग का हो, पर गणित हर जगह काम करता है: यह किसी भी ऐसे अनुपात पर लागू होता है जिसका अनुमान सैंपल से लगाया गया हो — जैसे ओपिनियन पोल में समर्थन की दर या क्वालिटी कंट्रोल में डिफ़ेक्ट की दर।
इसका इस्तेमाल कैसे करें
सैंपल साइज़ (सर्वे किए गए घरों या यूनिट्स की संख्या) डालें, फिर जो सैंपल रेटिंग आपने प्रतिशत में देखी उसे डालें, और अपना मनचाहा कॉन्फ़िडेंस लेवल (90%, 95% या 99%) चुनें। नतीजे में असली रेटिंग की अनुमानित निचली और ऊपरी सीमा दिखेगी, साथ ही मार्जिन ऑफ़ एरर (इंटरवल की आधी चौड़ाई) भी।
फ़ॉर्मूला आसान शब्दों में
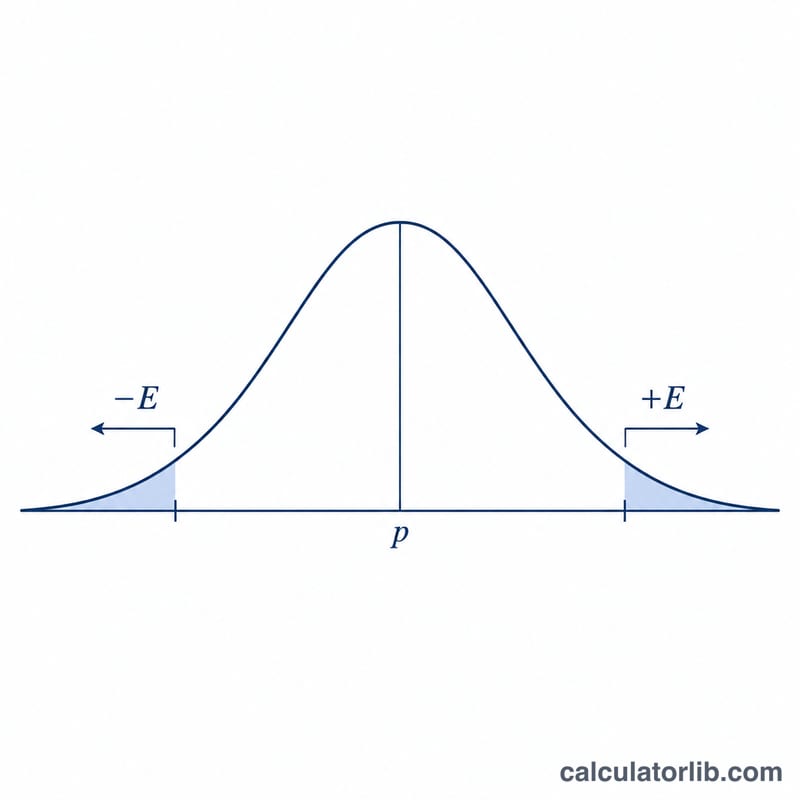
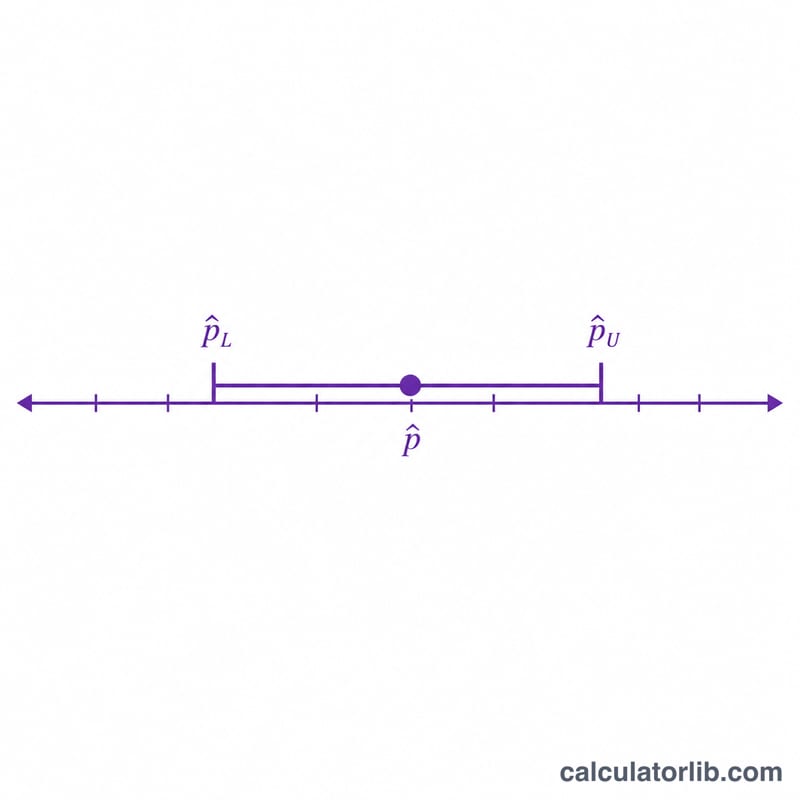
देखी गई रेटिंग को अनुपात में बदला जाता है: \( p = \text{रेटिंग} / 100 \)। उस अनुपात की स्टैंडर्ड एरर होती है $$ SE = \sqrt{\frac{p\,(1-p)}{n}} $$ चुने हुए कॉन्फ़िडेंस के लिए क्रिटिकल वैल्यू \( z \) इनवर्स स्टैंडर्ड नॉर्मल डिस्ट्रिब्यूशन की दो-तरफ़ा वैल्यू होती है (90% के लिए लगभग 1.6449, 95% के लिए 1.9600 और 99% के लिए 2.5758)। मार्जिन ऑफ़ एरर है \( E = z \times SE \), और कॉन्फ़िडेंस इंटरवल है \( (p - E,\ p + E) \), जिसे प्रतिशत में दिखाने के लिए वापस 100 से गुणा किया जाता है। सीमाओं को 0%-100% के वैध दायरे में रखा जाता है।
हल किया हुआ उदाहरण
मान लीजिए n = 600 घर, देखी गई रेटिंग 20%, और कॉन्फ़िडेंस 95%: $$ p = 0.20 $$ $$ SE = \sqrt{\frac{0.20 \times 0.80}{600}} = 0.01633 $$ $$ z = 1.9600 $$ इसलिए $$ E = 0.03201 = 3.20\% $$ यानी असली रेटिंग लगभग 16.80% से 23.20% के दायरे में होगी, और मार्जिन ऑफ़ एरर रहेगा ±3.20%।
अक्सर पूछे जाने वाले सवाल
बड़े सैंपल पर इंटरवल छोटा क्यों हो जाता है? जैसे-जैसे n बढ़ता है, स्टैंडर्ड एरर घटती है, इसलिए जितने ज़्यादा घर सर्वे होंगे, असली रेटिंग का अनुमान उतना ही सटीक यानी कसा हुआ होगा।
कम कॉन्फ़िडेंस लेवल पर दायरा छोटा क्यों होता है? कम कॉन्फ़िडेंस में छोटी z वैल्यू इस्तेमाल होती है, यानी आप निश्चितता के बदले सटीकता पाते हैं। 90% कॉन्फ़िडेंस पर इंटरवल 99% की तुलना में छोटा होता है, पर उतना भरोसेमंद नहीं।
0% या 100% पर क्या होता है? इन बिंदुओं पर Wald फ़ॉर्मूला शून्य-चौड़ाई वाला इंटरवल देता है, क्योंकि स्टैंडर्ड एरर 0 हो जाती है — यह इस तरीके की एक जानी-मानी कमज़ोरी है। ऐसे अति-छोरों वाले अनुपातों के लिए Wilson स्कोर इंटरवल ज़्यादा भरोसेमंद रहता है।