यह क्या है
यह कैलकुलेटर बताता है कि किसी आबादी के अनुपात (प्रोपोर्शन) का अनुमान लगाने के लिए आपको कम-से-कम कितने लोगों से सर्वे में जवाब लेने होंगे — वह भी आपके चुने हुए मार्जिन ऑफ़ एरर और कॉन्फ़िडेंस लेवल के दायरे में। जब सर्वे का नतीजा किसी प्रतिशत के रूप में हो (जैसे "कितने प्रतिशत लोग हाँ कहते हैं"), तो मार्केट रिसर्च, ओपिनियन पोल और क्लिनिकल सर्वे में यही स्टैंडर्ड फ़ॉर्मूला इस्तेमाल होता है।
इसका इस्तेमाल कैसे करें
पहले अपना कॉन्फ़िडेंस लेवल चुनें (90%, 95% या 99%), फिर अपेक्षित अनुपात को प्रतिशत में डालें, और अंत में अपनी मनचाही मार्जिन ऑफ़ एरर प्रतिशत में दर्ज करें। अगर अनुपात का पहले से कोई अंदाज़ा न हो, तो 50% रखें — यह सबसे सुरक्षित (कंज़र्वेटिव) मान है और इससे सबसे बड़ा सैंपल साइज़ निकलता है।
फ़ॉर्मूला आसान शब्दों में
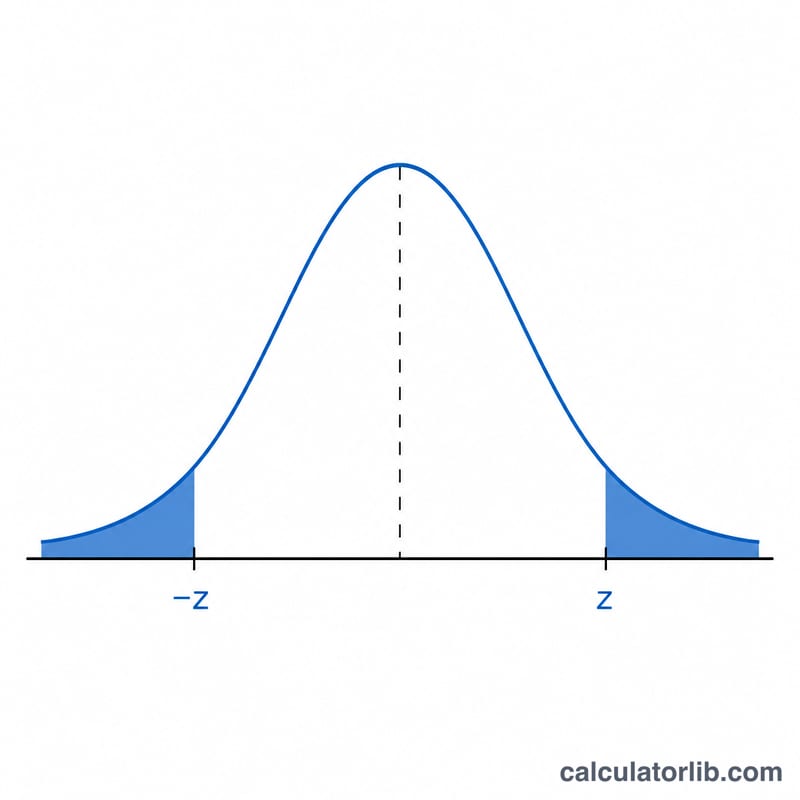
सैंपल साइज़ इस तरह निकलता है: $$n = \left\lceil \frac{\text{z}^{2} \cdot \text{p}\,(1 - \text{p})}{\text{E}^{2}} \right\rceil$$ यहाँ \(z\) स्टैंडर्ड नॉर्मल क्रिटिकल वैल्यू है (90% के लिए 1.645, 95% के लिए 1.96, और 99% के लिए 2.576), \(p\) अपेक्षित अनुपात है दशमलव में, और \(E\) मार्जिन ऑफ़ एरर है दशमलव में। चूँकि सैंपल हमेशा पूरी संख्या में ही होता है, इसलिए नतीजे को ऊपर की ओर (राउंड अप) किया जाता है।
हल किया हुआ उदाहरण
मान लीजिए 99% कॉन्फ़िडेंस (\(z = 2.576\)), \(p = 30\%\) (0.30), और \(E = 4\%\) (0.04): $$n = \frac{2.576^{2} \times 0.30 \times 0.70}{0.04^{2}} = \frac{6.635776 \times 0.21}{0.0016} = \frac{1.39351296}{0.0016} \approx 870.95$$ ऊपर की ओर राउंड करने पर आपको 871 लोगों से जवाब चाहिए।
मुख्य शब्द: विश्वास स्तर, त्रुटि की सीमा और Z-स्कोर
- विश्वास स्तर
- यह बताता है कि नमूनाकरण की प्रक्रिया कितनी बार ऐसा अंतराल देगी जिसमें वास्तविक जनसंख्या मान शामिल हो, यदि सर्वेक्षण को कई बार दोहराया जाए (उदाहरण के लिए, 95% समय)। यह विधि की दीर्घकालिक विश्वसनीयता का वर्णन करता है, न कि इस संभावना का कि कोई एक विशेष अंतराल वास्तविक मान को शामिल करता है। एक बार गणना हो जाने पर, कोई दिया गया अंतराल या तो वास्तविक मान को शामिल करता है या नहीं करता।
- त्रुटि की सीमा (E)
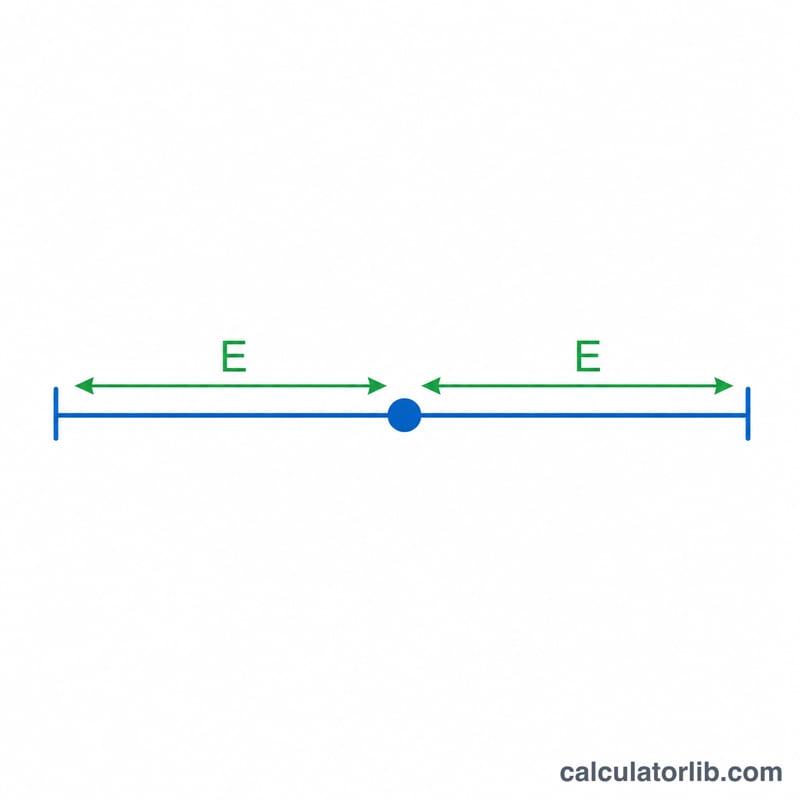
- विश्वास अंतराल की आधी चौड़ाई, जो अनुपात की उसी इकाई में व्यक्त की जाती है। ±3% की त्रुटि सीमा का अर्थ है कि अनुमान को नमूना अनुपात में जोड़ने या घटाने पर 3 प्रतिशत अंक के रूप में रिपोर्ट किया जाता है। कैलकुलेटर में इसे दशमलव के रूप में दर्ज करें (3% के लिए 0.03)।
- क्रिटिकल z-मान (z)
- मानक सामान्य वितरण के मानक विचलनों की वह संख्या जो चुने गए विश्वास स्तर (दो-पक्षीय) से मेल खाती है: 90% के लिए 1.645, 95% के लिए 1.96, और 99% के लिए 2.576।
- अपेक्षित अनुपात (p)
- जनसंख्या में रुचि के लक्षण वाले हिस्से का आपका पूर्व अनुमान, जो दशमलव के रूप में दर्ज किया जाता है। जब यह ज्ञात न हो, तो 0.5 का उपयोग करें, जो p(1−p) को अधिकतम करता है और सबसे सुरक्षित (सबसे बड़ा) नमूना आकार देता है।
- परिमित जनसंख्या सुधार
- एक समायोजन जिसका उपयोग तब किया जाता है जब नमूना एक छोटी जनसंख्या का काफी बड़ा हिस्सा हो (आमतौर पर लगभग 5% से ऊपर)। समायोजित आकार \(n_{adj} = \dfrac{n}{1 + (n-1)/N}\) है, जहाँ N जनसंख्या का आकार है। यहाँ का मूल सूत्र एक बहुत बड़ी या अनंत जनसंख्या मानता है और यह सुधार लागू नहीं करता।
- नमूना आकार (n)
- चुने गए विश्वास स्तर और त्रुटि की सीमा को पूरा करने के लिए आवश्यक पूर्ण किए गए उत्तरों की संख्या। इसे हमेशा अगली पूर्ण संख्या तक पूर्णांकित किया जाता है। गैर-प्रतिक्रिया के लिए n से अधिक लोगों को आमंत्रित करने की योजना बनाएं।
अक्सर पूछे जाने वाले सवाल
अनुपात मालूम न हो तो 50% ही क्यों लें? \(p(1-p)\) का मान \(p = 0.5\) पर सबसे ज़्यादा होता है, इसलिए यह सबसे सुरक्षित (सबसे बड़ा) सैंपल साइज़ देता है।
क्या इसमें आबादी का आकार जुड़ा है? नहीं — यह अनंत आबादी (इनफ़िनाइट पॉपुलेशन) वाला फ़ॉर्मूला है। छोटी आबादी के लिए फ़ाइनाइट पॉपुलेशन करेक्शन लगाना चाहिए।
मार्जिन ऑफ़ एरर क्या होती है? यह आपके अनुमान के इर्द-गिर्द का ± दायरा है, जो चुने गए कॉन्फ़िडेंस लेवल पर लागू होता है।