यह कैलकुलेटर क्या करता है
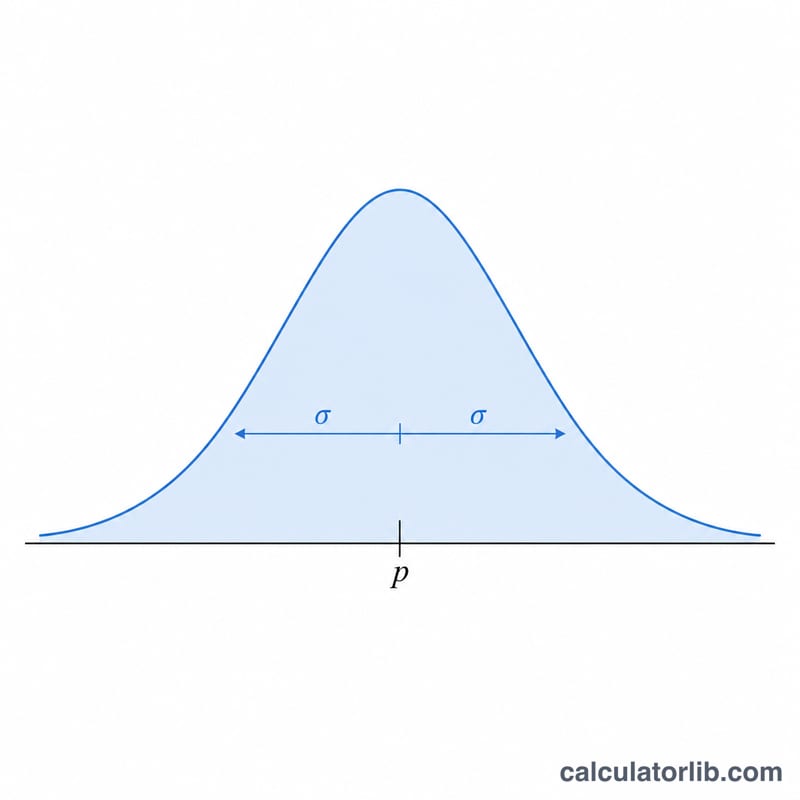
यह टूल सैंपल अनुपात (sample proportion, p̂) की प्रतिचयन वितरण को बताता है। जब आप किसी आबादी, जिसका वास्तविक अनुपात p है, में से बार-बार n आकार के यादृच्छिक (random) सैंपल लेते हैं, तो हर बार मिलने वाले सैंपल अनुपात मिलकर अपनी एक अलग वितरण बनाते हैं। यह कैलकुलेटर उस वितरण का माध्य (mean) और मानक त्रुटि (standard error) देता है, ताकि आप विश्वास अंतराल (confidence interval) बना सकें, परिकल्पना परीक्षण (hypothesis test) कर सकें, या प्रतिचयन में होने वाले उतार-चढ़ाव का आकलन कर सकें।
इसका उपयोग कैसे करें
आबादी का अनुपात p को 0 और 1 के बीच दशमलव में दर्ज करें (उदाहरण के लिए, 40% के लिए 0.4), फिर सैंपल का आकार n भरें। कैलकुलेटर तुरंत माध्य (जो p के बराबर होता है), प्रसरण (variance) और प्रतिचयन वितरण की मानक त्रुटि (SE) दिखा देता है।
सूत्र की व्याख्या
प्रतिचयन वितरण का माध्य आबादी के अनुपात के बराबर होता है: \(\mu_{\hat{p}} = \text{p}\)। मानक त्रुटि यह मापती है कि सैंपल अनुपात p के आसपास कितना बदलते हैं, और इसका सूत्र है
$$\text{SE} = \sqrt{\frac{\text{p}\,(1 - \text{p})}{\text{n}}}$$बड़े सैंपल मानक त्रुटि को घटा देते हैं, जिससे आपका अनुमान ज़्यादा सटीक हो जाता है। केंद्रीय सीमा प्रमेय (Central Limit Theorem) के अनुसार, जब \(n\text{p} \geq 10\) और \(n(1-\text{p}) \geq 10\) दोनों शर्तें पूरी होती हैं, तो यह वितरण लगभग सामान्य (normal) हो जाता है।
हल किया हुआ उदाहरण
मान लीजिए \(\text{p} = 0.5\) और \(\text{n} = 100\) है। तब माध्य 0.5 होगा। प्रसरण
$$\frac{0.5 \times 0.5}{100} = 0.0025$$होगा, और मानक त्रुटि
$$\sqrt{0.0025} = 0.05$$होगी। यानी सैंपल अनुपात आमतौर पर 0.5 के लगभग \(\pm 0.05\) के दायरे में आते हैं।
नमूना आकार और अनुपात का मानक त्रुटि पर प्रभाव
नमूना अनुपात की मानक त्रुटि \(SE = \sqrt{\frac{p(1-p)}{n} }\) है। तालिका में चार जनसंख्या अनुपातों और चार नमूना आकारों के लिए SE दिखाया गया है। तारांकन (*) उस संयोजन को दर्शाता है जहाँ \(np < 10\) या \(n(1-p) < 10\) है, इसलिए वहाँ सामान्य सन्निकटन का उपयोग नहीं करना चाहिए।
| p | n = 25 | n = 100 | n = 400 | n = 1000 |
|---|---|---|---|---|
| 0.1 | 0.0600* | 0.0300 | 0.0150 | 0.0095 |
| 0.3 | 0.0917* | 0.0458 | 0.0229 | 0.0145 |
| 0.5 | 0.1000 | 0.0500 | 0.0250 | 0.0158 |
| 0.7 | 0.0917* | 0.0458 | 0.0229 | 0.0145 |
मान चार दशमलव स्थानों तक पूर्णांकित हैं। चिह्नित कोष्ठक ये हैं:
- p = 0.1, n = 25: \(np = 2.5\)
- p = 0.3, n = 25: \(np = 7.5\)
- p = 0.7, n = 25: \(n(1-p) = 7.5\)
p = 0.1 और n = 100 के लिए, \(np = 10\) ठीक है, जो सीमा को बस पूरा करता है।
तालिका क्या दिखाती है
- n को चार गुना करने पर SE आधा हो जाता है। n = 25 से 100 और 400 तक, हर चरण में n चार गुना होता है और SE आधा हो जाता है। p = 0.5 के लिए: 0.1000, 0.0500, 0.0250।
- p = 0.5 पर SE सबसे बड़ा होता है, क्योंकि \(p(1-p)\) 0.25 पर चरम पर होता है। p और 1 − p के मान समान होते हैं (p = 0.3 और p = 0.7 की तुलना करें)।
मुख्य शब्द और प्रतीक
- जनसंख्या अनुपात (p)
- संपूर्ण जनसंख्या में रुचि की विशेषता वाले लोगों का वास्तविक अंश। यह आमतौर पर अज्ञात होता है और 0 और 1 के बीच होता है।
- नमूना अनुपात (\(\hat{p}\))
- नमूने में सफलताओं का अंश: \(\hat{p} = X/n\), जहाँ X सफलताओं की संख्या है।
- नमूना आकार (n)
- प्रत्येक नमूने में स्वतंत्र प्रेक्षणों की संख्या।
- नमूनाकरण वितरण
- उसी जनसंख्या से आकार n के सभी संभावित नमूनों में \(\hat{p}\) का वितरण। इसका माध्य p है और इसका मानक विचलन \(\sqrt{p(1-p)/n}\) है।
- मानक त्रुटि बनाम मानक विचलन
- मानक विचलन व्यक्तिगत मानों के फैलाव को मापता है (एक 0/1 प्रेक्षण के लिए यह \(\sqrt{p(1-p)}\) है)। मानक त्रुटि \(\hat{p}\) जैसे सांख्यिकीय मान का मानक विचलन है, और n बढ़ने पर यह घटती है।
- अनभिनत आकलनकर्ता
- एक सांख्यिकीय मान जिसका बार-बार लिए गए नमूनों पर माध्य उस प्राचल के बराबर होता है जिसका वह आकलन करता है। चूँकि \(\mu_{\hat{p}} = p\), नमूना अनुपात p का एक अनभिनत आकलनकर्ता है।
- केंद्रीय सीमा प्रमेय और सफलता-विफलता शर्त
- पर्याप्त बड़े n के लिए, \(\hat{p}\) का नमूनाकरण वितरण लगभग सामान्य होता है। एक सामान्य व्यावहारिक नियम के अनुसार \(np \ge 10\) और \(n(1-p) \ge 10\) होने चाहिए (कुछ पुस्तकें 5 का उपयोग करती हैं), साथ ही प्रेक्षण स्वतंत्र होने चाहिए। इन सीमाओं से नीचे वितरण उल्लेखनीय रूप से तिरछा होता है और सामान्य-आधारित प्रायिकताएँ गलत हो सकती हैं।
अक्सर पूछे जाने वाले सवाल
माध्य p के बराबर क्यों होता है? क्योंकि सैंपल अनुपात आबादी के अनुपात का एक निष्पक्ष आकलक (unbiased estimator) है — औसतन यह वास्तविक मान पर ही टिकता है।
जैसे-जैसे n बढ़ता है, क्या होता है? मानक त्रुटि \(1/\sqrt{n}\) के अनुपात में घटती जाती है, इसलिए बड़े सैंपल के साथ अनुमान अधिक सटीक होते जाते हैं।
सामान्य सन्निकटन (normal approximation) कब मान्य होता है? एक आम नियम है \(n\text{p} \geq 10\) और \(n(1-\text{p}) \geq 10\); अन्यथा सटीक द्विपद (binomial) विधियों का उपयोग करना बेहतर रहता है।