このツールでできること
このツールは、標本比率(p̂)の標本分布を求めるためのものです。母比率 p をもつ母集団から、大きさ n の無作為標本を何度も繰り返し抽出すると、得られる標本比率そのものが一つの分布を形づくります。本計算ツールはその分布の平均と標準誤差を返すので、信頼区間の作成、仮説検定の実行、標本ごとのばらつき(標本変動)の評価に役立ちます。
使い方
母比率 p を 0 〜 1 の小数で入力します(例:40%なら 0.4)。続いて標本サイズ n を入力してください。すると、標本分布の平均(これは p に等しくなります)、分散、標準誤差(SE)が瞬時に表示されます。
計算式の解説
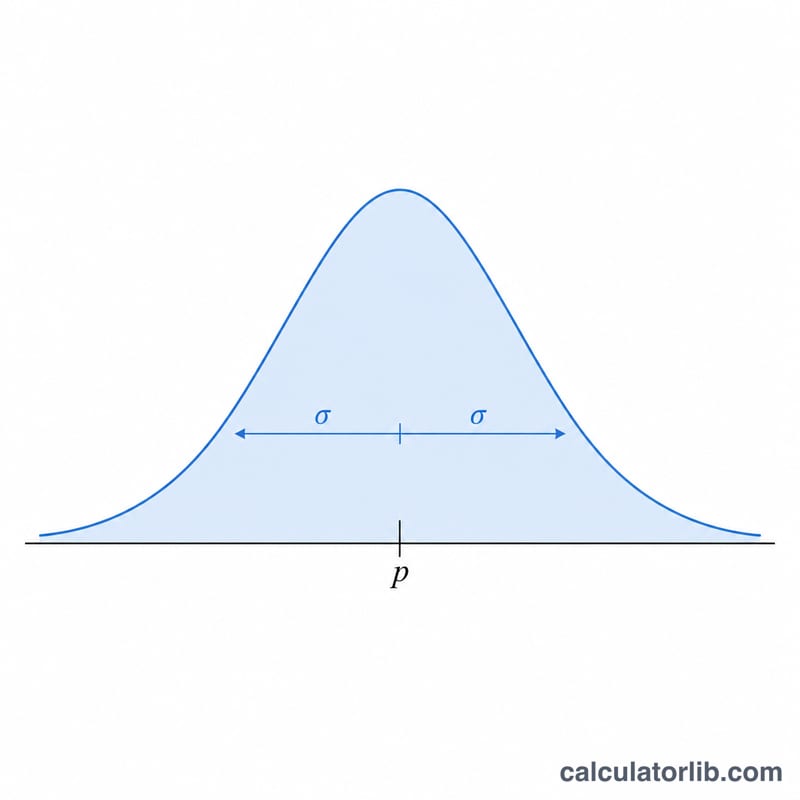
標本分布の平均は母比率と等しくなります:$$\mu_{\hat{p}} = \text{p}$$標準誤差は、標本比率が p のまわりでどの程度ばらつくかを表す指標で、次の式で求められます:$$\sigma_{\hat{p}} = \sqrt{\frac{\text{p}\,(1 - \text{p})}{\text{n}}}$$標本が大きいほど標準誤差は小さくなり、推定の精度が高まります。中心極限定理により、\(np \geq 10\) かつ \(n(1-p) \geq 10\) を満たすとき、この分布は近似的に正規分布とみなせます。
具体例
\(p = 0.5\)、\(n = 100\) の場合を考えてみましょう。平均は 0.5 です。分散は $$0.5 \times 0.5 \div 100 = 0.0025$$ 標準誤差は $$\sqrt{0.0025} = 0.05$$ となります。つまり、標本比率はおおむね 0.5 を中心に ±0.05 程度の範囲に収まる、ということです。
標本サイズと比率が標準誤差に与える影響
標本比率の標準誤差は \(SE = \sqrt{\frac{p(1-p)}{n} }\) です。この表は、4つの母集団比率と4つの標本サイズについてのSEを示しています。アスタリスク(*)は、\(np < 10\) または \(n(1-p) < 10\) となる組み合わせを示しており、その場合は正規近似を使用すべきではありません。
| p | n = 25 | n = 100 | n = 400 | n = 1000 |
|---|---|---|---|---|
| 0.1 | 0.0600* | 0.0300 | 0.0150 | 0.0095 |
| 0.3 | 0.0917* | 0.0458 | 0.0229 | 0.0145 |
| 0.5 | 0.1000 | 0.0500 | 0.0250 | 0.0158 |
| 0.7 | 0.0917* | 0.0458 | 0.0229 | 0.0145 |
値は小数点以下4桁に四捨五入しています。印の付いたセルは次のとおりです:
- p = 0.1、n = 25:\(np = 2.5\)
- p = 0.3、n = 25:\(np = 7.5\)
- p = 0.7、n = 25:\(n(1-p) = 7.5\)
p = 0.1、n = 100の場合、\(np = 10\) ちょうどとなり、しきい値をちょうど満たします。
表から分かること
- nを4倍にするとSEは半分になります。n = 25から100、400へと進むと、各段階でnは4倍になり、SEは2で割られます。p = 0.5の場合:0.1000、0.0500、0.0250。
- SEはp = 0.5で最大になります。これは\(p(1-p)\)が0.25で最大になるためです。pと1 − pの値は同一です(p = 0.3とp = 0.7を比較してください)。
主要な用語と記号
- 母集団比率(p)
- 関心のある特性を持つ、母集団全体の真の割合です。通常は不明であり、0から1の間の値をとります。
- 標本比率(\(\hat{p}\))
- 標本内での成功の割合:\(\hat{p} = X/n\)。ここでXは成功の数です。
- 標本サイズ(n)
- 各標本に含まれる独立した観測値の数です。
- 標本分布
- 同じ母集団から取り得るすべてのサイズnの標本にわたる\(\hat{p}\)の分布です。その平均はpであり、標準偏差は\(\sqrt{p(1-p)/n}\)です。
- 標準誤差と標準偏差の違い
- 標準偏差は個々の値のばらつきを測るものです(0/1の観測値1つについては\(\sqrt{p(1-p)}\))。標準誤差は\(\hat{p}\)のような統計量の標準偏差であり、nが大きくなるほど小さくなります。
- 不偏推定量
- 繰り返し標本にわたる平均が、推定する母数に等しい統計量です。\(\mu_{\hat{p}} = p\)であるため、標本比率はpの不偏推定量です。
- 中心極限定理と成功・失敗の条件
- nが十分に大きいとき、\(\hat{p}\)の標本分布はほぼ正規分布になります。一般的な目安として、独立した観測値であることに加えて、\(np \ge 10\) かつ \(n(1-p) \ge 10\)(教科書によっては5を用いる)が求められます。これらのしきい値を下回ると、分布は著しく歪み、正規分布に基づく確率は不正確になることがあります。
よくある質問
なぜ平均が p と等しくなるのですか? 標本比率が母比率の不偏推定量だからです。平均的に見れば、真の値をぴったり言い当てる性質をもっています。
n を大きくするとどうなりますか? 標準誤差は \(1/\sqrt{n}\) に比例して小さくなります。したがって、標本が大きいほど推定の精度は高まります。
正規近似が使えるのはどんなときですか? 一般的な目安は \(np \geq 10\) かつ \(n(1-p) \geq 10\) です。これを満たさない場合は、二項分布を用いた厳密な方法を検討してください。