Qué hace esta calculadora
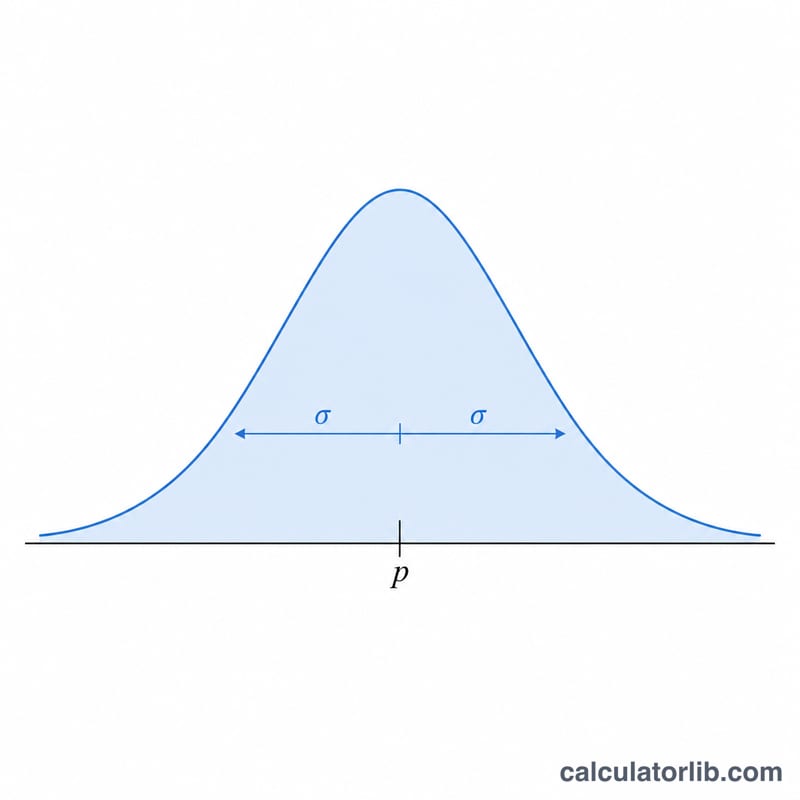
Esta herramienta describe la distribución muestral de la proporción muestral (p̂). Cuando extraes una y otra vez muestras aleatorias de tamaño n a partir de una población con proporción real p, las proporciones que obtienes forman su propia distribución. Esta calculadora te da su media y su error estándar, de modo que puedas construir intervalos de confianza, realizar contrastes de hipótesis o valorar la variabilidad del muestreo.
Cómo usarla
Introduce la proporción poblacional p como un número decimal entre 0 y 1 (por ejemplo, 0,4 para un 40 %) y, a continuación, indica el tamaño de la muestra n. La calculadora muestra al instante la media (que coincide con p), la varianza y el error estándar (EE) de la distribución muestral.
La fórmula explicada
La media de la distribución muestral es igual a la proporción poblacional: \(\mu_{\hat{p}} = \text{p}\). El error estándar mide cuánto se alejan las proporciones muestrales de p y se calcula con
$$\sigma_{\hat{p}} = \sqrt{\frac{\text{p}\,(1 - \text{p})}{\text{n}}}$$Cuanto mayor es la muestra, menor es el error estándar, por lo que la estimación gana precisión. Según el Teorema Central del Límite, la distribución es aproximadamente normal cuando se cumplen a la vez np ≥ 10 y n(1−p) ≥ 10.
Ejemplo resuelto
Supongamos que p = 0,5 y n = 100. La media es 0,5. La varianza es
$$0{,}5 \times 0{,}5 / 100 = 0{,}0025$$y el error estándar es
$$\sqrt{0{,}0025} = 0{,}05$$Por tanto, las proporciones muestrales suelen situarse dentro de un margen de aproximadamente ±0,05 alrededor de 0,5.
Cómo el tamaño de la muestra y la proporción cambian el error estándar
El error estándar de la proporción muestral es \(SE = \sqrt{\frac{p(1-p)}{n} }\). La tabla muestra el SE para cuatro proporciones poblacionales y cuatro tamaños de muestra. Un asterisco (*) marca una combinación donde \(np < 10\) o \(n(1-p) < 10\), por lo que no debe usarse la aproximación normal.
| p | n = 25 | n = 100 | n = 400 | n = 1000 |
|---|---|---|---|---|
| 0.1 | 0.0600* | 0.0300 | 0.0150 | 0.0095 |
| 0.3 | 0.0917* | 0.0458 | 0.0229 | 0.0145 |
| 0.5 | 0.1000 | 0.0500 | 0.0250 | 0.0158 |
| 0.7 | 0.0917* | 0.0458 | 0.0229 | 0.0145 |
Los valores están redondeados a cuatro decimales. Las celdas marcadas son:
- p = 0.1, n = 25: \(np = 2.5\)
- p = 0.3, n = 25: \(np = 7.5\)
- p = 0.7, n = 25: \(n(1-p) = 7.5\)
Para p = 0.1 y n = 100, \(np = 10\) exactamente, lo que justo cumple el umbral.
Lo que muestra la tabla
- Cuadruplicar n reduce a la mitad el SE. De n = 25 a 100 y a 400, cada paso multiplica n por 4 y divide el SE entre 2. Para p = 0.5: 0.1000, 0.0500, 0.0250.
- El SE es mayor en p = 0.5, porque \(p(1-p)\) alcanza su máximo en 0.25. Los valores para p y 1 − p son idénticos (compare p = 0.3 y p = 0.7).
Términos y símbolos clave
- Proporción poblacional (p)
- La fracción real de toda la población con la característica de interés. Por lo general es desconocida y está entre 0 y 1.
- Proporción muestral (\(\hat{p}\))
- La fracción de éxitos en una muestra: \(\hat{p} = X/n\), donde X es el número de éxitos.
- Tamaño de la muestra (n)
- El número de observaciones independientes en cada muestra.
- Distribución muestral
- La distribución de \(\hat{p}\) en todas las muestras posibles de tamaño n de la misma población. Su media es p y su desviación estándar es \(\sqrt{p(1-p)/n}\).
- Error estándar frente a desviación estándar
- La desviación estándar mide la dispersión de valores individuales (para una observación 0/1 es \(\sqrt{p(1-p)}\)). El error estándar es la desviación estándar de un estadístico como \(\hat{p}\), y disminuye a medida que n aumenta.
- Estimador insesgado
- Un estadístico cuya media en muestras repetidas es igual al parámetro que estima. Como \(\mu_{\hat{p}} = p\), la proporción muestral es un estimador insesgado de p.
- Teorema del límite central y la condición de éxito-fracaso
- Para un n suficientemente grande, la distribución muestral de \(\hat{p}\) es aproximadamente normal. Una regla práctica común exige \(np \ge 10\) y \(n(1-p) \ge 10\) (algunos textos usan 5), junto con observaciones independientes. Por debajo de estos umbrales la distribución está notablemente sesgada y las probabilidades basadas en la normal pueden ser imprecisas.
Preguntas frecuentes
¿Por qué la media coincide con p? Porque la proporción muestral es un estimador insesgado de la proporción poblacional: en promedio acierta el valor real.
¿Qué ocurre cuando n aumenta? El error estándar disminuye de forma proporcional a \(1/\sqrt{\text{n}}\), así que las estimaciones se vuelven más precisas con muestras más grandes.
¿Cuándo es válida la aproximación normal? Una regla habitual exige np ≥ 10 y n(1−p) ≥ 10; si no se cumple, conviene recurrir a métodos binomiales exactos.