这款计算器的用途
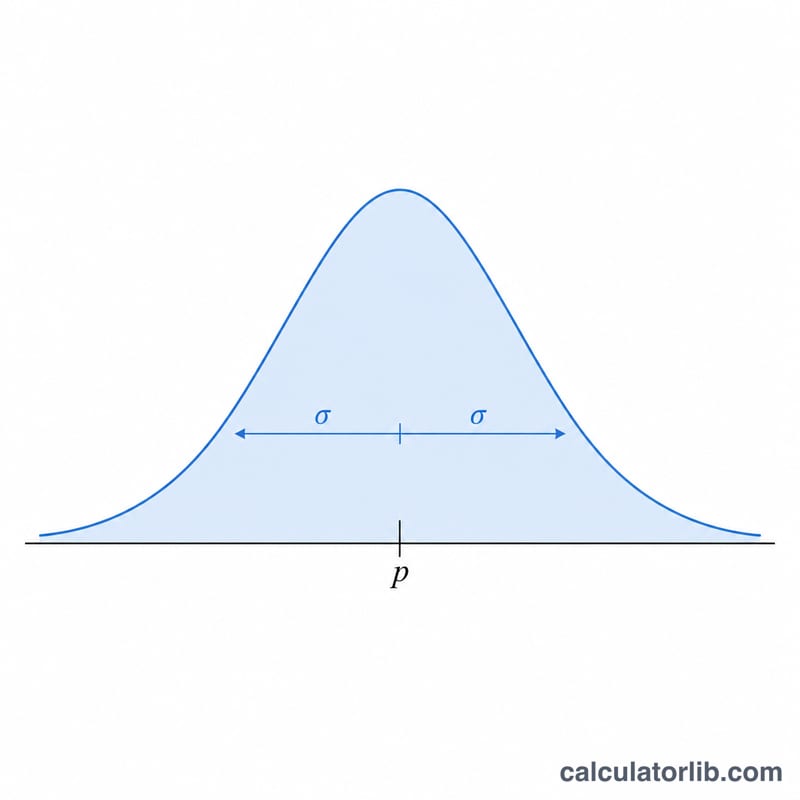
本工具用来描述样本比例的抽样分布(p̂)。当你从一个真实比例为 \(p\) 的总体中反复抽取样本量为 \(n\) 的随机样本时,每次得到的样本比例本身会形成一个新的分布。计算器会给出该分布的均值和标准误,帮助你构建置信区间、进行假设检验,或评估抽样波动的大小。
使用方法
将总体比例 p 以 0 到 1 之间的小数形式填入(例如 40% 就输入 0.4),再填入样本量 n。计算器会立即输出抽样分布的均值(等于 p)、方差以及标准误(SE)。
公式详解
抽样分布的均值等于总体比例:
$$\mu_{\hat{p}} = \text{p}$$标准误衡量的是样本比例围绕 p 的离散程度,计算公式为
$$\sigma_{\hat{p}} = \sqrt{\frac{\text{p}\,(1 - \text{p})}{\text{n}}}$$样本越大,标准误越小,估计就越精确。根据中心极限定理,当 \(np \geq 10\) 且 \(n(1-p) \geq 10\) 时,该分布可近似看作正态分布。
实例演算
假设 \(p = 0.5\)、\(n = 100\)。此时均值为 0.5,方差为
$$0.5 \times 0.5 / 100 = 0.0025$$标准误为
$$\sqrt{0.0025} = 0.05$$也就是说,样本比例通常会落在 0.5 上下约 ±0.05 的范围内。
样本量和比例如何改变标准误
样本比例的标准误为 \(SE = \sqrt{\frac{p(1-p)}{n} }\)。下表给出了四个总体比例和四个样本量下的 SE。星号(*)标记了满足 \(np < 10\) 或 \(n(1-p) < 10\) 的组合,因此不应使用正态近似。
| p | n = 25 | n = 100 | n = 400 | n = 1000 |
|---|---|---|---|---|
| 0.1 | 0.0600* | 0.0300 | 0.0150 | 0.0095 |
| 0.3 | 0.0917* | 0.0458 | 0.0229 | 0.0145 |
| 0.5 | 0.1000 | 0.0500 | 0.0250 | 0.0158 |
| 0.7 | 0.0917* | 0.0458 | 0.0229 | 0.0145 |
数值四舍五入至小数点后四位。被标记的单元格为:
- p = 0.1,n = 25:\(np = 2.5\)
- p = 0.3,n = 25:\(np = 7.5\)
- p = 0.7,n = 25:\(n(1-p) = 7.5\)
对于 p = 0.1 且 n = 100,\(np = 10\) 恰好满足阈值。
表格显示的内容
- n 增至四倍,SE 减半。从 n = 25 到 100 再到 400,每一步 n 乘以 4,SE 除以 2。对于 p = 0.5:0.1000、0.0500、0.0250。
- SE 在 p = 0.5 时最大,因为 \(p(1-p)\) 在 0.25 处达到峰值。p 与 1 − p 的值相同(比较 p = 0.3 和 p = 0.7)。
关键术语与符号
- 总体比例(p)
- 具有所关注特征的整个总体的真实比例。它通常是未知的,取值介于 0 和 1 之间。
- 样本比例(\(\hat{p}\))
- 样本中成功次数的比例:\(\hat{p} = X/n\),其中 X 为成功次数。
- 样本量(n)
- 每个样本中独立观测值的数量。
- 抽样分布
- 从同一总体中抽取所有可能的大小为 n 的样本时,\(\hat{p}\) 的分布。其均值为 p,标准差为 \(\sqrt{p(1-p)/n}\)。
- 标准误与标准差
- 标准差衡量单个值的离散程度(对于一次 0/1 观测,它为 \(\sqrt{p(1-p)}\))。标准误是诸如 \(\hat{p}\) 这类统计量的标准差,并且随着 n 增大而减小。
- 无偏估计量
- 在重复抽样中其均值等于它所估计的参数的统计量。由于 \(\mu_{\hat{p}} = p\),样本比例是 p 的无偏估计量。
- 中心极限定理与成功-失败条件
- 当 n 足够大时,\(\hat{p}\) 的抽样分布近似为正态分布。常用的经验法则要求 \(np \ge 10\) 且 \(n(1-p) \ge 10\)(某些教材使用 5),同时观测值须相互独立。低于这些阈值时,分布明显偏斜,基于正态的概率可能不准确。
常见问题
为什么均值等于 p?因为样本比例是总体比例的无偏估计量——平均来看,它恰好命中真实值。
n 增大时会怎样?标准误会以 \(1/\sqrt{n}\) 的比例减小,因此样本越大,估计越精确。
正态近似在什么情况下成立?常用的判断标准是 \(np \geq 10\) 且 \(n(1-p) \geq 10\);否则建议改用精确的二项分布方法。