Что считает этот калькулятор
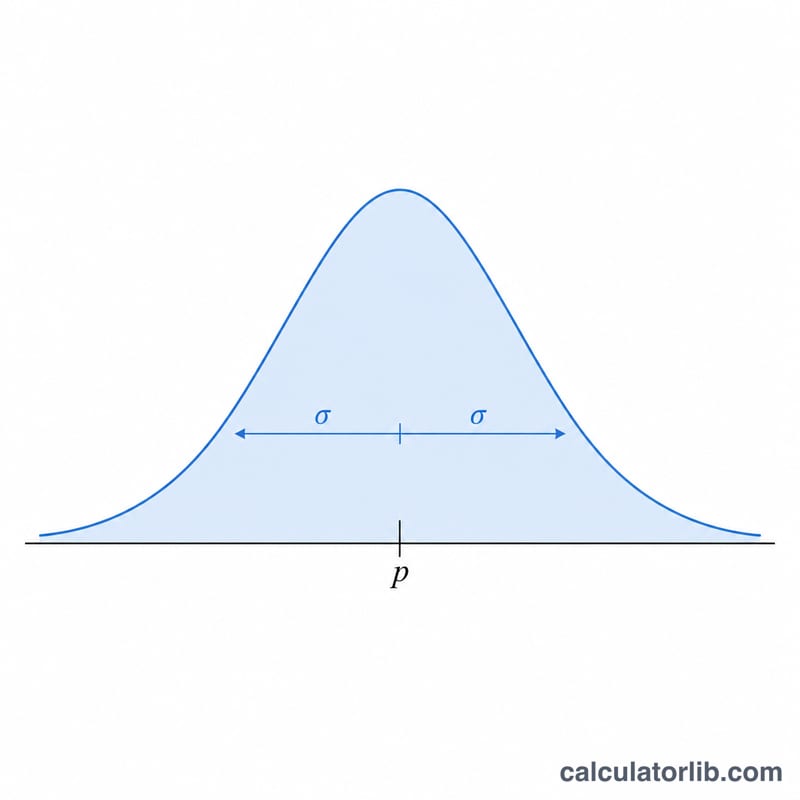
Этот инструмент описывает выборочное распределение выборочной доли (p̂). Если многократно извлекать случайные выборки объёма n из совокупности с истинной долей p, то получаемые выборочные доли сами образуют распределение. Калькулятор находит его среднее и стандартную ошибку — это нужно, чтобы строить доверительные интервалы, проверять статистические гипотезы и оценивать выборочную изменчивость.
Как пользоваться
Введите долю в совокупности p как десятичное число от 0 до 1 (например, 0,4 для 40 %), затем укажите объём выборки n. Калькулятор сразу выдаст среднее (которое равно p), дисперсию и стандартную ошибку (SE) выборочного распределения.
Разбор формулы
Среднее выборочного распределения равно доле в совокупности: $$\mu_{\hat{p}} = \text{p}$$ Стандартная ошибка показывает, насколько выборочные доли разбросаны вокруг p, и вычисляется по формуле $$\text{SE} = \sqrt{\frac{\text{p}\,(1 - \text{p})}{\text{n}}}$$ Чем больше выборка, тем меньше стандартная ошибка, а значит, оценка точнее. По центральной предельной теореме распределение приближённо нормально, когда одновременно \(n p \geq 10\) и \(n(1-p) \geq 10\).
Пример расчёта
Пусть \(p = 0{,}5\) и \(n = 100\). Тогда среднее равно 0,5. Дисперсия равна $$0{,}5 \times 0{,}5 / 100 = 0{,}0025$$ а стандартная ошибка — $$\sqrt{0{,}0025} = 0{,}05$$ То есть выборочные доли обычно попадают в диапазон примерно ±0,05 от 0,5.
Частые вопросы
Почему среднее равно p? Потому что выборочная доля — это несмещённая оценка доли в совокупности: в среднем она попадает точно в истинное значение.
Что происходит при росте n? Стандартная ошибка убывает пропорционально \(1/\sqrt{n}\), поэтому с увеличением выборки оценки становятся точнее.
Когда применимо нормальное приближение? Распространённое правило — \(n p \geq 10\) и \(n(1-p) \geq 10\); в иных случаях лучше использовать точные методы на основе биномиального распределения.
Как размер выборки и доля影响 стандартную ошибку
Стандартная ошибка выборочной доли равна \(SE = \sqrt{\frac{p(1-p)}{n} }\). В таблице показаны значения SE для четырёх долей в генеральной совокупности и четырёх размеров выборки. Звёздочка (*) отмечает комбинацию, где \(np < 10\) или \(n(1-p) < 10\), поэтому нормальную аппроксимацию использовать нельзя.
| p | n = 25 | n = 100 | n = 400 | n = 1000 |
|---|---|---|---|---|
| 0.1 | 0.0600* | 0.0300 | 0.0150 | 0.0095 |
| 0.3 | 0.0917* | 0.0458 | 0.0229 | 0.0145 |
| 0.5 | 0.1000 | 0.0500 | 0.0250 | 0.0158 |
| 0.7 | 0.0917* | 0.0458 | 0.0229 | 0.0145 |
Значения округлены до четырёх знаков после запятой. Отмеченные ячейки:
- p = 0.1, n = 25: \(np = 2.5\)
- p = 0.3, n = 25: \(np = 7.5\)
- p = 0.7, n = 25: \(n(1-p) = 7.5\)
Для p = 0.1 и n = 100 получаем \(np = 10\) ровно, что точно соответствует пороговому значению.
Что показывает таблица
- Увеличение n в четыре раза уменьшает SE вдвое. При переходе от n = 25 к 100 и к 400 каждый шаг умножает n на 4 и делит SE на 2. Для p = 0.5: 0.1000, 0.0500, 0.0250.
- SE максимальна при p = 0.5, поскольку \(p(1-p)\) достигает максимума 0.25. Значения для p и 1 − p совпадают (сравните p = 0.3 и p = 0.7).
Ключевые термины и обозначения
- Доля генеральной совокупности (p)
- Истинная доля всей генеральной совокупности, обладающей интересующим признаком. Обычно она неизвестна и лежит между 0 и 1.
- Выборочная доля (\(\hat{p}\))
- Доля успехов в выборке: \(\hat{p} = X/n\), где X — число успехов.
- Размер выборки (n)
- Число независимых наблюдений в каждой выборке.
- Выборочное распределение
- Распределение \(\hat{p}\) по всем возможным выборкам объёма n из одной и той же совокупности. Его среднее равно p, а стандартное отклонение равно \(\sqrt{p(1-p)/n}\).
- Стандартная ошибка и стандартное отклонение
- Стандартное отклонение измеряет разброс отдельных значений (для одного наблюдения 0/1 оно равно \(\sqrt{p(1-p)}\)). Стандартная ошибка — это стандартное отклонение статистики, такой как \(\hat{p}\), и она уменьшается с ростом n.
- Несмещённая оценка
- Статистика, среднее значение которой по повторным выборкам равно оцениваемому параметру. Поскольку \(\mu_{\hat{p}} = p\), выборочная доля является несмещённой оценкой p.
- Центральная предельная теорема и условие «успех-неудача»
- При достаточно большом n выборочное распределение \(\hat{p}\) приблизительно нормально. Распространённое эмпирическое правило требует \(np \ge 10\) и \(n(1-p) \ge 10\) (в некоторых учебниках используется 5) при условии независимости наблюдений. Ниже этих порогов распределение заметно асимметрично, и вероятности, основанные на нормальном распределении, могут быть неточными.