이 계산기의 기능
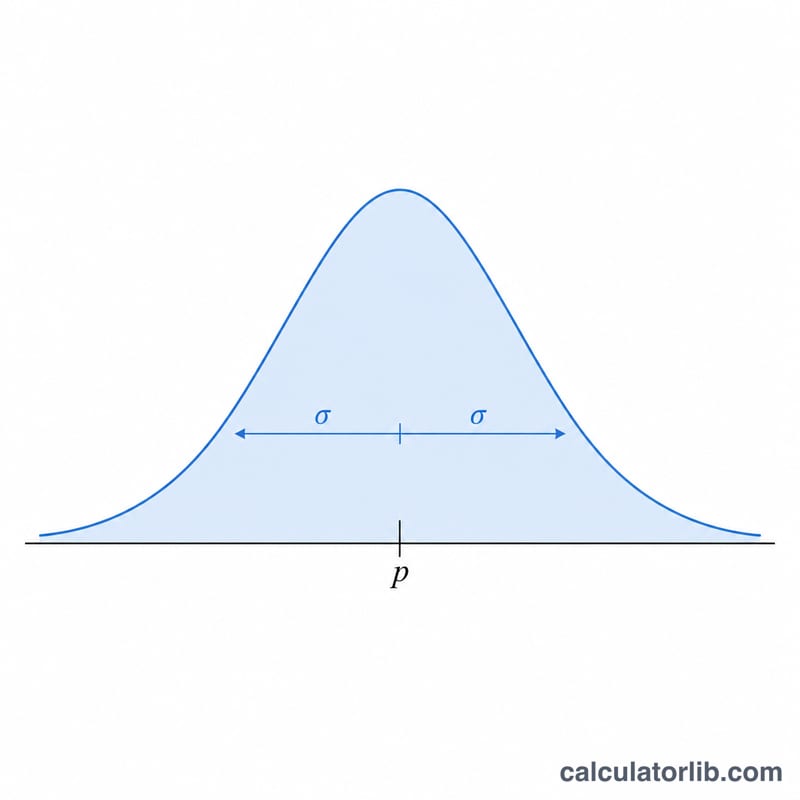
이 도구는 표본비율(p̂)의 표본분포를 설명해 줍니다. 실제 비율이 p인 모집단에서 크기 n의 무작위 표본을 반복해서 뽑으면, 그때마다 얻은 표본비율들이 모여 하나의 분포를 이룹니다. 이 계산기는 그 분포의 평균과 표준오차를 알려 주므로 신뢰구간을 구하거나, 가설검정을 수행하거나, 표본 변동성을 평가할 때 활용할 수 있습니다.
사용 방법
모비율 p를 0과 1 사이의 소수로 입력하세요(예: 40%라면 0.4). 그다음 표본 크기 n을 입력합니다. 계산기는 표본분포의 평균(곧 p와 같습니다), 분산, 그리고 표준오차(SE)를 즉시 출력합니다.
공식 설명
표본분포의 평균은 모비율과 같습니다: $$\mu_{\hat{p}} = \text{p}$$ 표준오차는 표본비율이 p를 중심으로 얼마나 흩어지는지를 나타내며 $$\sigma_{\hat{p}} = \sqrt{\frac{\text{p}\,(1 - \text{p})}{\text{n}}}$$로 구합니다. 표본이 커질수록 표준오차는 작아지고, 추정값은 더 정밀해집니다. 중심극한정리에 따라 \(np \ge 10\)이고 \(n(1-p) \ge 10\)일 때 이 분포는 근사적으로 정규분포를 따릅니다.
계산 예시
p = 0.5, n = 100이라고 가정해 봅시다. 평균은 0.5입니다. 분산은 $$0.5 \times 0.5 / 100 = 0.0025$$이고, 표준오차는 \(\sqrt{0.0025} = 0.05\)입니다. 따라서 표본비율은 대체로 0.5에서 약 ±0.05 범위 안에 들어옵니다.
표본 크기와 비율이 표준오차에 미치는 영향
표본 비율의 표준오차는 \(SE = \sqrt{\frac{p(1-p)}{n} }\)입니다. 표는 네 가지 모집단 비율과 네 가지 표본 크기에 대한 SE를 보여 줍니다. 별표(*)는 \(np < 10\) 또는 \(n(1-p) < 10\)인 조합을 표시하며, 이 경우 정규 근사를 사용하면 안 됩니다.
| p | n = 25 | n = 100 | n = 400 | n = 1000 |
|---|---|---|---|---|
| 0.1 | 0.0600* | 0.0300 | 0.0150 | 0.0095 |
| 0.3 | 0.0917* | 0.0458 | 0.0229 | 0.0145 |
| 0.5 | 0.1000 | 0.0500 | 0.0250 | 0.0158 |
| 0.7 | 0.0917* | 0.0458 | 0.0229 | 0.0145 |
값은 소수점 넷째 자리에서 반올림했습니다. 표시된 셀은 다음과 같습니다:
- p = 0.1, n = 25: \(np = 2.5\)
- p = 0.3, n = 25: \(np = 7.5\)
- p = 0.7, n = 25: \(n(1-p) = 7.5\)
p = 0.1이고 n = 100인 경우 \(np = 10\)으로, 기준선을 정확히 충족합니다.
표가 보여 주는 내용
- n을 네 배로 늘리면 SE는 절반이 됩니다. n = 25에서 100, 400으로 갈 때마다 n은 4배가 되고 SE는 2로 나뉩니다. p = 0.5일 때: 0.1000, 0.0500, 0.0250.
- SE는 p = 0.5에서 가장 큽니다. \(p(1-p)\)는 0.25에서 최댓값을 갖기 때문입니다. p와 1 − p에 대한 값은 동일합니다(p = 0.3과 p = 0.7을 비교해 보십시오).
핵심 용어와 기호
- 모집단 비율 (p)
- 관심 특성을 가진 전체 모집단의 실제 비율입니다. 보통 알려져 있지 않으며 0과 1 사이에 있습니다.
- 표본 비율 (\(\hat{p}\))
- 표본에서 성공의 비율입니다: \(\hat{p} = X/n\), 여기서 X는 성공 횟수입니다.
- 표본 크기 (n)
- 각 표본에 포함된 독립적인 관측값의 개수입니다.
- 표집분포
- 같은 모집단에서 크기 n인 모든 가능한 표본에 대한 \(\hat{p}\)의 분포입니다. 평균은 p이고 표준편차는 \(\sqrt{p(1-p)/n}\)입니다.
- 표준오차 대 표준편차
- 표준편차는 개별 값의 흩어짐을 측정합니다(0/1 관측값 하나에 대해서는 \(\sqrt{p(1-p)}\)). 표준오차는 \(\hat{p}\)와 같은 통계량의 표준편차이며, n이 커질수록 줄어듭니다.
- 불편추정량
- 반복 표본에서의 평균이 추정하려는 모수와 같은 통계량입니다. \(\mu_{\hat{p}} = p\)이므로 표본 비율은 p의 불편추정량입니다.
- 중심극한정리와 성공-실패 조건
- n이 충분히 크면 \(\hat{p}\)의 표집분포는 대략 정규분포를 따릅니다. 일반적인 경험 법칙은 독립적인 관측값과 함께 \(np \ge 10\) 및 \(n(1-p) \ge 10\)을 요구합니다(일부 교재는 5를 사용합니다). 이 기준에 못 미치면 분포는 눈에 띄게 치우쳐 있으며, 정규분포 기반 확률이 부정확할 수 있습니다.
자주 묻는 질문
왜 평균이 p와 같나요? 표본비율은 모비율의 불편추정량이기 때문입니다. 즉 평균적으로 참값을 정확히 맞춥니다.
n이 커지면 어떻게 되나요? 표준오차가 \(1/\sqrt{n}\)에 비례해 감소하므로, 표본이 클수록 추정이 더 정밀해집니다.
정규근사는 언제 유효한가요? 흔히 쓰는 기준은 \(np \ge 10\)이고 \(n(1-p) \ge 10\)입니다. 이 조건을 충족하지 못하면 정확한 이항분포 방법을 고려하세요.