這個計算器的功能
這個工具能告訴你:若想在特定信心水準下,將母體比例的估計誤差控制在某個範圍內,究竟需要訪問多少人。它廣泛應用於市場調查、民意調查、品質管制與學術研究。由於本工具純屬統計運算,不涉及任何國家的法規,因此在世界各地都適用。
使用方式
先選擇信心水準(90%、95% 或 99%),接著輸入你能接受的誤差範圍(例如 5%),再填入預估的比例。如果手邊沒有任何先前資料可供參考,建議直接填 50%——這是最保守的數值,會算出最大、也最安全的樣本數。此外,你也可以選擇性地輸入母體總人數,套用「有限母體校正」;當母體規模較小時,這項校正能有效降低所需的抽樣人數。
公式解析
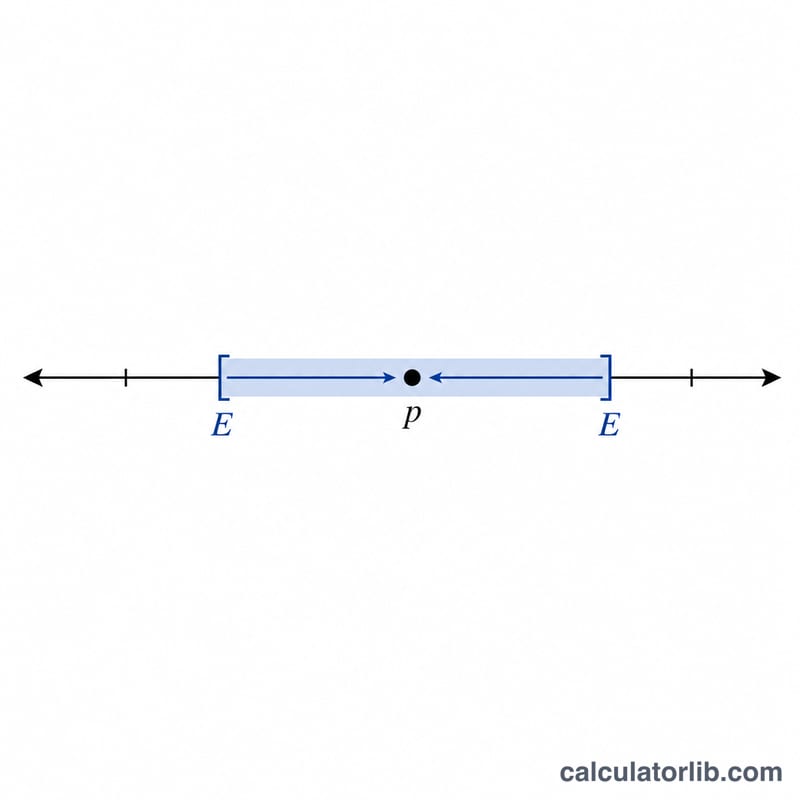
核心公式為 $$n = \dfrac{z^2 \cdot \hat{p}\,(1 - \hat{p})}{e^2}$$。其中 \(z\) 是對應信心水準的標準常態臨界值(90% 為 1.645、95% 為 1.96、99% 為 2.576),\(p\) 是以小數表示的預估比例,\(E\) 則是以小數表示的誤差範圍。\(p(1 - p)\) 在 \(p = 0.5\) 時達到最大值,這正是 50% 會得出最大樣本數的原因。若有輸入有限母體 \(N\),計算結果會再乘上校正因子加以縮減:$$n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}$$。
實際範例
假設你希望達到 95% 信心水準(\(z = 1.96\))、誤差範圍為 5%(\(E = 0.05\)),並假設 \(p = 0.5\)。那麼 $$n = \dfrac{1.96^2 \times 0.5 \times 0.5}{0.05^2} = \dfrac{3.8416 \times 0.25}{0.0025} = \dfrac{0.9604}{0.0025} = 384.16$$,無條件進位後即為 385 位受訪者。
各信賴水準的 Z 分數臨界值
| 雙尾信賴水準 | 臨界值 z |
|---|---|
| 80% | 1.282 |
| 85% | 1.440 |
| 90% | 1.645 |
| 95% | 1.960 |
| 98% | 2.326 |
| 99% | 2.576 |
| 99.9% | 3.291 |
這些是標準常態分位數,機率為 \(1 - \alpha/2\),其中 \(\alpha = 1 - \text{信賴水準}\)。對於 95% 信賴水準,\(\alpha = 0.05\),因此 z 為標準常態分布的第 97.5 百分位數,約為 1.960。
解讀所需樣本數
- 誤差邊際涵蓋的範圍: 此公式假設為簡單隨機抽樣,並在指定信賴水準下估計單一比例。它只反映隨機抽樣誤差。它不考慮無回應、涵蓋範圍問題或抽樣偏誤,因此這個數字是你需要的已完成且可用的回覆數,而不是寄出的邀請數。若你預期回應率為 20%,你必須邀請遠多於 n 的人數。
- 95% 信賴水準的意義: 若你重複進行調查多次,並每次都用此方法建立區間,約 95% 的區間會包含真實的母體比例。這並不表示真實值落在某一個特定計算區間內的機率為 95%。
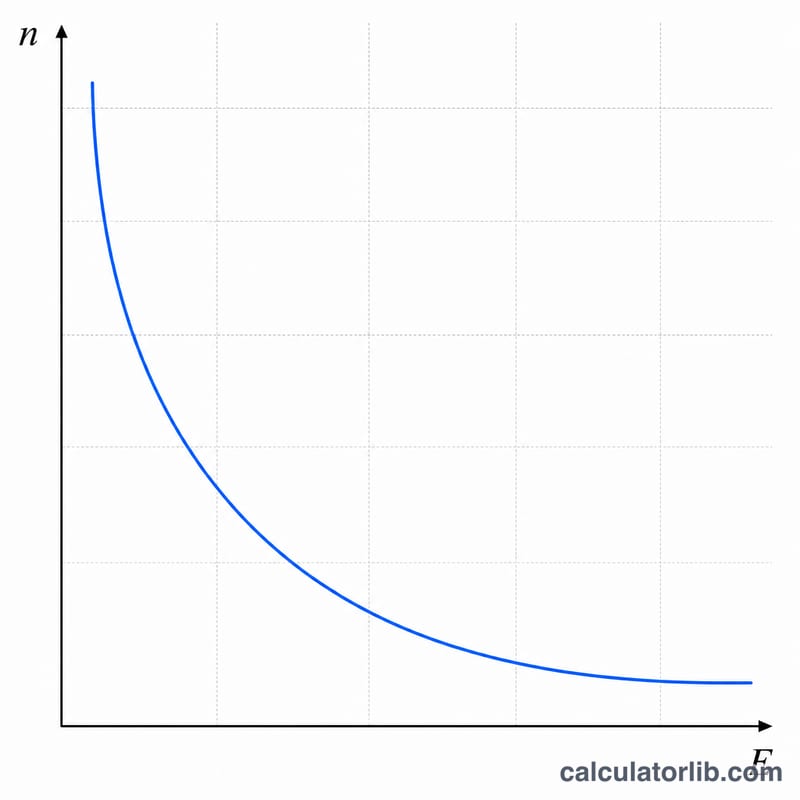
- 遞減報酬: n 隨 \(1/E^2\) 成長,因此縮小誤差邊際的成本會迅速上升。在 95% 信賴水準下,將誤差邊際從 5% 降至 3%,會使 n 從 385 增至 1,068,而從 10% 降至 5% 只會增加約 288 份回覆。
- p 的選擇: \(\hat{p} = 0.5\) 會使 \(\hat{p}(1-\hat{p})\) 最大化,並得出最大且最保守的 n。只有在你有可靠的事前估計時,才使用其他數值。
- 有限母體校正: 調整公式 \(n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}\) 主要在 \(n_0\) 超過母體大小 N 的約 5% 時才有影響。對於大型母體幾乎沒有變化;對於小型母體,則可能明顯降低所需樣本數。
- 子群組: 誤差邊際適用於整體樣本。子群組(例如依年齡或地區)的結果具有較大的誤差邊際,除非每個子群組各自有足夠的樣本數。
常見問題
沒有任何預估值時,該用多少比例?請填 50%——它會讓所需樣本數達到最大,確保你設定的誤差範圍一定能達成。
為什麼要無條件進位?樣本數必須是整數,採用無條件進位可確保實際誤差不會超出你設定的範圍。
母體大小什麼時候才會有影響?只有當母體相對於 \(n_0\) 偏小時(例如幾千人或更少),有限母體校正才會明顯減少所需樣本數。