この計算ツールでできること
コンバージョン率のテストで必ず出てくる3つの問いに答えます。テストを計画では、狙った改善を検出するのに各パターンが何人の訪問者を必要とし、現在のトラフィックで何日かかるかを求めます。サンプル数が決まっている場合はその逆で、手元の訪問者数でどれだけの検出力があり、目標検出力でどこまで小さな効果を検出できるかを示します。結果を分析では、AとBのコンバージョン数と訪問者数から、観測された改善率、2群の比率のz検定によるp値と信頼区間、そしてBがAを上回るベイズ確率を返します。いずれもランダムなシミュレーションを使わず厳密に計算します。
初期表示は例として、現在の率5%、相対MDE 10%、両側α = 5%、検出力80%です。ご自身の数値に置き換えてください。
サンプルサイズの公式
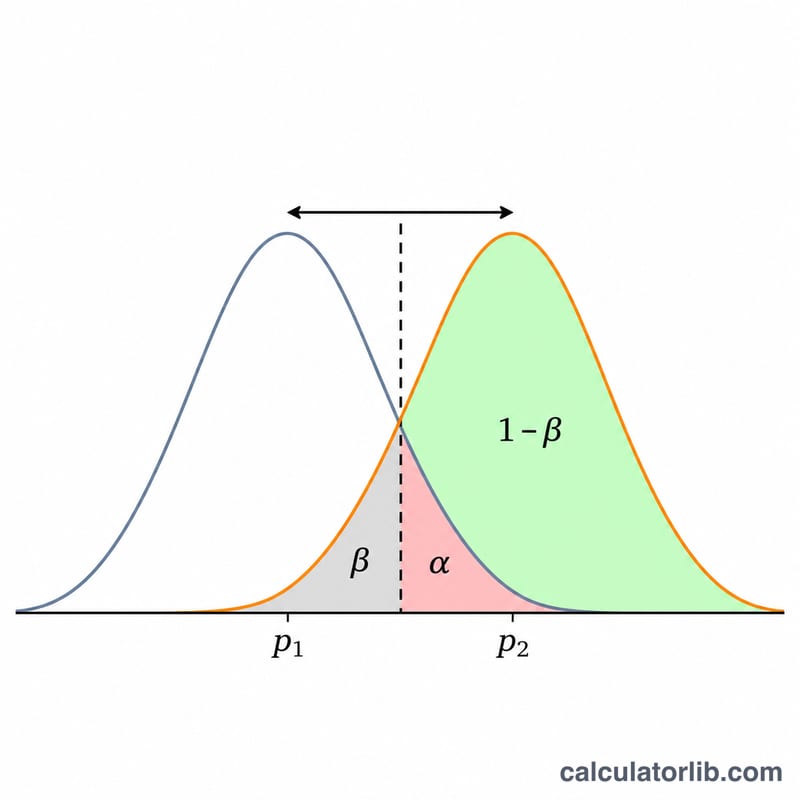
コンバージョン率が \( p_1 \)(オリジナル)と \( p_2 \)(テストパターン)の同じ大きさの2群で、1群あたりに必要な訪問者数は
$$ n = \frac{\left( z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} + z_{1-\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2-p_1)^2}, \qquad \bar p = \frac{p_1+p_2}{2} $$です。両側検定では \( s = 2 \)、片側検定では \( s = 1 \)、\( z \) は標準正規分布の分位点です。これは Fleiss, Levin, Paik『Statistical Methods for Rates and Proportions』(第3版, 2003)の式4.14で、帰無仮説の下の標準偏差には併合した率 \( \bar p \) を、対立仮説の下では各群の率を別々に使います。最後に行うプールしたz検定と同じ正規近似なので、計画と分析が一致します。結果は整数に切り上げます。
表には Fleiss, Tytun, Ury(1980)の連続性補正を加えたサイズ \( n_{cc} = \frac{n}{4}\left(1+\sqrt{1+\frac{4}{n\,|p_2-p_1|} }\right)^2 \) も示します。教科書の数表には、この大きめで保守的な値が載っていることがよくあります。
確認できる計算例
Fleiss, Levin, Paik, 74ページ:\( p_1 = 0.60 \)、\( p_2 = 0.70 \)、両側α = 1%、検出力95%。公式の値は807.07で1群808人、連続性補正ありでは827人となり、書籍の数値と一致します。検出力75%では479.6(480)、補正ありでは499.4です。書籍の表記は499で、本ツールは切り上げて500と表示します。再現するには効果の表し方で絶対差を選び、現在の率に60、効果に10を入力します。
Ryan(2013)、NCSS PASS マニュアルでの検証例:片側α = 5%、検出力80%、55%対65% → 295.7、つまり1群296人。
初期表示の例:現在の率5%で相対10%の改善とは、5%に対して5.5%を検出することです。両側α = 5%、検出力80%なら、パターンあたり31,234人、合計62,468人が必要で、1日2,000人なら32日かかります。
相対的なMDEと絶対的なMDE
5%に対する相対10%の効果は5.5%を意味します(\( p_2 = p_1(1+\text{MDE}) \))。絶対1ポイントの効果は6%です(\( p_2 = p_1 + \text{MDE} \))。\( n \) は \( 1/(p_2-p_1)^2 \) に比例するので、効果を半分にすると必要なサンプルはおよそ4倍になります。率が低いほどコストは大きく、同じ相対改善でも1%の率では5%の率の約5倍の訪問者が必要です。
複数パターンとボンフェローニ補正
オリジナルを含めて \( k \) パターンある場合、\( k-1 \) 個のパターンをそれぞれオリジナルと比較し、全グループに同じ \( n \) を割り当てるので、合計は \( k \cdot n \) です。比較が1つ増えるごとに、誤って「勝ち」と判定する機会も増えます。ボンフェローニ補正(Dunn, 1961)は各比較を \( \alpha/(k-1) \) で検定し、偽陽性が1つ以上出る確率を \( \alpha \) 以下に抑えます。保守的な方法で、全グループの \( n \) が大きくなります。
サンプル数が決まっているときの検出力とMDE
同じ式を検出力について解くと次のとおりです。
$$ 1-\beta = \Phi\!\left( \frac{|p_2-p_1|\sqrt{n} - z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} }{\sqrt{p_1(1-p_1)+p_2(1-p_2)} } \right) $$入力した効果に対してこの値を計算し、さらに目標検出力に届く最小の改善を探します。たとえば結果にかかわらず2週間だけ実施するキャンペーンのように、トラフィックが決まっているときに使います。検出できる改善が現実的な変化よりはるかに大きいなら、そのテストから得られる情報はわずかです。
結果の読み方:p値と信頼区間
\( n_A \) 人中 \( x_A \) 件、\( n_B \) 人中 \( x_B \) 件のコンバージョンがあったとき、プールしたz統計量は \( z = (\hat p_B-\hat p_A)/\sqrt{\hat p(1-\hat p)(1/n_A+1/n_B)} \)、ただし \( \hat p = (x_A+x_B)/(n_A+n_B) \) です。両側p値は \( 2(1-\Phi(|z|)) \)、Bの方が良いという仮説に対する片側p値は \( 1-\Phi(z) \) です。差の信頼区間にはプールしない標準誤差を使います:\( (\hat p_B-\hat p_A) \pm z_{1-\alpha/2}\sqrt{\hat p_A(1-\hat p_A)/n_A+\hat p_B(1-\hat p_B)/n_B} \)。例:10,000人中500件と10,000人中560件では z = 1.894、p = 0.0583 となり、観測された12%の改善は有意水準5%では有意ではありません。B − A の95%信頼区間は −0.02 から +1.22 ポイントです。
BがAを上回るベイズ確率
一様事前分布 Beta(1, 1) のもとで、\( n \) 人中 \( x \) 件のコンバージョン後の事後分布は Beta(\( 1+x \), \( 1+n-x \)) です(Gelman ほか『Bayesian Data Analysis』第3版、第2章)。パラメータが整数なので、Bの率の方が高い確率は厳密な有限和で表せます。
$$ P(p_B>p_A) = \sum_{i=0}^{\alpha_B-1} \frac{B(\alpha_A+i,\ \beta_A+\beta_B)}{(\beta_B+i)\,B(1+i,\ \beta_B)\,B(\alpha_A,\ \beta_A)} $$ここで \( \alpha = 1+x \)、\( \beta = 1+n-x \)、\( B \) はベータ関数で、Evan Miller による導出です。対数空間で評価するため乱数に依存せず、毎回同じ答えになります。Bを採用した場合の期待損失 \( E[\max(p_A-p_B, 0)] \) は、パラメータをずらした同じ和から求めます。これは、実はBの方が悪かった場合に失うと見込まれるコンバージョン率です。上の例では P(B > A) = 97.08%、Bを採用した場合の期待損失は0.0036ポイントです。「97%の確率で良い」と「5%水準で有意でない」は別の問いへの答えで、どちらもテストを早く止めてよい理由にはなりません。
途中で結果を見ると固定期間のテストが崩れる理由
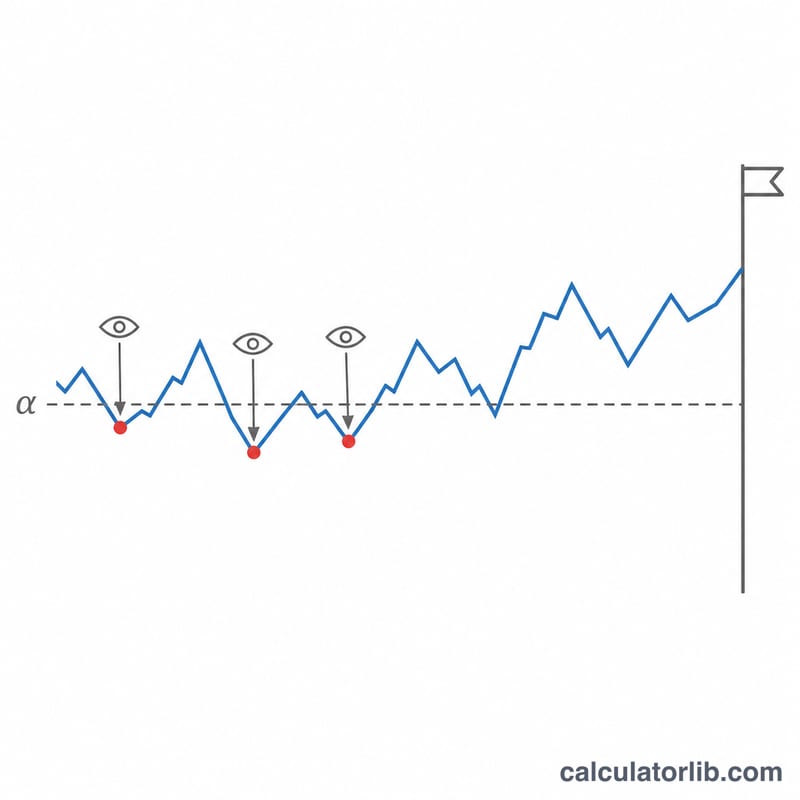
上のサンプルサイズは、データを最後に1回だけ見ることを前提にしています。バッチごとに確認し、最初に p < 0.05 になった時点で止めると、確認のたびに偽陽性の機会が増えます。この影響を最初に定量化したのは Armitage, McPherson, Rowe(1969)です。以下は、検定統計量の同時正規分布を数値積分で厳密に計算した結果です(両側5%検定、等間隔の確認、実際の差なし)。
| データを確認した回数 | 誤って「勝ち」と判定する確率 |
|---|---|
| 1 | 5.0% |
| 2 | 8.3% |
| 3 | 10.7% |
| 5 | 14.2% |
| 10 | 19.3% |
| 20 | 24.8% |
実施中にモニタリングしたい場合は、そのための設計を使ってください。O'Brien と Fleming(1979)のような群逐次境界は、早い段階の確認ではαをほとんど使わず、全体の偽陽性率をαに保ちます。Lan と DeMets(1983)のα消費関数を使えば、事前に決めていない時点でも確認できます。混合逐次確率比検定(mSPRT; Johari, Koomen, Pekelis, Walsh)による常に有効な推論では、いつ確認しても有効なp値が得られます。いずれも、その自由と引き換えに固定期間のテストより大きな最大サンプルが必要です。
前提と限界
公式は、訪問者が互いに独立であること、テスト期間中にコンバージョン率が安定していること、公平に無作為に振り分けられていることを前提としています。曜日の影響を均すため週単位で実施し、配分が計画どおりかを確認し、各訪問者を1回だけ数えてください。サンプルがごく小さい場合や率が0%・100%に近い場合は正規近似が粗くなるため、正確検定の方が安全です。
関連ツール
テストが終わったら、A/Bテスト有意差計算ツールで2つのコンバージョン率の差が統計的に有意かどうかを、Z値とp値で確認できます。
アンケートや世論調査を行うなら、サンプルサイズ計算ツールで、信頼水準と許容誤差に応じて必要な回答数を算出できます。