このサンプルサイズ計算ツールでできること
このツールは、ある母集団について統計的に信頼できる結果を得るために、何人(または何件)を調査すればよいかを算出します。有限母集団修正の標準的な公式を採用しているため、母集団が無限に大きいと仮定せず、対象となるグループの実際の規模に合わせた回答数を返します。アンケート、世論調査、マーケットリサーチ、学術研究など、世界中で活用されている手法です。統計学に基づく普遍的な計算であり、特定の国の制度に依存するものではありません。
3つの入力項目について
- 母集団の規模(N):結論を導きたい対象グループの総数です。たとえば「登録顧客5万人」などが該当します。初期値は1,000,000です。
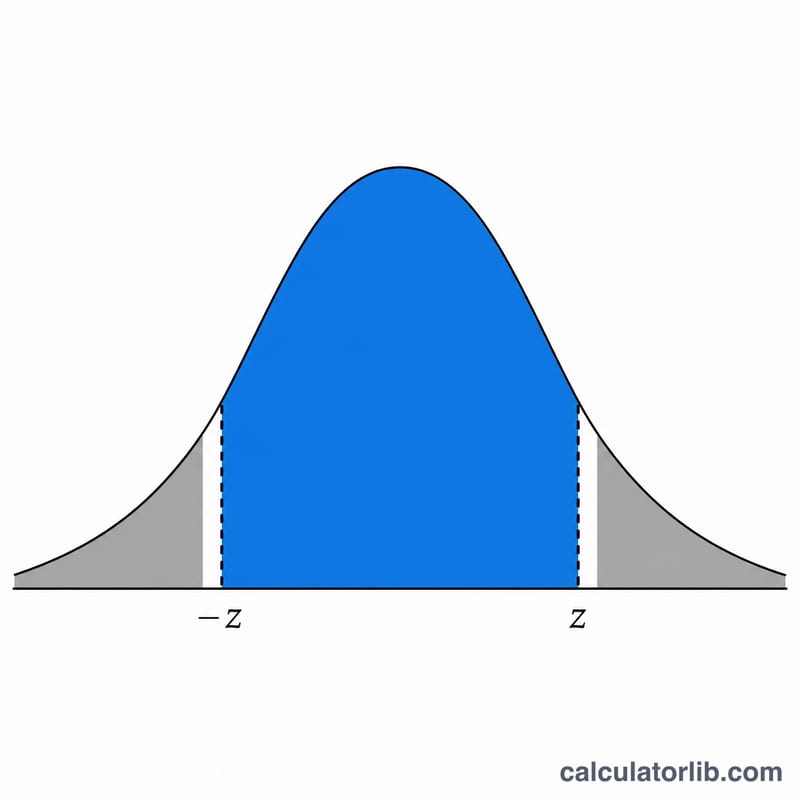
- 信頼水準(%):真の値が許容誤差の範囲内に収まることを、どの程度の確からしさで保証したいかを示します。一般的には90%・95%・99%が用いられます。本ツールは正規分布に基づき、この値をzスコアに変換します(95% → \(z \approx 1.96\))。
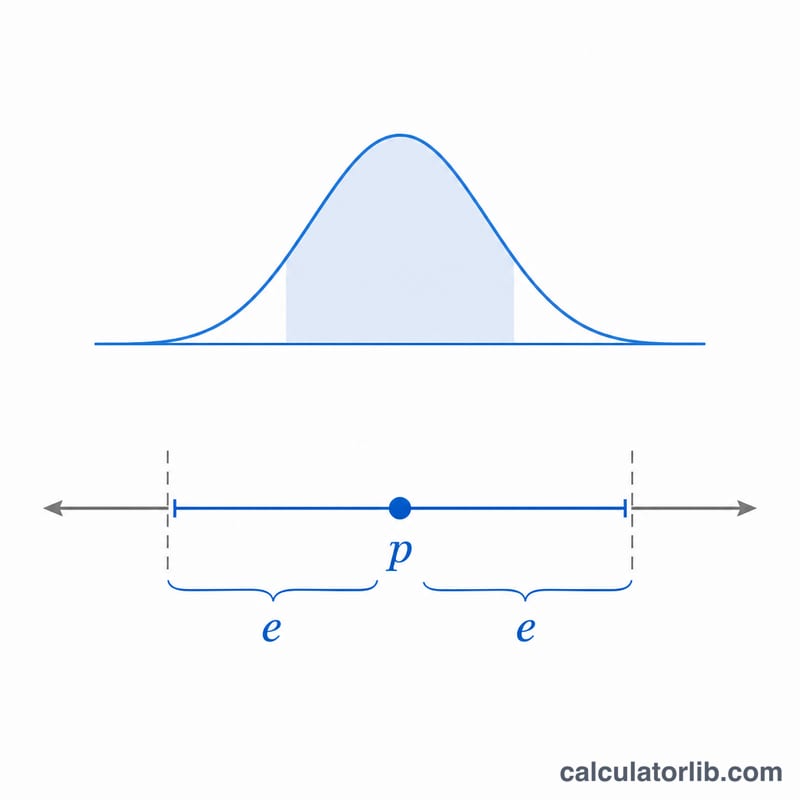
- 許容誤差(%):結果に対して許容できる誤差の幅です(例:±5%)。誤差を小さくするほど、必要なサンプルサイズは大きくなります。
計算式
本ツールは、有限母集団修正を加えたサンプルサイズの公式を用います。
$$n = \frac{\dfrac{z^{2}\,p\,(1-p)}{e^{2}}}{1 + \dfrac{z^{2}\,p\,(1-p)}{e^{2}\,N}}$$
ここで\(z\)は信頼水準から求まるzスコア、\(p\)は想定される回答割合(必要サンプル数が最大となり最も安全な見積もりになるため0.5に固定)、\(e\)は小数で表した許容誤差、\(N\)は母集団の規模です。結果は切り上げて表示するため、サンプル数が不足することはありません。
計算例
母集団が5万人、信頼水準95%、許容誤差5%とした場合を考えます。
- \(z = 1.96\)、\(p = 0.5\)、\(e = 0.05\)、\(N = 50{,}000\)
- 分子:\(1.96^{2} \times 0.5 \times 0.5 / 0.05^{2} = 0.9604 / 0.0025 = 384.16\)
- 分母:\(1 + 384.16 / 50{,}000 = 1.00768\)
- \(n = 384.16 / 1.00768 \approx 381.2\) → 切り上げて382
したがって、必要な調査回答数は382人となります。
信頼水準ごとのZスコア
この計算機は、信頼水準を両側検定のZスコアに変換します。\(z = \Phi^{-1}\left(1 - \alpha/2\right)\) で、\(\alpha = 1 - \text{信頼水準}\) です。信頼水準が高いほどZスコアは大きくなり、必要な標本サイズも大きくなります。
| 信頼水準 | α(1 − 信頼水準) | 両側検定のZスコア |
|---|---|---|
| 80% | 0.20 | 1.282 |
| 85% | 0.15 | 1.440 |
| 90% | 0.10 | 1.645 |
| 95% | 0.05 | 1.960 |
| 98% | 0.02 | 2.326 |
| 99% | 0.01 | 2.576 |
| 99.9% | 0.001 | 3.291 |
標本サイズの解釈
- 招待数ではなく、完了した回答数です。 結果は、必要とする完了済みで有効な回答の数を示します。回答率が20%と見込まれる場合は、約5倍の人数に連絡する必要があります。
- 無作為抽出を前提としています。 標本サイズが示す誤差の範囲と信頼水準は、回答者が母集団から無作為に選ばれている場合にのみ有効です。便宜的なサンプルや回答率の低さは、nがどれだけ大きくても結果に偏りをもたらす可能性があります。
- 部分集団の誤差の範囲は広くなります。 誤差の範囲は標本全体に適用されます。部分集団を分析する場合、その誤差の範囲は部分集団自体の人数に基づきます。例えば、p = 0.5、信頼水準95%で部分集団が100人の場合、誤差の範囲は約\(1.96\sqrt{0.25/100} \approx 0.098\)、すなわち±9.8%になります。
- 収穫逓減。 \(n \propto 1/e^{2}\) であるため、誤差の範囲を半分にすると、必要な標本サイズはおおよそ4倍になります。信頼水準95%で母集団が大きい場合、±5%には約385件の回答が必要ですが、±2.5%には約1,537件が必要です。
- 有限母集団補正。 計算式中の補正係数 \(1 + \dfrac{n_0}{N}\) は、主に標本が母集団の約5%を超える場合に影響します。母集団が非常に大きい場合、結果はNによってほとんど変わりません。
例:N = 10,000、信頼水準95%、誤差の範囲5%の場合、まず \(n_0 = \dfrac{1.96^{2}\cdot 0.5\cdot 0.5}{0.05^{2}} = 384.16\) を計算します。次に \(n = \dfrac{384.16}{1 + 384.16/10000} = \dfrac{384.16}{1.038416} \approx 369.97\) となり、切り上げて370件の完了した回答が必要です。
この計算機はp = 0.5を前提としています。これは最も保守的な比率であり、最大の標本サイズを与えます。信頼できる事前の比率推定値がある場合は、より小さな標本サイズで十分かもしれませんが、0.5は安全な初期値です。これは一般的な統計情報であり、金融または医療に関する助言ではありません。
関連ツール
これからA/Bテストを計画するなら、A/Bテストのサンプルサイズ・検出力計算で各パターンに必要な訪問者数がわかり、BがAを上回る正確なベイズ確率も求められます。
テストが終わったら、A/Bテスト有意差計算ツールで2つのコンバージョン率の差が統計的に有意かどうかを、Z値とp値で確認できます。
よくある質問
なぜpを0.5に設定するのですか?真の割合が不明な場合、\(p = 0.5\)のときに必要サンプルサイズが最大になります。これにより、実際の結果がどうであっても十分な精度が確保できます。
母集団が非常に大きい場合はどうなりますか?母集団が膨大になると修正項はほぼ無視できるようになり、サンプルサイズはより単純な式 \(n = z^{2}p(1-p)/e^{2}\)(95%/5%でおよそ385)に近づきます。
必要なサンプル数を減らすには?許容誤差を大きくするか、信頼水準を下げてください。逆にどちらかを厳しくすると、必要なサンプル数は大幅に増加します。