यह सैंपल साइज़ कैलकुलेटर क्या करता है
यह कैलकुलेटर बताता है कि किसी दी गई पॉपुलेशन के लिए सांख्यिकीय रूप से भरोसेमंद नतीजे पाने के वास्ते आपको कितने लोगों (या वस्तुओं) का सर्वे करना होगा। इसमें स्टैंडर्ड फ़ाइनाइट-पॉपुलेशन करेक्शन फ़ॉर्मूला इस्तेमाल होता है, इसलिए जवाब आपके टारगेट ग्रुप के आकार के हिसाब से तय होता है, न कि किसी अनंत बड़ी पॉपुलेशन को मानकर। दुनिया भर में सर्वे, ओपिनियन पोल, मार्केट रिसर्च और एकेडमिक स्टडी के लिए इसका उपयोग होता है — ये सांख्यिकी सार्वभौमिक हैं और किसी एक देश तक सीमित नहीं।
तीनों इनपुट का मतलब
- पॉपुलेशन साइज़ (N): वह कुल संख्या जिनके बारे में आप निष्कर्ष निकालना चाहते हैं — जैसे, 50,000 रजिस्टर्ड ग्राहक। डिफ़ॉल्ट मान 1,000,000 है।
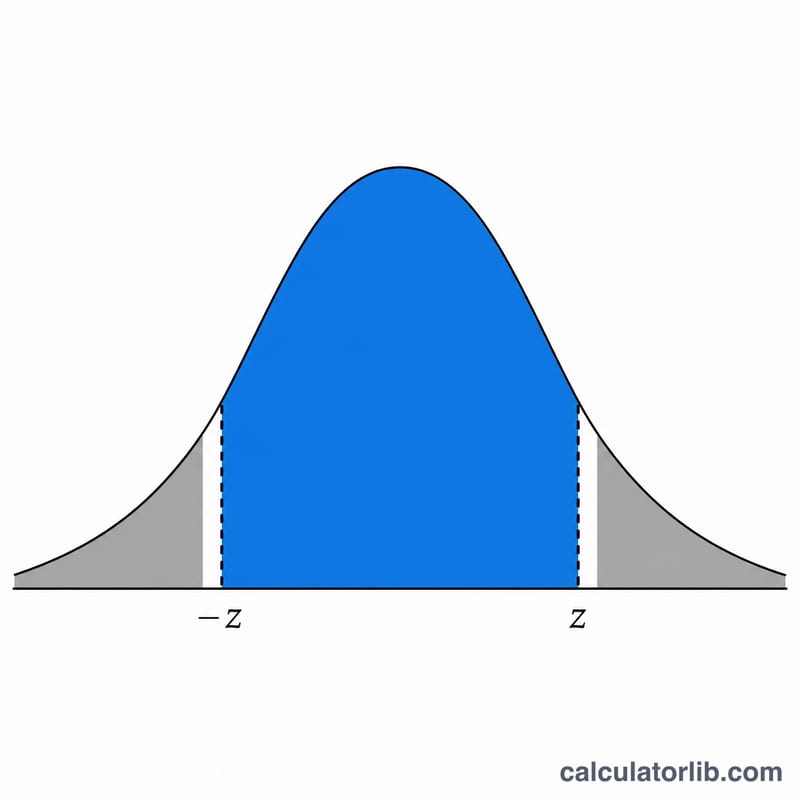
- कॉन्फिडेंस लेवल (%): आप कितने भरोसे के साथ चाहते हैं कि असली मान आपके मार्जिन के भीतर रहे। आम तौर पर 90%, 95% और 99% चुने जाते हैं। कैलकुलेटर इसे नॉर्मल डिस्ट्रिब्यूशन की मदद से z-स्कोर में बदल देता है (95% → \(z \approx 1.96\))।
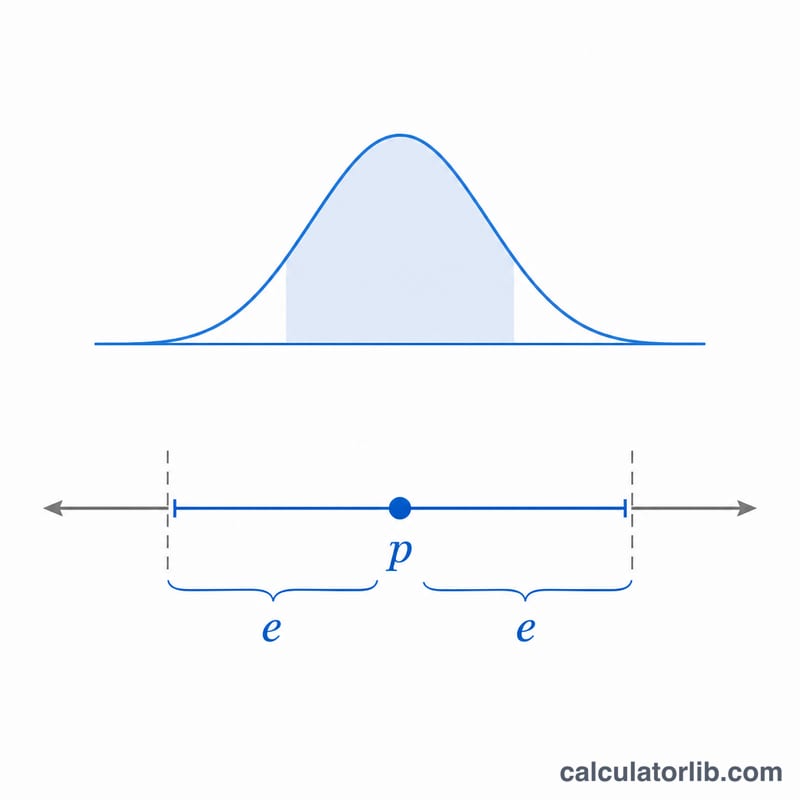
- मार्जिन ऑफ़ एरर (%): आपके नतीजे के इर्द-गिर्द स्वीकार्य त्रुटि की सीमा, जैसे ±5%। मार्जिन जितना छोटा होगा, सैंपल उतना बड़ा चाहिए।
फ़ॉर्मूला
यह कैलकुलेटर फ़ाइनाइट-पॉपुलेशन करेक्शन वाला सैंपल साइज़ फ़ॉर्मूला लगाता है:
$$n = \frac{\dfrac{z^{2}\,p\,(1-p)}{e^{2}}}{1 + \dfrac{z^{2}\,p\,(1-p)}{e^{2}\,N}}$$यहाँ \(z\) आपके कॉन्फिडेंस लेवल से मिला z-स्कोर है, \(p\) मानी गई रिस्पॉन्स प्रोपोर्शन है (इसे 0.5 पर तय रखा जाता है क्योंकि इससे ज़रूरी सैंपल सबसे बड़ा बनता है और अनुमान सबसे सुरक्षित रहता है), \(e\) मार्जिन ऑफ़ एरर को दशमलव में दर्शाता है, और \(N\) पॉपुलेशन साइज़ है। नतीजे को ऊपर की ओर पूर्णांकित किया जाता है ताकि सैंपल कभी कम न पड़े।
हल किया हुआ उदाहरण
मान लीजिए आपकी पॉपुलेशन 50,000 लोगों की है, आप 95% कॉन्फिडेंस और 5% मार्जिन ऑफ़ एरर चाहते हैं।
- \(z = 1.96,\ p = 0.5,\ e = 0.05,\ N = 50{,}000\)
- अंश (Numerator): $$\frac{1.96^{2} \times 0.5 \times 0.5}{0.05^{2}} = \frac{0.9604}{0.0025} = 384.16$$
- हर (Denominator): $$1 + \frac{384.16}{50{,}000} = 1.00768$$
- \(n = \dfrac{384.16}{1.00768} \approx 381.2\) → ऊपर की ओर पूर्णांकित करके 382
यानी आपको 382 लोगों का सर्वे करना होगा।
आत्मविश्वास स्तरों के लिए Z-स्कोर
कैलकुलेटर आपके आत्मविश्वास स्तर को दो-पुच्छीय z-स्कोर में बदलता है, \(z = \Phi^{-1}\left(1 - \alpha/2\right)\), जहाँ \(\alpha = 1 - \text{आत्मविश्वास स्तर}\) है। अधिक आत्मविश्वास का अर्थ है बड़ा z-स्कोर और इसलिए आवश्यक नमूने का आकार भी बड़ा।
| आत्मविश्वास स्तर | Alpha (1 − आत्मविश्वास) | दो-पुच्छीय z-स्कोर |
|---|---|---|
| 80% | 0.20 | 1.282 |
| 85% | 0.15 | 1.440 |
| 90% | 0.10 | 1.645 |
| 95% | 0.05 | 1.960 |
| 98% | 0.02 | 2.326 |
| 99% | 0.01 | 2.576 |
| 99.9% | 0.001 | 3.291 |
अपने नमूना आकार की व्याख्या
- पूर्ण प्रतिक्रियाएँ, आमंत्रण नहीं। परिणाम उन पूर्ण, वैध प्रतिक्रियाओं की संख्या है जिनकी आपको आवश्यकता है। यदि आपको 20% प्रतिक्रिया दर की उम्मीद है, तो आपको लगभग पाँच गुना अधिक लोगों से संपर्क करना होगा।
- यादृच्छिक नमूनाकरण मान लिया गया है। नमूना आकार बताए गए त्रुटि मार्जिन और आत्मविश्वास स्तर का समर्थन तभी करता है जब उत्तरदाता जनसंख्या से यादृच्छिक रूप से चुने गए हों। सुविधा नमूने या अधिक गैर-प्रतिक्रिया n कितना भी बड़ा हो, परिणामों में पूर्वाग्रह ला सकते हैं।
- उप-समूहों के लिए मार्जिन चौड़े होते हैं। त्रुटि मार्जिन पूरे नमूने पर लागू होता है। यदि आप किसी उप-समूह का विश्लेषण करते हैं, तो उसका मार्जिन उप-समूह की अपनी गिनती पर आधारित होता है। उदाहरण के लिए, p = 0.5 और 95% आत्मविश्वास के साथ, 100 के उप-समूह का मार्जिन लगभग \(1.96\sqrt{0.25/100} \approx 0.098\), या ±9.8% है।
- घटते प्रतिफल। चूँकि \(n \propto 1/e^{2}\), त्रुटि मार्जिन को आधा करने से आवश्यक नमूना लगभग चार गुना हो जाता है। 95% आत्मविश्वास और बड़ी जनसंख्या पर, ±5% के लिए लगभग 385 प्रतिक्रियाओं की आवश्यकता होती है, जबकि ±2.5% के लिए लगभग 1,537 की।
- परिमित-जनसंख्या सुधार। सूत्र में सुधार कारक \(1 + \dfrac{n_0}{N}\) मुख्य रूप से तब मायने रखता है जब नमूना जनसंख्या के लगभग 5% से अधिक हो। बहुत बड़ी जनसंख्या के लिए परिणाम N के साथ लगभग नहीं बदलता।
उदाहरण: N = 10,000, 95% आत्मविश्वास और 5% त्रुटि मार्जिन के साथ, पहले \(n_0 = \dfrac{1.96^{2}\cdot 0.5\cdot 0.5}{0.05^{2}} = 384.16\) की गणना करें। फिर \(n = \dfrac{384.16}{1 + 384.16/10000} = \dfrac{384.16}{1.038416} \approx 369.97\), जो ऊपर की ओर पूर्णांकित होकर 370 पूर्ण प्रतिक्रियाएँ होता है।
कैलकुलेटर p = 0.5 मानता है, जो सबसे सतर्क अनुपात है और सबसे बड़ा नमूना देता है। यदि आपके पास अनुपात का कोई विश्वसनीय पूर्व अनुमान है, तो छोटा नमूना पर्याप्त हो सकता है, लेकिन 0.5 एक सुरक्षित डिफ़ॉल्ट है। यह सामान्य सांख्यिकीय जानकारी है, वित्तीय या चिकित्सीय सलाह नहीं।
ये टूल भी देखें
A/B टेस्ट की योजना बना रहे हैं? A/B टेस्ट सैंपल साइज़ और पावर कैलकुलेटर बताता है कि हर वेरिएंट को कितने विज़िटर चाहिए, और साथ में B के A से बेहतर होने की सटीक बेज़ियन संभावना भी देता है।
टेस्ट पूरा हो गया? A/B टेस्ट सिग्निफिकेंस कैलकुलेटर Z-स्कोर और p-वैल्यू के साथ जाँचता है कि दो कन्वर्ज़न रेट का अंतर सांख्यिकीय रूप से महत्वपूर्ण है या नहीं।
अक्सर पूछे जाने वाले सवाल
p को 0.5 क्यों रखा जाता है? जब असली प्रोपोर्शन पता न हो, तो 0.5 सबसे बड़ा संभव सैंपल साइज़ देता है, जिससे असली नतीजा चाहे जो भी हो, आपका सर्वे पर्याप्त सटीक रहता है।
अगर मेरी पॉपुलेशन बहुत बड़ी हो तो? बहुत बड़ी पॉपुलेशन के लिए करेक्शन वाला हिस्सा नगण्य हो जाता है, इसलिए सैंपल साइज़ सरल फ़ॉर्मूला \(n = z^{2}p(1-p)/e^{2}\) के करीब पहुँच जाता है (95%/5% के लिए लगभग 385)।
ज़रूरी सैंपल कैसे घटाऊँ? थोड़ा बड़ा मार्जिन ऑफ़ एरर या कम कॉन्फिडेंस लेवल स्वीकार करें। इनमें से किसी को भी कसने पर ज़रूरी सैंपल काफ़ी बढ़ जाता है।