À quoi sert ce calculateur de taille d'échantillon
Ce calculateur vous indique le nombre de personnes (ou d'éléments) à interroger pour obtenir des résultats statistiquement fiables sur une population donnée. Il s'appuie sur la formule classique avec correction pour population finie : la réponse est donc adaptée à la taille réelle de votre groupe cible, et non calculée comme si la population était infinie. Cet outil est utilisé partout dans le monde pour les enquêtes, les sondages, les études de marché et les travaux universitaires — les principes statistiques sont universels et ne dépendent d'aucun pays en particulier.
Les trois paramètres à renseigner
- Taille de la population (\(N\)) : le nombre total d'individus du groupe sur lequel vous souhaitez tirer des conclusions — par exemple 50 000 clients inscrits. La valeur par défaut est de 1 000 000.
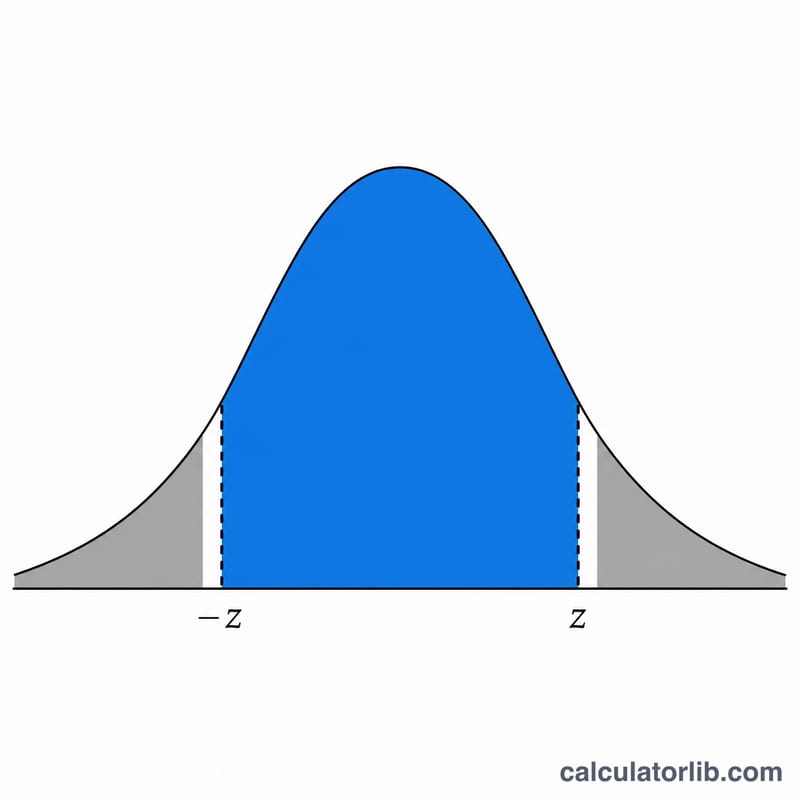
- Niveau de confiance (%) : le degré de certitude souhaité quant au fait que la vraie valeur se situe bien dans votre marge. Les choix les plus courants sont 90 %, 95 % et 99 %. Le calculateur convertit ce niveau en score \(z\) à partir de la loi normale (95 % → \(z \approx 1{,}96\)).
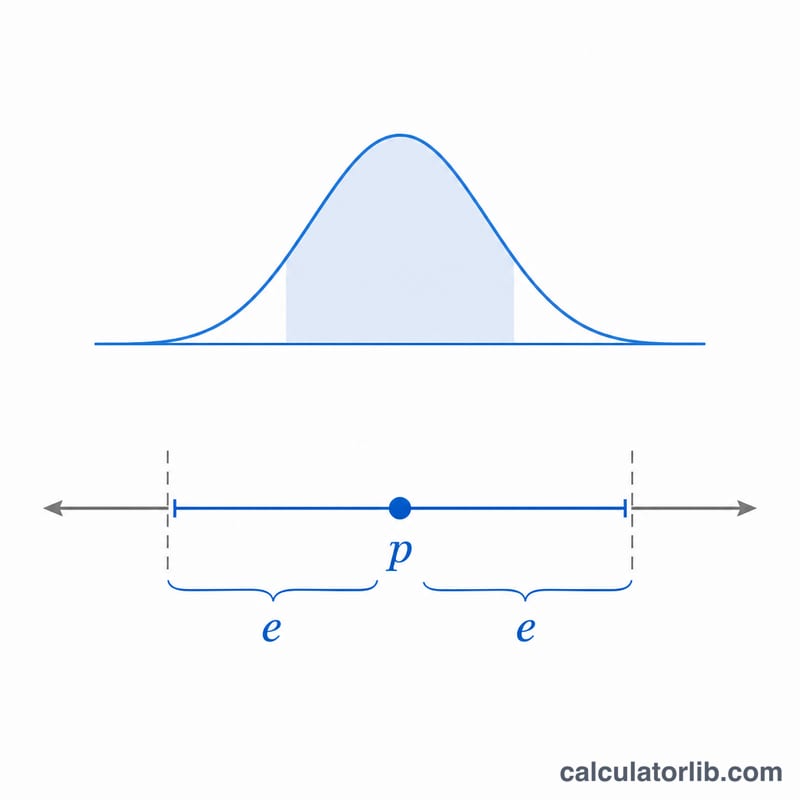
- Marge d'erreur (%) : l'écart d'erreur acceptable autour de votre résultat, par exemple ±5 %. Plus la marge est faible, plus l'échantillon doit être grand.
La formule
Le calculateur applique la formule de taille d'échantillon corrigée pour population finie :
$$n = \dfrac{\dfrac{z^{2}\,p\,(1-p)}{e^{2}}}{1 + \dfrac{z^{2}\,p\,(1-p)}{e^{2}\,N}}$$
Ici, \(z\) est le score z issu de votre niveau de confiance, \(p\) la proportion de réponse supposée (fixée à \(0{,}5\) car c'est la valeur qui maximise l'échantillon requis et offre l'estimation la plus prudente), \(e\) la marge d'erreur exprimée en décimale et \(N\) la taille de la population. Le résultat est arrondi au supérieur afin de ne jamais sous-dimensionner l'échantillon.
Exemple concret
Imaginons une population de 50 000 personnes, avec un niveau de confiance de 95 % et une marge d'erreur de 5 %.
- \(z = 1{,}96\), \(p = 0{,}5\), \(e = 0{,}05\), \(N = 50\,000\)
- Numérateur : $$1{,}96^{2} \times 0{,}5 \times 0{,}5 / 0{,}05^{2} = 0{,}9604 / 0{,}0025 = 384{,}16$$
- Dénominateur : $$1 + 384{,}16 / 50\,000 = 1{,}00768$$
- $$n = 384{,}16 / 1{,}00768 \approx 381{,}2 \rightarrow \text{arrondi au supérieur à } \mathbf{382}$$
Vous devriez donc interroger 382 personnes.
Scores z pour les niveaux de confiance courants
Le calculateur convertit votre niveau de confiance en score z bilatéral, \(z = \Phi^{-1}\left(1 - \alpha/2\right)\), où \(\alpha = 1 - \text{niveau de confiance}\). Plus le niveau de confiance est élevé, plus le score z est grand et donc plus la taille d'échantillon requise est importante.
| Niveau de confiance | Alpha (1 − confiance) | Score z bilatéral |
|---|---|---|
| 80 % | 0,20 | 1,282 |
| 85 % | 0,15 | 1,440 |
| 90 % | 0,10 | 1,645 |
| 95 % | 0,05 | 1,960 |
| 98 % | 0,02 | 2,326 |
| 99 % | 0,01 | 2,576 |
| 99,9 % | 0,001 | 3,291 |
Interpréter la taille de votre échantillon
- Réponses complètes, et non invitations. Le résultat correspond au nombre de réponses complètes et valides dont vous avez besoin. Si vous attendez un taux de réponse de 20 %, vous devez contacter environ cinq fois plus de personnes.
- Un échantillonnage aléatoire est supposé. La taille de l'échantillon ne garantit la marge d'erreur et le niveau de confiance indiqués que si les répondants sont sélectionnés au hasard dans la population. Les échantillons de convenance ou un taux élevé de non-réponse peuvent biaiser les résultats, quelle que soit la valeur de n.
- Les sous-groupes ont des marges plus larges. La marge d'erreur s'applique à l'ensemble de l'échantillon. Si vous analysez un sous-groupe, sa marge est calculée à partir de son propre effectif. Par exemple, avec p = 0,5 et un niveau de confiance de 95 %, un sous-groupe de 100 personnes a une marge d'environ \(1{,}96\sqrt{0{,}25/100} \approx 0{,}098\), soit ±9,8 %.
- Rendements décroissants. Comme \(n \propto 1/e^{2}\), diviser la marge d'erreur par deux multiplie à peu près par quatre la taille d'échantillon requise. À un niveau de confiance de 95 % et pour une grande population, ±5 % nécessite environ 385 réponses, tandis que ±2,5 % en nécessite environ 1 537.
- Correction pour population finie. Le facteur de correction \(1 + \dfrac{n_0}{N}\) de la formule n'a d'importance que lorsque l'échantillon dépasse environ 5 % de la population. Pour une population très grande, le résultat varie à peine avec N.
Exemple : avec N = 10 000, un niveau de confiance de 95 % et une marge d'erreur de 5 %, calculez d'abord \(n_0 = \dfrac{1{,}96^{2}\cdot 0{,}5\cdot 0{,}5}{0{,}05^{2}} = 384{,}16\). Puis \(n = \dfrac{384{,}16}{1 + 384{,}16/10000} = \dfrac{384{,}16}{1{,}038416} \approx 369{,}97\), ce qui donne, par arrondi supérieur, 370 réponses complètes.
Le calculateur suppose p = 0,5, la proportion la plus prudente, qui donne le plus grand échantillon. Si vous disposez d'une estimation fiable préalable de la proportion, un échantillon plus petit peut suffire, mais 0,5 est une valeur par défaut sûre. Il s'agit d'informations statistiques générales, et non de conseils financiers ou médicaux.
Voir aussi
Vous préparez un test A/B ? Le calculateur de taille d’échantillon et de puissance pour test A/B indique combien de visiteurs il faut par variante et donne la probabilité bayésienne exacte que B batte A.
Votre test est terminé ? Le calculateur de significativité A/B vérifie si l’écart entre deux taux de conversion est statistiquement significatif, avec le score Z et la p-value.
Questions fréquentes
Pourquoi fixer \(p\) à \(0{,}5\) ? Lorsque la vraie proportion est inconnue, la valeur \(0{,}5\) produit la taille d'échantillon la plus élevée possible. Votre enquête reste ainsi suffisamment précise, quel que soit le résultat réel.
Et si ma population est très grande ? Pour les populations très importantes, le terme de correction devient négligeable : la taille d'échantillon se rapproche alors de la formule plus simple \(n = z^{2}p(1-p)/e^{2}\) (soit environ 385 pour 95 %/5 %).
Comment réduire la taille d'échantillon nécessaire ? Acceptez une marge d'erreur plus large ou un niveau de confiance plus faible. Resserrer l'un ou l'autre augmente sensiblement l'échantillon requis.