这个计算器能做什么
它回答每个转化率实验都会遇到的三个问题。规划测试告诉你:要检测到设定的提升,每个版本需要多少访客,按当前流量需要多少天。样本量固定则反过来:对于已有的访客数,给出检测你设定效应的统计功效,以及在目标功效下能检测到的最小效应。分析结果根据 A、B 的转化数和访客数,给出观测到的提升、两比例 z 检验的 p 值和置信区间,以及 B 优于 A 的贝叶斯概率,全部精确计算,不使用随机模拟。
页面默认填入示例数据:当前转化率 5%、相对 MDE 10%、双侧 α = 5%、统计功效 80%。请换成你自己的数字。
样本量公式
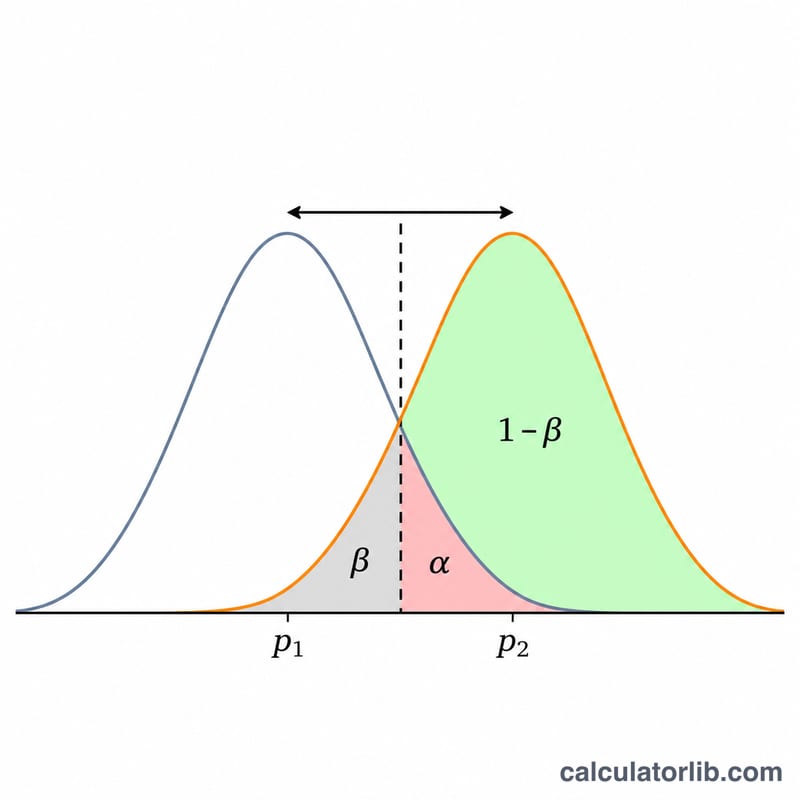
对于样本量相同、转化率分别为 \( p_1 \)(对照组)和 \( p_2 \)(实验组)的两组,每组所需访客数为
$$ n = \frac{\left( z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} + z_{1-\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2-p_1)^2}, \qquad \bar p = \frac{p_1+p_2}{2} $$其中双侧检验 \( s = 2 \),单侧检验 \( s = 1 \),\( z \) 为标准正态分布的分位数。这是 Fleiss、Levin 和 Paik《Statistical Methods for Rates and Proportions》(第 3 版,2003)中的公式 4.14:原假设下的标准差使用合并比例 \( \bar p \),备择假设下分别使用两组的比例。它与最后进行的合并 z 检验采用同一正态近似,因此规划与分析保持一致。结果向上取整。
表格中还给出 Fleiss、Tytun 和 Ury(1980)的连续性校正样本量 \( n_{cc} = \frac{n}{4}\left(1+\sqrt{1+\frac{4}{n\,|p_2-p_1|} }\right)^2 \)。教科书中的查表值往往就是这个更大、更保守的数字。
可以自行核对的例子
Fleiss、Levin 和 Paik,第 74 页:\( p_1 = 0.60 \),\( p_2 = 0.70 \),双侧 α = 1%,统计功效 95%。公式结果为 807.07,即每组 808 人;连续性校正后为 827 人,与书中数字一致。功效为 75% 时得到 479.6(480)人,校正后为 499.4 人:书中印为 499,本工具向上取整为 500。要在本工具中复现,请选择“绝对变化”,当前转化率填 60,效应填 10。
Ryan(2013),见 NCSS PASS 手册的验证示例:单侧 α = 5%,功效 80%,55% 对 65% → 295.7,即每组 296 人。
默认示例:当前转化率 5%、相对提升 10%,即要区分 5.5% 与 5%。双侧 α = 5%、功效 80% 时,每个版本需要 31,234 名访客,总计 62,468 名;按每天 2,000 名访客计算需要 32 天。
相对 MDE 还是绝对 MDE
在 5% 基础上相对提升 10% 意味着 5.5%(\( p_2 = p_1(1+\text{MDE}) \));绝对提升 1 个百分点意味着 6%(\( p_2 = p_1 + \text{MDE} \))。由于 \( n \) 与 \( 1/(p_2-p_1)^2 \) 成正比,效应减半,样本量大约变为四倍。基础转化率越低,成本越高:同样的相对提升,1% 的转化率所需访客约为 5% 转化率的五倍。
多个版本与 Bonferroni 校正
包含对照组共有 \( k \) 个版本时,\( k-1 \) 个实验组分别与对照组比较,每组分配相同的 \( n \),总量为 \( k \cdot n \)。每多一次比较,就多一次误判“胜出者”的机会。Bonferroni 校正(Dunn,1961)以 \( \alpha/(k-1) \) 检验每次比较,使至少出现一个假阳性的概率不超过 \( \alpha \)。这种方法偏保守,会使每组的 \( n \) 都变大。
样本量固定时的统计功效与 MDE
把同一方程对功效求解,得到:
$$ 1-\beta = \Phi\!\left( \frac{|p_2-p_1|\sqrt{n} - z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} }{\sqrt{p_1(1-p_1)+p_2(1-p_2)} } \right) $$计算器先对你设定的效应求出功效,再搜索在目标功效下可检测的最小提升。流量已经固定时使用此模式,例如不论结果如何都只运行两周的活动:如果可检测的提升远大于任何现实的变化,这个测试就很难告诉你有用的信息。
解读结果:p 值与置信区间
若 A 组 \( n_A \) 名访客中有 \( x_A \) 次转化,B 组 \( n_B \) 名中有 \( x_B \) 次,合并 z 统计量为 \( z = (\hat p_B-\hat p_A)/\sqrt{\hat p(1-\hat p)(1/n_A+1/n_B)} \),其中 \( \hat p = (x_A+x_B)/(n_A+n_B) \)。双侧 p 值为 \( 2(1-\Phi(|z|)) \);检验“B 更好”的单侧 p 值为 \( 1-\Phi(z) \)。差值的置信区间使用非合并标准误:\( (\hat p_B-\hat p_A) \pm z_{1-\alpha/2}\sqrt{\hat p_A(1-\hat p_A)/n_A+\hat p_B(1-\hat p_B)/n_B} \)。例如:10,000 名中 500 次对 10,000 名中 560 次,得到 z = 1.894,p = 0.0583,因此观测到的 12% 提升在 5% 水平下不显著,B − A 的 95% 置信区间为 −0.02 至 +1.22 个百分点。
B 优于 A 的贝叶斯概率
采用均匀先验 Beta(1, 1) 时,\( n \) 名访客中有 \( x \) 次转化后,转化率的后验分布为 Beta(\( 1+x \), \( 1+n-x \))(Gelman 等,《Bayesian Data Analysis》第 3 版,第 2 章)。由于参数都是整数,B 的转化率更高的概率可以写成精确的有限和:
$$ P(p_B>p_A) = \sum_{i=0}^{\alpha_B-1} \frac{B(\alpha_A+i,\ \beta_A+\beta_B)}{(\beta_B+i)\,B(1+i,\ \beta_B)\,B(\alpha_A,\ \beta_A)} $$其中 \( \alpha = 1+x \),\( \beta = 1+n-x \),\( B \) 为贝塔函数,推导见 Evan Miller。计算器在对数空间中求和,不依赖随机抽样,每次结果都相同。选择 B 的期望损失 \( E[\max(p_A-p_B, 0)] \) 由参数平移后的同一求和得到:它表示如果 B 实际上更差,你预计会损失的转化率。上例中 P(B > A) = 97.08%,选择 B 的期望损失为 0.0036 个百分点。“97% 的概率更好”和“在 5% 水平下不显著”回答的是不同问题,二者都不意味着可以提前停止测试。
为什么中途偷看会破坏固定期限测试
上面的样本量假设你只在结束时看一次数据。如果每批数据后都查看,并在第一次出现 p < 0.05 时停止,每次查看都会增加一次假阳性的机会。Armitage、McPherson 和 Rowe(1969)最早量化了这一效应。下表是我们对检验统计量的联合正态分布做精确数值积分得到的结果(5% 双侧检验,等间隔查看,实际无差异):
| 查看数据的次数 | 误判胜出者的概率 |
|---|---|
| 1 | 5.0% |
| 2 | 8.3% |
| 3 | 10.7% |
| 5 | 14.2% |
| 10 | 19.3% |
| 20 | 24.8% |
如果需要在测试进行中监控,请使用为此设计的方法。O'Brien 和 Fleming(1979)等成组序贯边界在早期查看时只消耗极少的 α,使总体假阳性率保持在 α。Lan 和 DeMets(1983)的 α 消耗函数允许在事先未确定的时间点查看。基于混合序贯概率比检验(mSPRT;Johari、Koomen、Pekelis、Walsh)的始终有效推断,任何时刻查看的 p 值都有效。作为代价,它们都需要比固定期限测试更大的最大样本量。
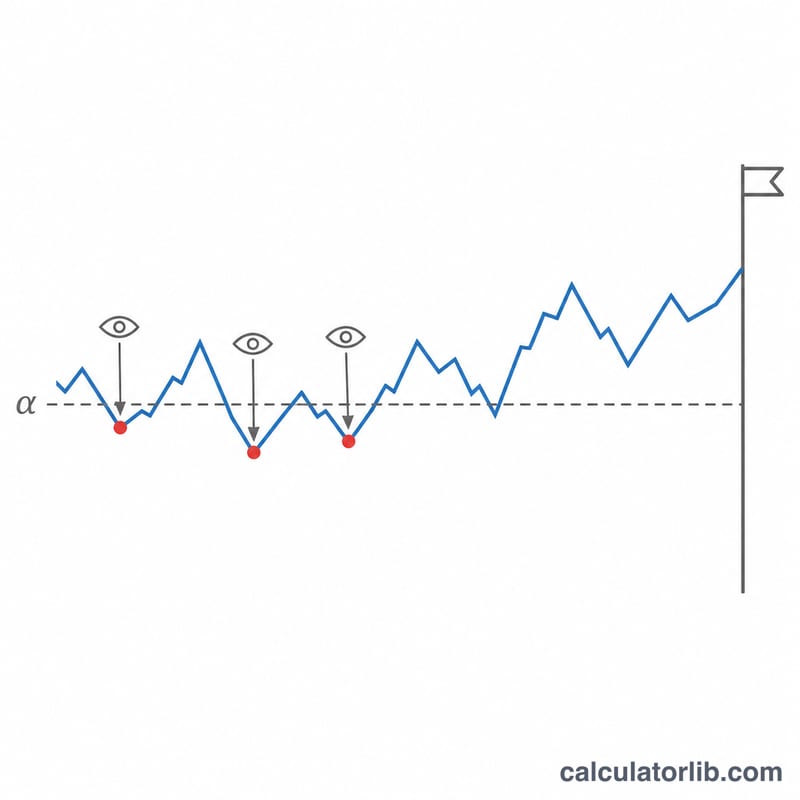
假设与局限
这些公式假设访客相互独立、测试期间转化率稳定、随机分流公平。请按整周运行以覆盖星期效应,检查流量分配是否符合计划,并且每位访客只计一次。样本很小或转化率接近 0% 或 100% 时,正态近似较粗糙,此时更适合使用精确检验。
相关工具
测试已经结束?A/B 测试显著性计算器会用 Z 值和 p 值检验两个转化率之间的差异是否具有统计显著性。
要做问卷调查?样本量计算器可以根据置信水平和误差范围算出需要回收多少份问卷。