Bu hesaplayıcı ne yapar
Her dönüşüm oranı deneyindeki üç soruyu yanıtlar. Test planla, seçtiğiniz artışı saptamak için her varyantın kaç ziyaretçiye ihtiyaç duyduğunu ve trafiğinizle bunun kaç gün süreceğini söyler. Sabit örneklem tersini yapar: elinizdeki ziyaretçi sayısıyla etkinizi saptama gücünü ve hedef güçte saptanabilen en küçük etkiyi verir. Sonuçları analiz et, A ve B'nin dönüşüm ve ziyaretçi sayılarından gözlenen artışı, iki oran z testinin p değerini ve güven aralığını ve B'nin A'yı geçme Bayes olasılığını hesaplar; hepsi rastgele simülasyon olmadan, kesin olarak.
Sayfa örnek değerlerle açılır: mevcut oran %5, göreli MDE %10, çift yönlü α = %5 ve güç %80. Bunları kendi rakamlarınızla değiştirin.
Örneklem büyüklüğü formülü
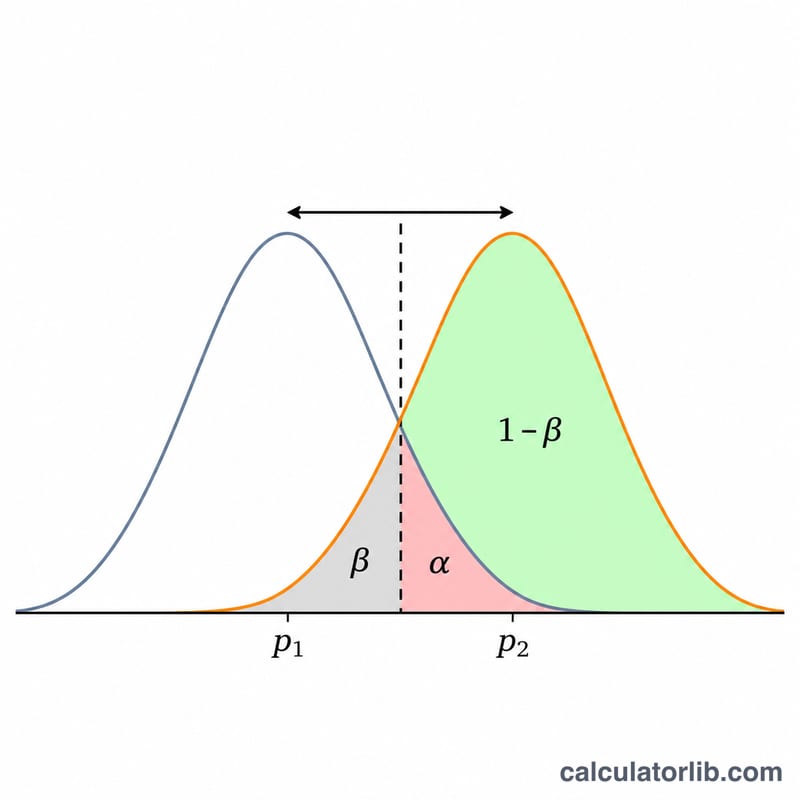
Dönüşüm oranları \( p_1 \) (kontrol) ve \( p_2 \) (varyant) olan eşit büyüklükte iki grup için grup başına gereken ziyaretçi sayısı
$$ n = \frac{\left( z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} + z_{1-\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2-p_1)^2}, \qquad \bar p = \frac{p_1+p_2}{2} $$olur. Çift yönlü testte \( s = 2 \), tek yönlü testte \( s = 1 \)'dir; \( z \) standart normal dağılımın yüzdelik değeridir. Bu, Fleiss, Levin ve Paik'in Statistical Methods for Rates and Proportions (3. baskı, 2003) kitabındaki 4.14 numaralı denklemdir: sıfır hipotezi altındaki standart sapma birleştirilmiş oran \( \bar p \) ile, alternatif altındaki ise her oranla ayrı ayrı hesaplanır. Sonunda yapacağınız birleştirilmiş z testiyle aynı normal yaklaşımdır; bu yüzden plan ve analiz uyumludur. Sonuç yukarı yuvarlanır.
Tabloda ayrıca Fleiss, Tytun ve Ury (1980) süreklilik düzeltmeli büyüklük de verilir: \( n_{cc} = \frac{n}{4}\left(1+\sqrt{1+\frac{4}{n\,|p_2-p_1|} }\right)^2 \). Ders kitabı tabloları genellikle bu daha büyük, daha ihtiyatlı değeri basar.
Kontrol edebileceğiniz örnekler
Fleiss, Levin ve Paik, sayfa 74: \( p_1 = 0{,}60 \), \( p_2 = 0{,}70 \), çift yönlü α = %1, güç %95. Formül 807,07 verir, yani grup başına 808; süreklilik düzeltmesiyle kitapta yazan 827. Güç %75 olduğunda 479,6 (480), düzeltmeyle 499,4 çıkar; kitapta 499 yazar, hesaplayıcı yukarı yuvarlayarak 500 gösterir. Burada tekrarlamak için mutlak etki türünü seçip mevcut oranı 60, etkiyi 10 girin.
Ryan (2013), NCSS PASS kılavuzunda doğrulanmış örnek: tek yönlü α = %5, güç %80, %55'e karşı %65 → 295,7, yani grup başına 296.
Varsayılan örnek: %5 mevcut oran ve %10 göreli artış, %5,5'i %5'ten ayırt etmek demektir. Çift yönlü α = %5 ve %80 güçle varyant başına 31.234, toplam 62.468 ziyaretçi gerekir; günde 2.000 ziyaretçiyle 32 gün sürer.
Göreli mi, mutlak mı MDE
%5 tabanda %10 göreli etki %5,5 demektir (\( p_2 = p_1(1+\text{MDE}) \)). 1 yüzde puanlık mutlak etki %6 demektir (\( p_2 = p_1 + \text{MDE} \)). Etkiyi yarıya indirmek örneklemi yaklaşık dört katına çıkarır, çünkü \( n \), \( 1/(p_2-p_1)^2 \) ile büyür. Düşük taban oranlar pahalıdır: aynı göreli artış %1 oranda, %5 orandakinin yaklaşık beş katı ziyaretçi ister.
Birden çok varyant ve Bonferroni düzeltmesi
Kontrol dahil \( k \) varyant varsa \( k-1 \) rakibin her biri kontrolle karşılaştırılır ve her gruba aynı \( n \) verilir; toplam \( k \cdot n \) olur. Her ek karşılaştırma, yanlış bir kazanan seçme şansını artırır. Bonferroni düzeltmesi (Dunn, 1961) her karşılaştırmayı \( \alpha/(k-1) \) düzeyinde test eder ve en az bir yanlış pozitif olasılığını \( \alpha \) veya altında tutar. İhtiyatlı bir yöntemdir ve tüm grupların \( n \) değerini büyütür.
Sabit örneklemde güç ve MDE
Aynı denklemi güç için çözünce:
$$ 1-\beta = \Phi\!\left( \frac{|p_2-p_1|\sqrt{n} - z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} }{\sqrt{p_1(1-p_1)+p_2(1-p_2)} } \right) $$Hesaplayıcı bunu etkiniz için hesaplar, ardından hedef güce ulaşan en küçük artışı arar. Trafik sabitse bu modu kullanın; örneğin sonuç ne olursa olsun iki hafta süren bir kampanya: saptanabilen artış her gerçekçi değişimden çok büyükse test size pek bir şey söylemez.
Sonuçları okumak: p değeri ve güven aralığı
\( n_A \) ziyaretçide \( x_A \), \( n_B \) ziyaretçide \( x_B \) dönüşüm varsa birleştirilmiş z istatistiği \( z = (\hat p_B-\hat p_A)/\sqrt{\hat p(1-\hat p)(1/n_A+1/n_B)} \) olur; burada \( \hat p = (x_A+x_B)/(n_A+n_B) \). Çift yönlü p değeri \( 2(1-\Phi(|z|)) \), B'nin daha iyi olduğu hipotezi için tek yönlü p değeri \( 1-\Phi(z) \) olur. Farkın güven aralığı birleştirilmemiş standart hatayı kullanır: \( (\hat p_B-\hat p_A) \pm z_{1-\alpha/2}\sqrt{\hat p_A(1-\hat p_A)/n_A+\hat p_B(1-\hat p_B)/n_B} \). Örnek: 10.000'de 500'e karşı 10.000'de 560, z = 1,894 ve p = 0,0583 verir; yani gözlenen %12 artış %5 düzeyinde anlamlı değildir ve B − A için %95 aralık −0,02 ile +1,22 yüzde puan arasındadır.
B'nin A'yı geçme Bayes olasılığı
Tekdüze Beta(1, 1) önseliyle, \( n \) ziyaretçide \( x \) dönüşümden sonra dönüşüm oranının sonsal dağılımı Beta(\( 1+x \), \( 1+n-x \)) olur (Gelman ve ark., Bayesian Data Analysis, 3. baskı, 2. bölüm). Parametreler tam sayı olduğundan B'nin oranının daha yüksek olma olasılığı kesin bir sonlu toplamla yazılır:
$$ P(p_B>p_A) = \sum_{i=0}^{\alpha_B-1} \frac{B(\alpha_A+i,\ \beta_A+\beta_B)}{(\beta_B+i)\,B(1+i,\ \beta_B)\,B(\alpha_A,\ \beta_A)} $$Burada \( \alpha = 1+x \), \( \beta = 1+n-x \) ve \( B \) beta fonksiyonudur; türetme Evan Miller'a aittir. Hesaplayıcı bunu logaritmik ölçekte hesaplar; rastgele çekilişlere bağlı değildir ve her seferinde aynı sonucu verir. B'yi yayına almanın beklenen kaybı, \( E[\max(p_A-p_B, 0)] \), kaydırılmış parametrelerle aynı toplamdan gelir: B aslında daha kötüyse kaybetmeyi beklemeniz gereken dönüşüm oranıdır. Yukarıdaki örnekte P(B > A) = %97,08 ve B'yi yayına almanın beklenen kaybı 0,0036 yüzde puandır. "%97 olasılıkla daha iyi" ile "%5 düzeyinde anlamlı değil" farklı soruları yanıtlar; hiçbiri testi erken durdurma izni değildir.
Erken bakmak sabit süreli testi neden bozar
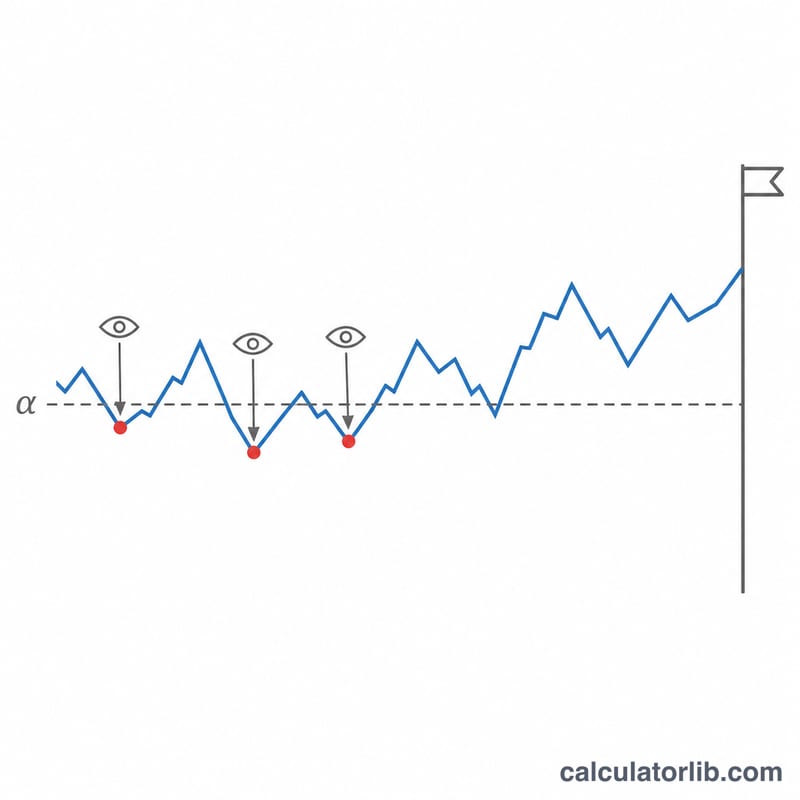
Yukarıdaki örneklem büyüklüğü verilere yalnızca bir kez, sonda bakılacağını varsayar. Her partiden sonra bakıp ilk p < 0,05'te durursanız her bakış yeni bir yanlış pozitif şansıdır. Bu etkiyi ilk kez Armitage, McPherson ve Rowe (1969) ölçtü. Aşağıdakiler, test istatistiklerinin ortak normal dağılımının kesin sayısal integrasyonuyla hesapladığımız değerlerdir (çift yönlü %5 test, eşit aralıklı bakışlar, gerçek fark yok):
| Verilere bakma sayısı | Yanlış kazanan olasılığı |
|---|---|
| 1 | %5,0 |
| 2 | %8,3 |
| 3 | %10,7 |
| 5 | %14,2 |
| 10 | %19,3 |
| 20 | %24,8 |
Test sürerken izlemeniz gerekiyorsa bunun için tasarlanmış bir yöntem kullanın. O'Brien ve Fleming (1979) gibi grup ardışık sınırlar ilk bakışlarda çok az α harcar ve toplam yanlış pozitif oranını α'da tutar. Lan ve DeMets'in (1983) alfa harcama yaklaşımı, önceden belirlenmemiş zamanlarda bakmaya izin verir. Karışım ardışık olasılık oranı testiyle (mSPRT; Johari, Koomen, Pekelis ve Walsh) her zaman geçerli çıkarım, istediğiniz an kontrol edebileceğiniz p değerleri verir. Bunun karşılığında hepsi sabit süreli bir testten daha büyük bir azami örneklem gerektirir.
Varsayımlar ve sınırlar
Formüller bağımsız ziyaretçiler, test boyunca sabit bir dönüşüm oranı ve adil bir rastgele dağıtım varsayar. Haftanın günü etkilerini kapsamak için testi tam haftalar boyunca çalıştırın, trafik dağılımının plana uyduğunu kontrol edin ve her ziyaretçiyi bir kez sayın. Çok küçük örneklemlerde veya %0 ya da %100'e yakın oranlarda normal yaklaşım kabadır; orada kesin bir test daha güvenlidir.
İlgili araçlar
Testiniz bitti mi? A/B test anlamlılık hesaplayıcı, iki dönüşüm oranı arasındaki farkın istatistiksel olarak anlamlı olup olmadığını Z puanı ve p değeriyle kontrol eder.
Anket mi yapacaksınız? Örneklem büyüklüğü hesaplama aracı, belirli bir güven düzeyi ve hata payı için kaç yanıt toplamanız gerektiğini hesaplar.