Ce que fait ce calculateur
Il répond aux trois questions de toute expérience sur un taux de conversion. Planifier un test indique combien de visiteurs chaque variante doit recevoir pour détecter la hausse visée, et combien de jours cela prend avec votre trafic. Échantillon fixé fait l’inverse : pour les visiteurs dont vous disposez, il donne la puissance pour détecter votre effet et le plus petit effet détectable à la puissance cible. Analyser les résultats prend les conversions et visiteurs de A et B et renvoie la hausse observée, la valeur p du test z de deux proportions avec son intervalle de confiance, et la probabilité bayésienne que B batte A, le tout calculé exactement, sans simulation aléatoire.
La page s’ouvre avec des valeurs d’exemple : taux actuel de 5 %, MDE relatif de 10 %, α = 5 % bilatéral et puissance de 80 %. Remplacez-les par vos chiffres.
Formule de la taille d’échantillon
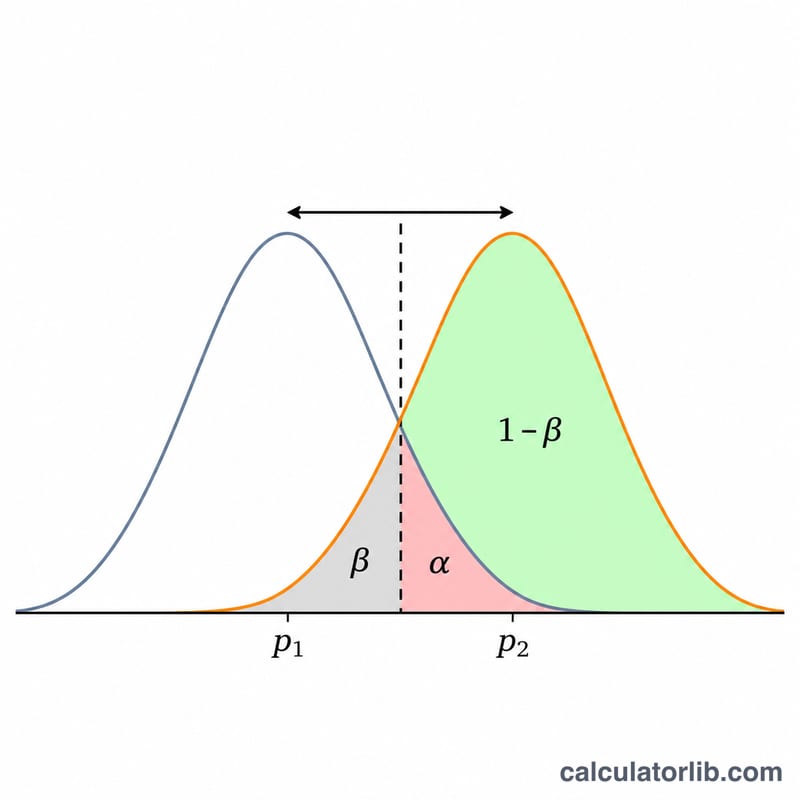
Pour deux groupes de même taille, de taux de conversion \( p_1 \) (contrôle) et \( p_2 \) (variante), le nombre de visiteurs nécessaire par groupe est
$$ n = \frac{\left( z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} + z_{1-\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2-p_1)^2}, \qquad \bar p = \frac{p_1+p_2}{2} $$avec \( s = 2 \) pour un test bilatéral et \( s = 1 \) pour un test unilatéral, \( z \) étant un quantile de la loi normale centrée réduite. C’est l’équation 4.14 de Fleiss, Levin et Paik, Statistical Methods for Rates and Proportions (3e éd., 2003) : l’écart-type sous l’hypothèse nulle utilise le taux commun \( \bar p \), celui sous l’alternative chaque taux séparément. C’est la même approximation normale que le test z groupé que vous ferez à la fin : plan et analyse concordent. Le résultat est arrondi à l’entier supérieur.
Le tableau donne aussi la taille avec la correction de continuité de Fleiss, Tytun et Ury (1980), \( n_{cc} = \frac{n}{4}\left(1+\sqrt{1+\frac{4}{n\,|p_2-p_1|} }\right)^2 \). Les tables des manuels impriment souvent ce chiffre, plus grand et plus prudent.
Exemples vérifiables
Fleiss, Levin et Paik, page 74 : \( p_1 = 0{,}60 \), \( p_2 = 0{,}70 \), α = 1 % bilatéral, puissance de 95 %. La formule donne 807,07, soit 808 par groupe, et 827 avec la correction de continuité, le chiffre du livre. À 75 % de puissance, elle donne 479,6 (480) et 499,4 avec correction : le livre imprime 499, le calculateur arrondit à 500. Pour le reproduire ici, choisissez l’effet absolu avec un taux actuel de 60 et un effet de 10.
Ryan (2013), validé dans le manuel NCSS PASS : α = 5 % unilatéral, puissance de 80 %, 55 % contre 65 % → 295,7, soit 296 par groupe.
Exemple par défaut : un taux de 5 % et une hausse relative de 10 % reviennent à distinguer 5,5 % de 5 %. Avec α = 5 % bilatéral et une puissance de 80 %, il faut 31 234 visiteurs par variante, 62 468 au total, soit 32 jours à 2 000 visiteurs par jour.
MDE relatif ou absolu
Un effet relatif de 10 % sur une base de 5 % signifie 5,5 % (\( p_2 = p_1(1+\text{MDE}) \)). Un effet absolu d’un point de pourcentage signifie 6 % (\( p_2 = p_1 + \text{MDE} \)). Diviser l’effet par deux multiplie l’échantillon par quatre environ, car \( n \) varie comme \( 1/(p_2-p_1)^2 \). Les taux faibles coûtent cher : la même hausse relative sur un taux de 1 % exige environ cinq fois plus de visiteurs que sur un taux de 5 %.
Plusieurs variantes et correction de Bonferroni
Avec \( k \) variantes contrôle compris, chacune des \( k-1 \) challengers est comparée au contrôle et tous les groupes reçoivent le même \( n \) : le total vaut \( k \cdot n \). Chaque comparaison supplémentaire est une chance de plus de désigner un faux gagnant. La correction de Bonferroni (Dunn, 1961) teste chaque comparaison à \( \alpha/(k-1) \), ce qui maintient la probabilité d’au moins un faux positif à \( \alpha \) au plus. Elle est prudente et augmente \( n \) pour chaque groupe.
Puissance et MDE pour un échantillon fixé
En résolvant la même équation pour la puissance :
$$ 1-\beta = \Phi\!\left( \frac{|p_2-p_1|\sqrt{n} - z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} }{\sqrt{p_1(1-p_1)+p_2(1-p_2)} } \right) $$Le calculateur l’évalue pour votre effet, puis cherche la plus petite hausse qui atteint la puissance cible. Utilisez ce mode quand le trafic est imposé, par exemple une campagne qui dure deux semaines quoi qu’il arrive : si la hausse détectable dépasse de loin tout changement réaliste, le test vous apprendra peu.
Lire les résultats : valeur p et intervalle de confiance
Avec \( x_A \) conversions sur \( n_A \) visiteurs et \( x_B \) sur \( n_B \), la statistique z groupée vaut \( z = (\hat p_B-\hat p_A)/\sqrt{\hat p(1-\hat p)(1/n_A+1/n_B)} \) avec \( \hat p = (x_A+x_B)/(n_A+n_B) \). La valeur p bilatérale est \( 2(1-\Phi(|z|)) \) ; la valeur p unilatérale, pour l’hypothèse que B est meilleur, est \( 1-\Phi(z) \). L’intervalle de confiance de l’écart utilise l’erreur type non groupée : \( (\hat p_B-\hat p_A) \pm z_{1-\alpha/2}\sqrt{\hat p_A(1-\hat p_A)/n_A+\hat p_B(1-\hat p_B)/n_B} \). Exemple : 500 sur 10 000 contre 560 sur 10 000 donne z = 1,894 et p = 0,0583 ; la hausse observée de 12 % n’est donc pas significative à 5 %, et l’intervalle à 95 % de B − A va de −0,02 à +1,22 point de pourcentage.
Probabilité bayésienne que B batte A
Avec un a priori uniforme Beta(1, 1), la loi a posteriori d’un taux de conversion après \( x \) conversions sur \( n \) visiteurs est Beta(\( 1+x \), \( 1+n-x \)) (Gelman et al., Bayesian Data Analysis, 3e éd., chapitre 2). Comme ces paramètres sont entiers, la probabilité que le taux de B soit supérieur s’écrit comme une somme finie exacte :
$$ P(p_B>p_A) = \sum_{i=0}^{\alpha_B-1} \frac{B(\alpha_A+i,\ \beta_A+\beta_B)}{(\beta_B+i)\,B(1+i,\ \beta_B)\,B(\alpha_A,\ \beta_A)} $$avec \( \alpha = 1+x \), \( \beta = 1+n-x \) et \( B \) la fonction bêta, selon la démonstration d’Evan Miller. Le calculateur l’évalue en échelle logarithmique : aucun tirage aléatoire, le même résultat à chaque fois. La perte attendue si l’on déploie B, \( E[\max(p_A-p_B, 0)] \), découle de la même somme avec des paramètres décalés : c’est la part de conversion que l’on s’attend à perdre si B est en réalité moins bon. Dans l’exemple ci-dessus, P(B > A) = 97,08 % et la perte attendue si l’on déploie B est de 0,0036 point de pourcentage. « 97 % de chances d’être meilleur » et « non significatif à 5 % » répondent à des questions différentes ; aucune des deux n’autorise à arrêter le test plus tôt.
Pourquoi regarder en cours de route fausse un test à horizon fixe
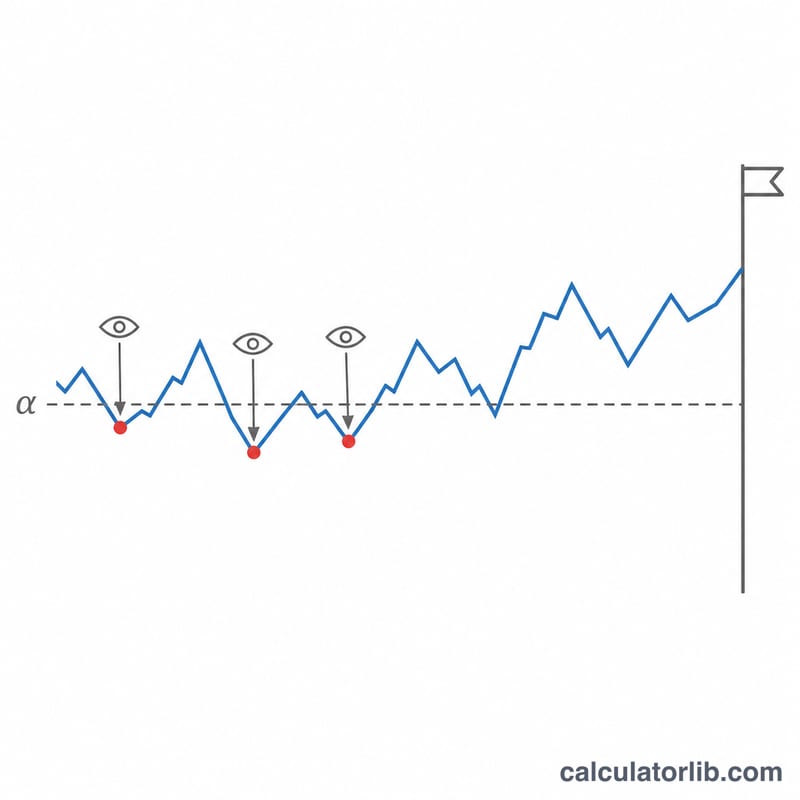
La taille d’échantillon ci-dessus suppose un seul regard sur les données, à la fin. Si vous vérifiez après chaque lot et vous arrêtez au premier p < 0,05, chaque regard ajoute une chance de faux positif. Armitage, McPherson et Rowe (1969) ont été les premiers à mesurer cet effet. Voici les valeurs que nous avons calculées par intégration numérique exacte de la loi normale jointe des statistiques de test, pour un test bilatéral à 5 % avec des regards équidistants et sans différence réelle :
| Nombre de regards sur les données | Probabilité d’un faux gagnant |
|---|---|
| 1 | 5,0 % |
| 2 | 8,3 % |
| 3 | 10,7 % |
| 5 | 14,2 % |
| 10 | 19,3 % |
| 20 | 24,8 % |
Si vous devez suivre un test en cours, utilisez un plan conçu pour cela. Les bornes séquentielles par groupes, comme celles d’O'Brien et Fleming (1979), dépensent très peu de α aux premiers regards et maintiennent le taux global de faux positifs à α. La dépense d’alpha de Lan et DeMets (1983) permet de regarder à des moments non fixés d’avance. L’inférence toujours valide fondée sur le test séquentiel du rapport de vraisemblance de mélange (mSPRT ; Johari, Koomen, Pekelis et Walsh) fournit des valeurs p consultables à tout moment. En contrepartie, tous exigent un échantillon maximal plus grand qu’un test à horizon fixe.
Hypothèses et limites
Les formules supposent des visiteurs indépendants, un taux de conversion stable pendant le test et une répartition aléatoire équitable. Faites tourner le test sur des semaines entières pour couvrir les effets du jour de la semaine, vérifiez que la répartition du trafic correspond au plan et comptez chaque visiteur une seule fois. Pour de très petits échantillons ou des taux proches de 0 % ou de 100 %, l’approximation normale est grossière ; un test exact est alors plus sûr.
Voir aussi
Votre test est terminé ? Le calculateur de significativité A/B vérifie si l’écart entre deux taux de conversion est statistiquement significatif, avec le score Z et la p-value.
Vous lancez un sondage ou une enquête ? Le calculateur de taille d’échantillon indique combien de réponses il vous faut pour un niveau de confiance et une marge d’erreur donnés.