Что умеет этот калькулятор
Он отвечает на три вопроса любого эксперимента с конверсией. Спланировать тест — сколько посетителей нужно каждому варианту, чтобы обнаружить выбранный прирост, и сколько дней это займёт при вашем трафике. Фиксированная выборка — обратная задача: для имеющегося числа посетителей калькулятор показывает мощность для вашего эффекта и наименьший эффект, обнаруживаемый при целевой мощности. Проанализировать результаты — по конверсиям и посетителям A и B выдаёт наблюдаемый прирост, p-значение z-теста для двух долей с доверительным интервалом и байесовскую вероятность того, что B лучше A. Всё считается точно, без случайного моделирования.
Страница открывается с примерными данными: текущая конверсия 5%, относительный MDE 10%, двусторонний α = 5% и мощность 80%. Замените их своими.
Формула размера выборки
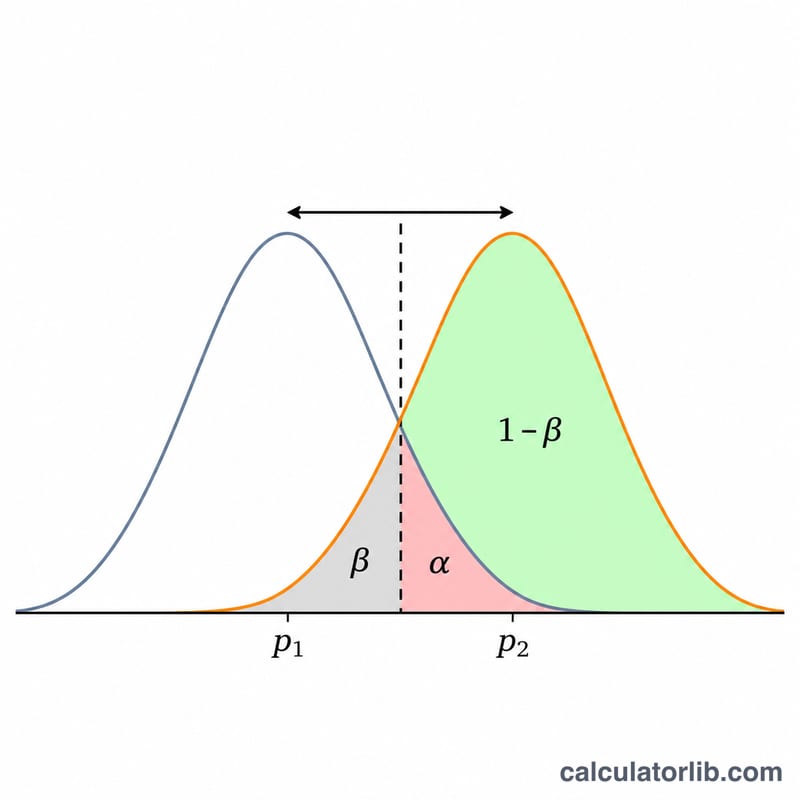
Для двух групп одинакового размера с конверсией \( p_1 \) (контроль) и \( p_2 \) (вариант) число посетителей на группу равно
$$ n = \frac{\left( z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} + z_{1-\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2-p_1)^2}, \qquad \bar p = \frac{p_1+p_2}{2} $$где \( s = 2 \) для двустороннего теста и \( s = 1 \) для одностороннего, а \( z \) — квантиль стандартного нормального распределения. Это формула 4.14 из книги Fleiss, Levin, Paik «Statistical Methods for Rates and Proportions» (3-е изд., 2003): стандартное отклонение при нулевой гипотезе берётся по объединённой доле \( \bar p \), при альтернативной — по каждой доле отдельно. Это то же нормальное приближение, что и у объединённого z-теста, который вы проведёте в конце, поэтому план и анализ согласованы. Результат округляется вверх.
В таблице также указан размер с поправкой на непрерывность по Fleiss, Tytun и Ury (1980): \( n_{cc} = \frac{n}{4}\left(1+\sqrt{1+\frac{4}{n\,|p_2-p_1|} }\right)^2 \). В учебных таблицах обычно приводится именно это, более осторожное и большее число.
Примеры для проверки
Fleiss, Levin, Paik, с. 74: \( p_1 = 0{,}60 \), \( p_2 = 0{,}70 \), двусторонний α = 1%, мощность 95%. Формула даёт 807,07, то есть 808 на группу, а с поправкой на непрерывность — 827, как в книге. При мощности 75% получается 479,6 (480) и 499,4 с поправкой: в книге напечатано 499, калькулятор округляет вверх до 500. Чтобы повторить расчёт, выберите абсолютный эффект, текущую конверсию 60 и эффект 10.
Ryan (2013), пример проверки из руководства NCSS PASS: односторонний α = 5%, мощность 80%, 55% против 65% → 295,7, то есть 296 на группу.
Пример по умолчанию: текущая конверсия 5% и относительный прирост 10% означают, что нужно отличить 5,5% от 5%. При двустороннем α = 5% и мощности 80% требуется 31 234 посетителя на вариант, всего 62 468, то есть 32 дня при 2 000 посетителях в день.
Относительный или абсолютный MDE
Относительный эффект 10% при базе 5% означает 5,5% (\( p_2 = p_1(1+\text{MDE}) \)). Абсолютный эффект в 1 процентный пункт означает 6% (\( p_2 = p_1 + \text{MDE} \)). Если уменьшить эффект вдвое, выборка вырастет примерно в четыре раза, потому что \( n \) пропорционально \( 1/(p_2-p_1)^2 \). Низкая базовая конверсия обходится дорого: тот же относительный прирост при конверсии 1% требует примерно в пять раз больше посетителей, чем при 5%.
Несколько вариантов и поправка Бонферрони
При \( k \) вариантах, включая контроль, каждый из \( k-1 \) претендентов сравнивается с контролем, и все группы получают одинаковое \( n \), так что всего нужно \( k \cdot n \). Каждое дополнительное сравнение — ещё один шанс выбрать ложного победителя. Поправка Бонферрони (Dunn, 1961) проверяет каждое сравнение на уровне \( \alpha/(k-1) \), удерживая вероятность хотя бы одного ложноположительного результата не выше \( \alpha \). Она консервативна и увеличивает \( n \) для каждой группы.
Мощность и MDE при фиксированной выборке
Если решить то же уравнение относительно мощности, получится
$$ 1-\beta = \Phi\!\left( \frac{|p_2-p_1|\sqrt{n} - z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} }{\sqrt{p_1(1-p_1)+p_2(1-p_2)} } \right) $$Калькулятор вычисляет её для вашего эффекта, а затем ищет наименьший прирост, при котором достигается целевая мощность. Этот режим нужен, когда трафик задан заранее, например кампания длится две недели при любом исходе: если обнаруживаемый прирост намного больше любого реалистичного изменения, тест мало что покажет.
Как читать результаты: p-значение и доверительный интервал
При \( x_A \) конверсиях из \( n_A \) посетителей и \( x_B \) из \( n_B \) объединённая z-статистика равна \( z = (\hat p_B-\hat p_A)/\sqrt{\hat p(1-\hat p)(1/n_A+1/n_B)} \), где \( \hat p = (x_A+x_B)/(n_A+n_B) \). Двустороннее p-значение — \( 2(1-\Phi(|z|)) \); одностороннее, для гипотезы «B лучше», — \( 1-\Phi(z) \). Доверительный интервал разности строится по необъединённой стандартной ошибке: \( (\hat p_B-\hat p_A) \pm z_{1-\alpha/2}\sqrt{\hat p_A(1-\hat p_A)/n_A+\hat p_B(1-\hat p_B)/n_B} \). Пример: 500 из 10 000 против 560 из 10 000 дают z = 1,894 и p = 0,0583, поэтому наблюдаемый прирост 12% незначим на уровне 5%, а 95%-й интервал для B − A — от −0,02 до +1,22 процентного пункта.
Байесовская вероятность того, что B лучше A
При равномерном априорном распределении Beta(1, 1) апостериорное распределение конверсии после \( x \) конверсий из \( n \) посетителей — Beta(\( 1+x \), \( 1+n-x \)) (Gelman и соавт., «Bayesian Data Analysis», 3-е изд., глава 2). Параметры целые, поэтому вероятность того, что конверсия B выше, выражается точной конечной суммой:
$$ P(p_B>p_A) = \sum_{i=0}^{\alpha_B-1} \frac{B(\alpha_A+i,\ \beta_A+\beta_B)}{(\beta_B+i)\,B(1+i,\ \beta_B)\,B(\alpha_A,\ \beta_A)} $$где \( \alpha = 1+x \), \( \beta = 1+n-x \), \( B \) — бета-функция; вывод приводит Эван Миллер. Калькулятор считает сумму в логарифмической шкале, поэтому результат не зависит от случайных выборок и каждый раз одинаков. Ожидаемые потери при выборе B, \( E[\max(p_A-p_B, 0)] \), получаются из той же суммы со сдвинутыми параметрами: это доля конверсии, которую стоит ожидать потерять, если B на самом деле хуже. В примере выше P(B > A) = 97,08%, а ожидаемые потери при выборе B — 0,0036 процентного пункта. «С вероятностью 97% лучше» и «незначимо на уровне 5%» отвечают на разные вопросы; ни то ни другое не повод останавливать тест досрочно.
Почему подглядывание ломает тест с фиксированным горизонтом
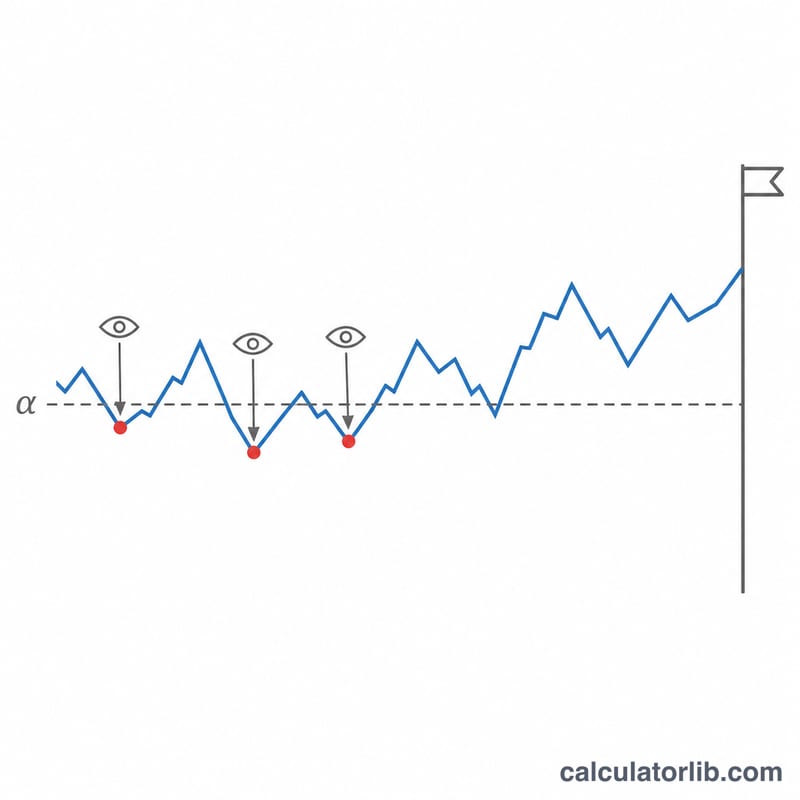
Размер выборки выше рассчитан на один взгляд на данные — в конце. Если проверять результат после каждой порции и останавливаться при первом p < 0,05, каждая проверка добавляет шанс ложноположительного результата. Впервые этот эффект измерили Armitage, McPherson и Rowe (1969). Ниже — значения, которые мы получили точным численным интегрированием совместного нормального распределения статистик для двустороннего теста на уровне 5% с равномерными проверками и без реальной разницы:
| Сколько раз смотрели данные | Вероятность ложного победителя |
|---|---|
| 1 | 5,0% |
| 2 | 8,3% |
| 3 | 10,7% |
| 5 | 14,2% |
| 10 | 19,3% |
| 20 | 24,8% |
Если тест нужно отслеживать по ходу, используйте дизайн, созданный для этого. Групповые последовательные границы, например O'Brien и Fleming (1979), почти не расходуют α на ранних проверках и держат общую долю ложноположительных результатов на уровне α. Функции расходования альфы Lan и DeMets (1983) позволяют смотреть на данные в заранее не назначенные моменты. Всегда корректный вывод на основе смешанного последовательного критерия отношения правдоподобия (mSPRT; Johari, Koomen, Pekelis, Walsh) даёт p-значения, которые можно проверять в любой момент. Взамен все эти методы требуют большего максимального размера выборки, чем тест с фиксированным горизонтом.
Допущения и ограничения
Формулы предполагают независимых посетителей, стабильную конверсию во время теста и честное случайное распределение трафика. Проводите тест целыми неделями, чтобы учесть влияние дня недели, проверяйте, что доли трафика совпадают с планом, и считайте каждого посетителя один раз. При очень малых выборках или конверсии около 0% или 100% нормальное приближение грубое — тогда надёжнее точный критерий.
Смотрите также
Тест уже завершён? Калькулятор значимости A/B-теста проверит, статистически значима ли разница между двумя коэффициентами конверсии, и покажет Z-значение и p-значение.
Проводите опрос? Калькулятор размера выборки подскажет, сколько ответов нужно собрать при заданном уровне доверия и допустимой погрешности.