Qué hace esta calculadora
Responde a las tres preguntas de cualquier experimento de conversión. Planificar una prueba indica cuántos visitantes necesita cada variante para detectar el aumento elegido y cuántos días tardarás con tu tráfico. Muestra fija funciona al revés: con los visitantes que ya tienes, da la potencia para detectar tu efecto y el efecto más pequeño detectable con la potencia objetivo. Analizar resultados toma conversiones y visitantes de A y B y devuelve el aumento observado, el valor p de la prueba z de dos proporciones con su intervalo de confianza y la probabilidad bayesiana de que B supere a A, todo calculado de forma exacta, sin simulación aleatoria.
La página se abre con datos de ejemplo: tasa actual del 5 %, MDE relativo del 10 %, α = 5 % bilateral y potencia del 80 %. Sustitúyelos por tus cifras.
Fórmula del tamaño de muestra
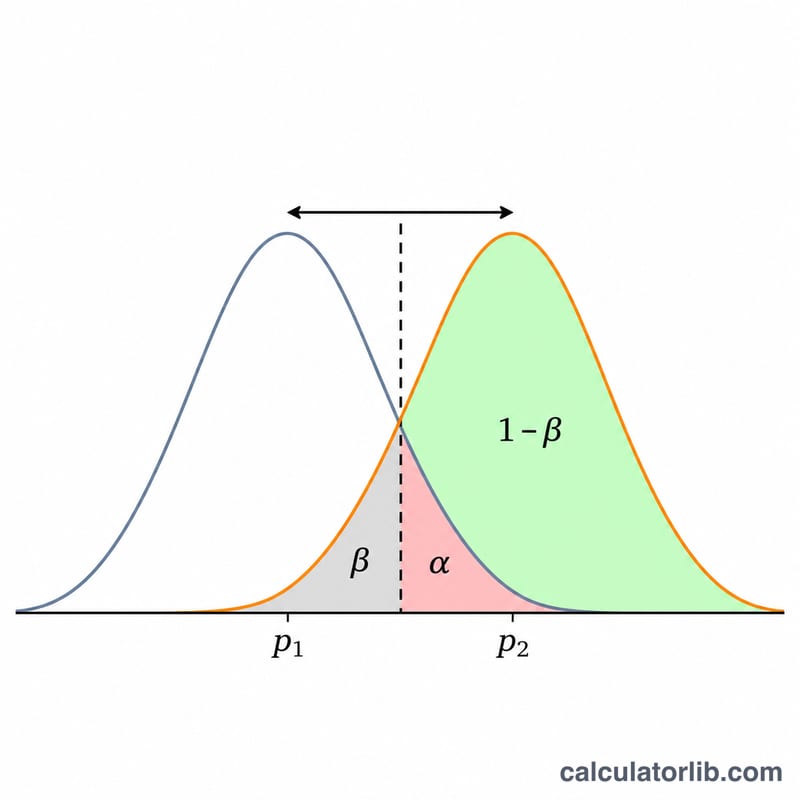
Para dos grupos del mismo tamaño con tasas de conversión \( p_1 \) (control) y \( p_2 \) (variante), los visitantes necesarios por grupo son
$$ n = \frac{\left( z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} + z_{1-\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2-p_1)^2}, \qquad \bar p = \frac{p_1+p_2}{2} $$donde \( s = 2 \) en una prueba bilateral y \( s = 1 \) en una unilateral, y \( z \) es un cuantil de la normal estándar. Es la ecuación 4.14 de Fleiss, Levin y Paik, Statistical Methods for Rates and Proportions (3.ª ed., 2003): la desviación típica bajo la hipótesis nula usa la tasa combinada \( \bar p \), y la de la alternativa, cada tasa por separado. Es la misma aproximación normal de la prueba z combinada que harás al final, así que plan y análisis encajan. El resultado se redondea al alza.
La tabla también muestra el tamaño con la corrección por continuidad de Fleiss, Tytun y Ury (1980), \( n_{cc} = \frac{n}{4}\left(1+\sqrt{1+\frac{4}{n\,|p_2-p_1|} }\right)^2 \). Las tablas de los libros suelen dar este valor, mayor y más conservador.
Ejemplos que puedes comprobar
Fleiss, Levin y Paik, página 74: \( p_1 = 0{,}60 \), \( p_2 = 0{,}70 \), α = 1 % bilateral, potencia del 95 %. La fórmula da 807,07, es decir, 808 por grupo, y 827 con la corrección por continuidad, la cifra del libro. Con potencia del 75 % da 479,6 (480) y 499,4 con la corrección: el libro imprime 499 y la calculadora redondea al alza a 500. Para reproducirlo, elige el efecto absoluto con una tasa actual de 60 y un efecto de 10.
Ryan (2013), validado en el manual de NCSS PASS: α = 5 % unilateral, potencia del 80 %, 55 % frente a 65 % → 295,7, es decir, 296 por grupo.
Ejemplo por defecto: una tasa del 5 % y un aumento relativo del 10 % significan distinguir 5,5 % de 5 %. Con α = 5 % bilateral y potencia del 80 % hacen falta 31.234 visitantes por variante, 62.468 en total, o 32 días con 2.000 visitantes al día.
MDE relativo o absoluto
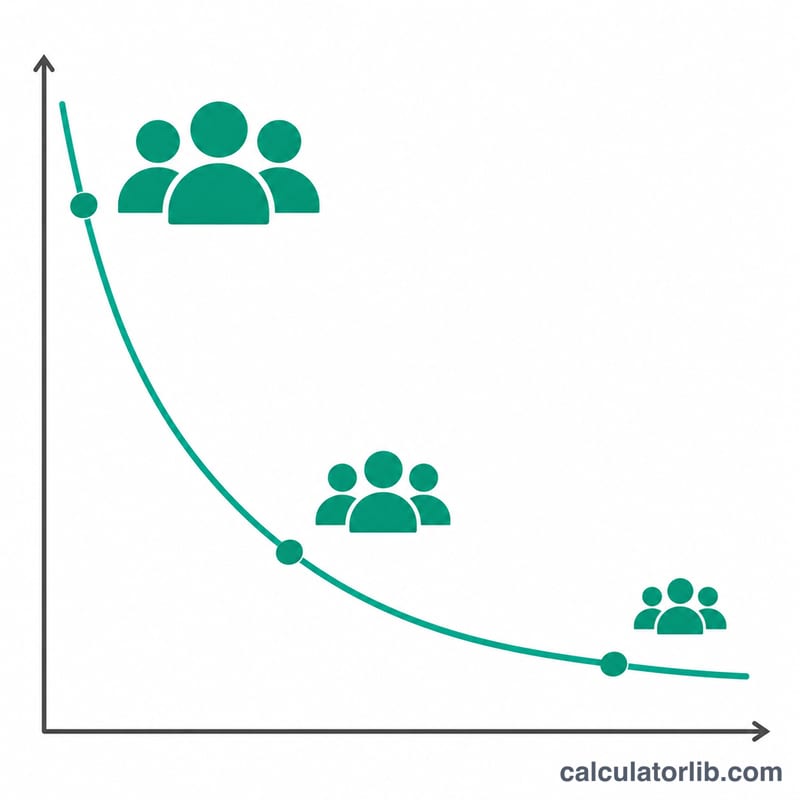
Un efecto relativo del 10 % sobre un 5 % significa 5,5 % (\( p_2 = p_1(1+\text{MDE}) \)). Un efecto absoluto de 1 punto porcentual significa 6 % (\( p_2 = p_1 + \text{MDE} \)). Reducir el efecto a la mitad multiplica la muestra por cuatro aproximadamente, porque \( n \) crece con \( 1/(p_2-p_1)^2 \). Las tasas bajas salen caras: el mismo aumento relativo sobre un 1 % necesita unas cinco veces los visitantes que sobre un 5 %.
Varias variantes y corrección de Bonferroni
Con \( k \) variantes incluido el control, cada una de las \( k-1 \) aspirantes se compara con el control y todos los grupos reciben el mismo \( n \), así que el total es \( k \cdot n \). Cada comparación extra es otra oportunidad de un falso ganador. La corrección de Bonferroni (Dunn, 1961) prueba cada comparación a \( \alpha/(k-1) \), lo que mantiene la probabilidad de al menos un falso positivo en \( \alpha \) o menos. Es conservadora y aumenta \( n \) en todos los grupos.
Potencia y MDE con una muestra fija
Despejando la potencia en la misma ecuación:
$$ 1-\beta = \Phi\!\left( \frac{|p_2-p_1|\sqrt{n} - z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} }{\sqrt{p_1(1-p_1)+p_2(1-p_2)} } \right) $$La calculadora la evalúa para tu efecto y luego busca el aumento más pequeño que alcanza la potencia objetivo. Usa este modo cuando el tráfico está fijado, por ejemplo una campaña que dura dos semanas pase lo que pase: si el aumento detectable es mucho mayor que cualquier cambio realista, la prueba te dirá poco.
Cómo leer los resultados: valor p e intervalo de confianza
Con \( x_A \) conversiones de \( n_A \) visitantes y \( x_B \) de \( n_B \), el estadístico z combinado es \( z = (\hat p_B-\hat p_A)/\sqrt{\hat p(1-\hat p)(1/n_A+1/n_B)} \) con \( \hat p = (x_A+x_B)/(n_A+n_B) \). El valor p bilateral es \( 2(1-\Phi(|z|)) \); el unilateral, para la hipótesis de que B es mejor, es \( 1-\Phi(z) \). El intervalo de confianza de la diferencia usa el error estándar no combinado: \( (\hat p_B-\hat p_A) \pm z_{1-\alpha/2}\sqrt{\hat p_A(1-\hat p_A)/n_A+\hat p_B(1-\hat p_B)/n_B} \). Ejemplo: 500 de 10.000 frente a 560 de 10.000 da z = 1,894 y p = 0,0583, así que el aumento observado del 12 % no es significativo al 5 %, y el intervalo del 95 % para B − A va de −0,02 a +1,22 puntos porcentuales.
Probabilidad bayesiana de que B supere a A
Con un prior uniforme Beta(1, 1), la distribución a posteriori de una tasa de conversión tras \( x \) conversiones en \( n \) visitantes es Beta(\( 1+x \), \( 1+n-x \)) (Gelman et al., Bayesian Data Analysis, 3.ª ed., capítulo 2). Como los parámetros son enteros, la probabilidad de que la tasa de B sea mayor tiene una suma finita exacta:
$$ P(p_B>p_A) = \sum_{i=0}^{\alpha_B-1} \frac{B(\alpha_A+i,\ \beta_A+\beta_B)}{(\beta_B+i)\,B(1+i,\ \beta_B)\,B(\alpha_A,\ \beta_A)} $$con \( \alpha = 1+x \), \( \beta = 1+n-x \) y \( B \) la función beta, según la deducción de Evan Miller. La calculadora la evalúa en escala logarítmica, sin depender de extracciones aleatorias, y da siempre el mismo resultado. La pérdida esperada de lanzar B, \( E[\max(p_A-p_B, 0)] \), sale de la misma suma con parámetros desplazados: es la conversión que cabe esperar perder si B resulta ser peor. En el ejemplo anterior, P(B > A) = 97,08 % y la pérdida esperada de lanzar B es de 0,0036 puntos porcentuales. «97 % de probabilidad de ser mejor» y «no significativo al 5 %» responden a preguntas distintas; ninguna autoriza a detener la prueba antes de tiempo.
Por qué mirar antes de tiempo arruina una prueba de horizonte fijo
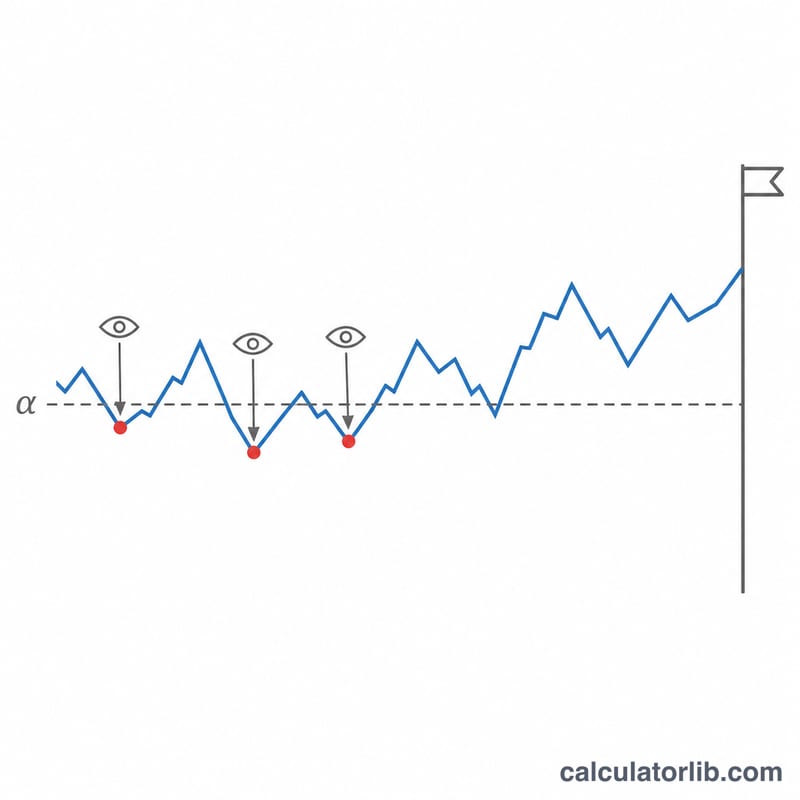
El tamaño de muestra anterior supone una sola mirada a los datos, al final. Si revisas tras cada lote y paras en el primer p < 0,05, cada revisión es otra oportunidad de falso positivo. Armitage, McPherson y Rowe (1969) fueron los primeros en medirlo. Estos son los valores que calculamos por integración numérica exacta de la distribución normal conjunta de los estadísticos, para una prueba bilateral al 5 % con revisiones equiespaciadas y sin diferencia real:
| Revisiones de los datos | Probabilidad de un falso ganador |
|---|---|
| 1 | 5,0 % |
| 2 | 8,3 % |
| 3 | 10,7 % |
| 5 | 14,2 % |
| 10 | 19,3 % |
| 20 | 24,8 % |
Si necesitas vigilar la prueba mientras corre, usa un diseño pensado para ello. Los límites secuenciales por grupos, como los de O'Brien y Fleming (1979), gastan muy poco α en las primeras revisiones y mantienen la tasa global de falsos positivos en α. El gasto de alfa de Lan y DeMets (1983) permite revisar en momentos no fijados de antemano. La inferencia siempre válida con la prueba secuencial de razón de probabilidades de mezcla (mSPRT; Johari, Koomen, Pekelis y Walsh) da valores p que puedes consultar en cualquier momento. A cambio, todos necesitan una muestra máxima mayor que una prueba de horizonte fijo.
Supuestos y límites
Las fórmulas suponen visitantes independientes, una tasa de conversión estable durante la prueba y un reparto aleatorio justo. Ejecuta la prueba durante semanas completas para cubrir los patrones de cada día, comprueba que el reparto del tráfico coincide con el previsto y cuenta a cada visitante una sola vez. Con muestras muy pequeñas o tasas cercanas al 0 % o al 100 %, la aproximación normal es tosca; ahí es más seguro un test exacto.
Herramientas relacionadas
¿Ya terminó el test? La calculadora de significancia de tests A/B comprueba si la diferencia entre dos tasas de conversión es estadísticamente significativa, con su puntuación Z y su valor p.
¿Va a hacer una encuesta o un sondeo? La calculadora de tamaño de muestra indica cuántas respuestas necesita para un nivel de confianza y un margen de error dados.