這個計算器能做什麼
它回答每個轉換率實驗都會遇到的三個問題。規劃測試告訴你:要偵測到設定的提升,每個版本需要多少訪客,以目前流量需要幾天。樣本數固定則反過來:針對已有的訪客數,給出偵測你設定效果的檢定力,以及在目標檢定力下能偵測到的最小效果。分析結果依 A、B 的轉換數與訪客數,算出觀察到的提升、兩比例 z 檢定的 p 值與信賴區間,以及 B 優於 A 的貝氏機率,全部精確計算,不使用隨機模擬。
頁面預設帶入範例數據:目前轉換率 5%、相對 MDE 10%、雙尾 α = 5%、檢定力 80%。請換成你自己的數字。
樣本數公式
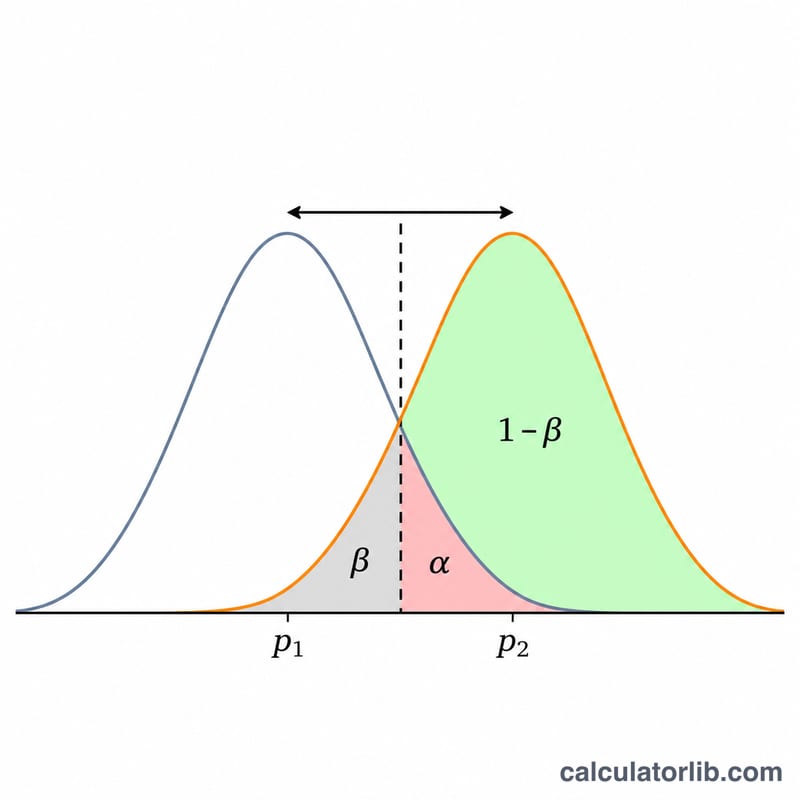
兩組樣本數相同、轉換率分別為 \( p_1 \)(對照組)與 \( p_2 \)(實驗組)時,每組所需訪客數為
$$ n = \frac{\left( z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} + z_{1-\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2-p_1)^2}, \qquad \bar p = \frac{p_1+p_2}{2} $$其中雙尾檢定 \( s = 2 \),單尾檢定 \( s = 1 \),\( z \) 為標準常態分布的分位數。這是 Fleiss、Levin 與 Paik《Statistical Methods for Rates and Proportions》(第 3 版,2003)的公式 4.14:虛無假設下的標準差使用合併比例 \( \bar p \),對立假設下則分別使用兩組比例。它與最後進行的合併 z 檢定採用相同的常態近似,因此規劃與分析一致。結果無條件進位為整數。
表格也列出 Fleiss、Tytun 與 Ury(1980)的連續性校正樣本數 \( n_{cc} = \frac{n}{4}\left(1+\sqrt{1+\frac{4}{n\,|p_2-p_1|} }\right)^2 \)。教科書查表值常是這個較大、較保守的數字。
可以自行核對的例子
Fleiss、Levin 與 Paik,第 74 頁:\( p_1 = 0.60 \),\( p_2 = 0.70 \),雙尾 α = 1%,檢定力 95%。公式結果為 807.07,即每組 808 人;連續性校正後為 827 人,與書中數字相同。檢定力 75% 時為 479.6(480)人,校正後為 499.4 人:書中印為 499,本工具無條件進位為 500。要在本工具重現,請選擇「絕對變化」,目前轉換率填 60,效果填 10。
Ryan(2013),見 NCSS PASS 手冊的驗證範例:單尾 α = 5%,檢定力 80%,55% 對 65% → 295.7,即每組 296 人。
預設範例:目前轉換率 5%、相對提升 10%,就是要區分 5.5% 與 5%。雙尾 α = 5%、檢定力 80% 時,每個版本需要 31,234 名訪客,總計 62,468 名;以每天 2,000 名訪客計需 32 天。
相對 MDE 或絕對 MDE
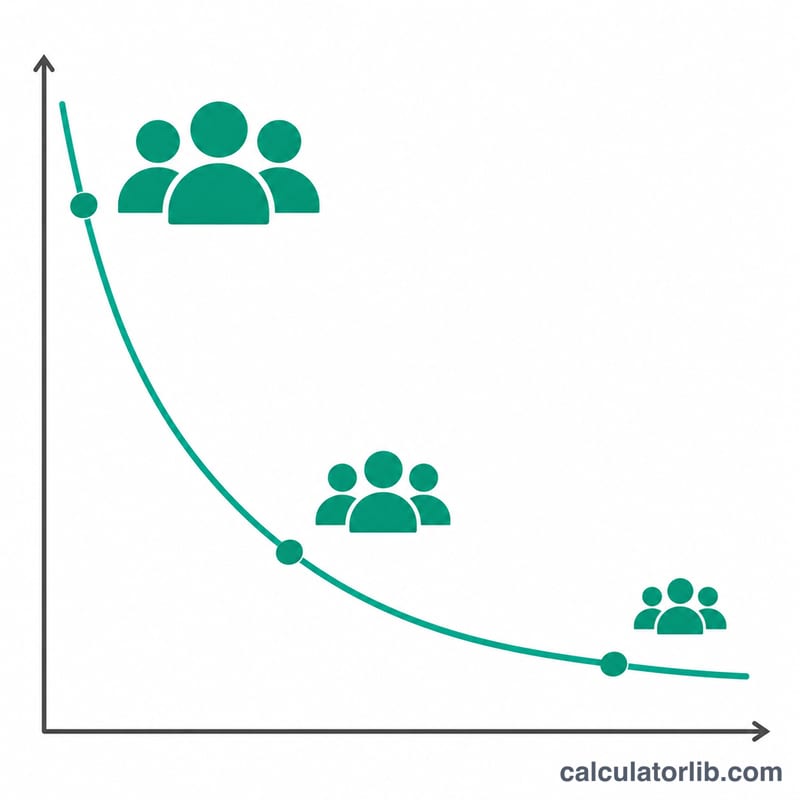
在 5% 的基礎上相對提升 10% 代表 5.5%(\( p_2 = p_1(1+\text{MDE}) \));絕對提升 1 個百分點代表 6%(\( p_2 = p_1 + \text{MDE} \))。由於 \( n \) 與 \( 1/(p_2-p_1)^2 \) 成正比,效果減半時樣本數約變為四倍。基礎轉換率越低,成本越高:同樣的相對提升,1% 轉換率所需訪客約為 5% 轉換率的五倍。
多個版本與 Bonferroni 校正
含對照組共有 \( k \) 個版本時,\( k-1 \) 個實驗組分別與對照組比較,每組分配相同的 \( n \),總量為 \( k \cdot n \)。每多一次比較,就多一次誤判「勝出者」的機會。Bonferroni 校正(Dunn,1961)以 \( \alpha/(k-1) \) 檢定每次比較,使至少出現一次偽陽性的機率不超過 \( \alpha \)。此法較保守,會讓每組的 \( n \) 都變大。
樣本數固定時的檢定力與 MDE
將同一方程式對檢定力求解,可得:
$$ 1-\beta = \Phi\!\left( \frac{|p_2-p_1|\sqrt{n} - z_{1-\alpha/s}\sqrt{2\bar p(1-\bar p)} }{\sqrt{p_1(1-p_1)+p_2(1-p_2)} } \right) $$計算器先就你設定的效果求出檢定力,再搜尋在目標檢定力下可偵測的最小提升。流量已固定時使用此模式,例如不論結果都只跑兩週的活動:若可偵測的提升遠大於任何實際可能的變化,這個測試就難以提供有用的資訊。
解讀結果:p 值與信賴區間
若 A 組 \( n_A \) 名訪客中有 \( x_A \) 次轉換,B 組 \( n_B \) 名中有 \( x_B \) 次,合併 z 統計量為 \( z = (\hat p_B-\hat p_A)/\sqrt{\hat p(1-\hat p)(1/n_A+1/n_B)} \),其中 \( \hat p = (x_A+x_B)/(n_A+n_B) \)。雙尾 p 值為 \( 2(1-\Phi(|z|)) \);檢定「B 較好」的單尾 p 值為 \( 1-\Phi(z) \)。差值的信賴區間使用未合併的標準誤:\( (\hat p_B-\hat p_A) \pm z_{1-\alpha/2}\sqrt{\hat p_A(1-\hat p_A)/n_A+\hat p_B(1-\hat p_B)/n_B} \)。例如:10,000 名中 500 次對 10,000 名中 560 次,得到 z = 1.894、p = 0.0583,因此觀察到的 12% 提升在 5% 水準下不顯著,B − A 的 95% 信賴區間為 −0.02 至 +1.22 個百分點。
B 優於 A 的貝氏機率
採用均勻先驗 Beta(1, 1) 時,\( n \) 名訪客中有 \( x \) 次轉換後,轉換率的後驗分布為 Beta(\( 1+x \), \( 1+n-x \))(Gelman 等,《Bayesian Data Analysis》第 3 版,第 2 章)。由於參數皆為整數,B 的轉換率較高的機率可寫成精確的有限和:
$$ P(p_B>p_A) = \sum_{i=0}^{\alpha_B-1} \frac{B(\alpha_A+i,\ \beta_A+\beta_B)}{(\beta_B+i)\,B(1+i,\ \beta_B)\,B(\alpha_A,\ \beta_A)} $$其中 \( \alpha = 1+x \)、\( \beta = 1+n-x \),\( B \) 為貝塔函數,推導見 Evan Miller。計算器在對數空間中加總,不依賴隨機抽樣,每次結果都相同。選擇 B 的期望損失 \( E[\max(p_A-p_B, 0)] \) 由參數平移後的同一加總求得:代表若 B 其實較差,你預期會損失的轉換率。上例中 P(B > A) = 97.08%,選擇 B 的期望損失為 0.0036 個百分點。「97% 機率較好」與「在 5% 水準下不顯著」回答的是不同的問題,兩者都不代表可以提前停止測試。
為什麼中途偷看會破壞固定期限測試
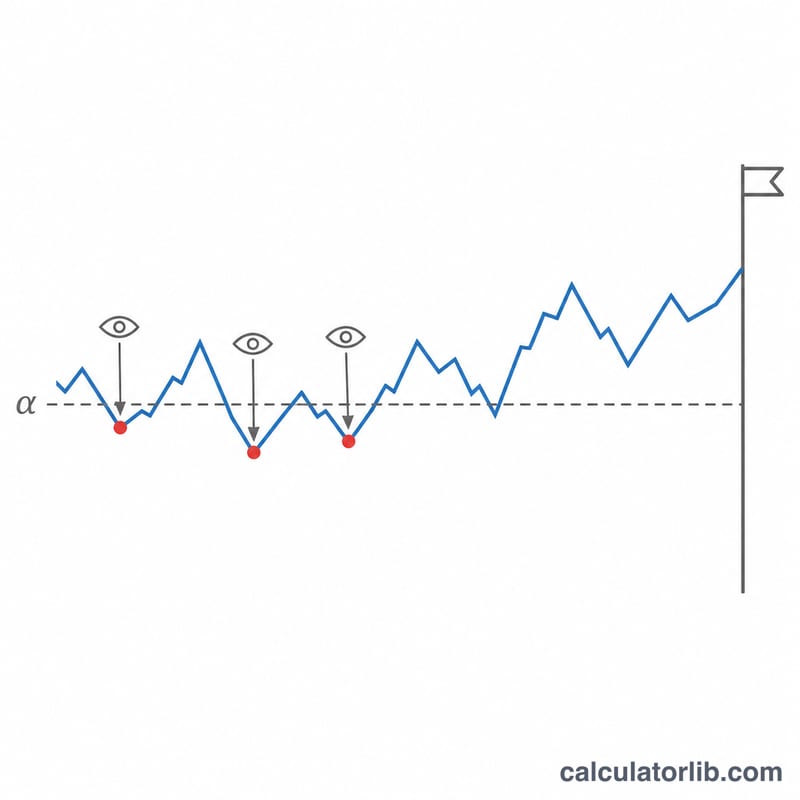
上述樣本數假設你只在結束時看一次資料。若每批資料後都查看,並在第一次出現 p < 0.05 時停止,每次查看都會多一次偽陽性的機會。Armitage、McPherson 與 Rowe(1969)最早量化了這個效應。下表是我們對檢定統計量的聯合常態分布做精確數值積分所得(5% 雙尾檢定、等間隔查看、實際無差異):
| 查看資料的次數 | 誤判勝出者的機率 |
|---|---|
| 1 | 5.0% |
| 2 | 8.3% |
| 3 | 10.7% |
| 5 | 14.2% |
| 10 | 19.3% |
| 20 | 24.8% |
若需要在測試進行中監控,請使用為此設計的方法。O'Brien 與 Fleming(1979)等群組序貫邊界在早期查看時只消耗極少的 α,讓整體偽陽性率維持在 α。Lan 與 DeMets(1983)的 α 消耗函數允許在事先未決定的時間點查看。以混合序貫機率比檢定(mSPRT;Johari、Koomen、Pekelis、Walsh)進行的始終有效推論,任何時刻查看的 p 值都有效。代價是它們都需要比固定期限測試更大的最大樣本數。
假設與限制
這些公式假設訪客彼此獨立、測試期間轉換率穩定、隨機分流公平。請以整週為單位執行以涵蓋星期效應,確認流量分配符合規劃,且每位訪客只計一次。樣本很小或轉換率接近 0% 或 100% 時,常態近似較粗略,此時改用精確檢定較安全。
相關工具
測試已經結束?A/B 測試顯著性計算機會以 Z 值和 p 值檢定兩個轉換率的差異是否具有統計顯著性。
要做問卷調查?樣本數計算器可依信賴水準與誤差範圍算出需要回收多少份問卷。