這個 Erlang C 計算器能回答什麼
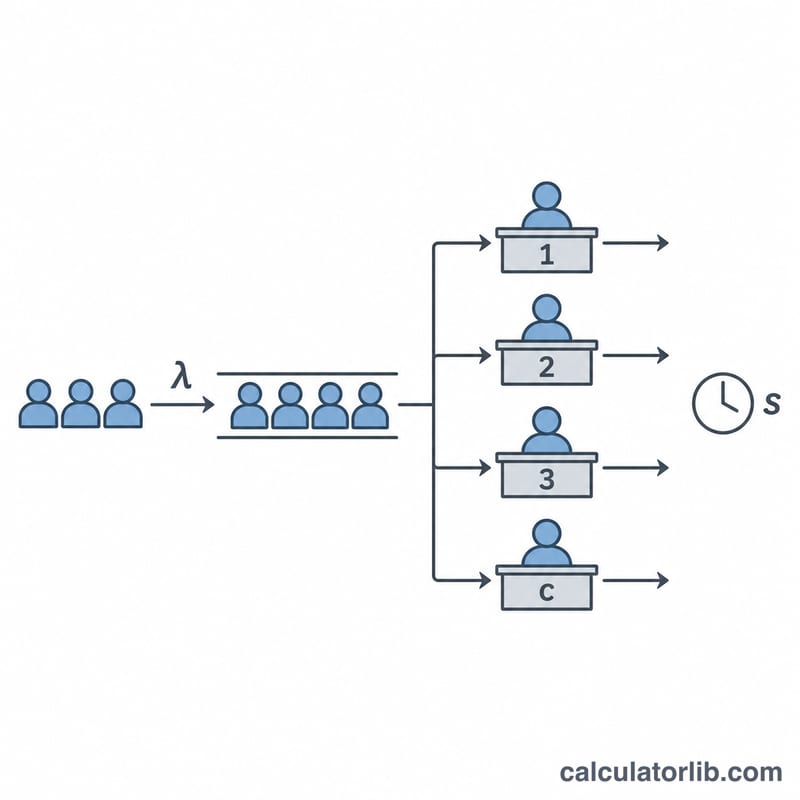
「客服專線要排多少人?」和「上線時要幾台伺服器?」其實是同一個問題:請求隨機到達,每個請求占用一台伺服器一段時間,所有伺服器都忙碌時,後到的就得排隊。本計算器把這種情況建模為 M/M/c 排隊,並使用丹麥工程師 A. K. Erlang 於 1917 年發表的 Erlang C 公式,算出等候機率、平均等候時間、佇列長度,以及在目標時間內獲得服務的比例。
它也會反向求解:找出達成服務水準目標(若有設定,也包括平均等候時間上限)的最少伺服器數,並列出該數附近的比較表,讓你看到增減一台伺服器的差異。
使用方式
- 到達率 λ:每秒、每分鐘或每小時的來電、對話、工單或請求數。請使用最忙時段的數值,而非全天平均。
- 平均服務時間:每次到達的平均處理時間(客服中心為通話加話後處理時間,伺服器為請求處理時間)。也可以改為輸入每台伺服器的服務率 μ。
- 伺服器數 c:平行服務的客服人員、worker、執行緒或機器數量。留空則顯示建議數量下的結果。
- 服務水準目標:等候時間不超過 T 的到達比例。預設的「20 秒內接聽 80%」只是常見範例,不是法規或標準,請填入你自己的目標。
同一工具也適用於 IT 容量規劃:輸入每秒請求數與以毫秒計的服務時間,把「伺服器」理解為並行 worker 即可。
計算公式
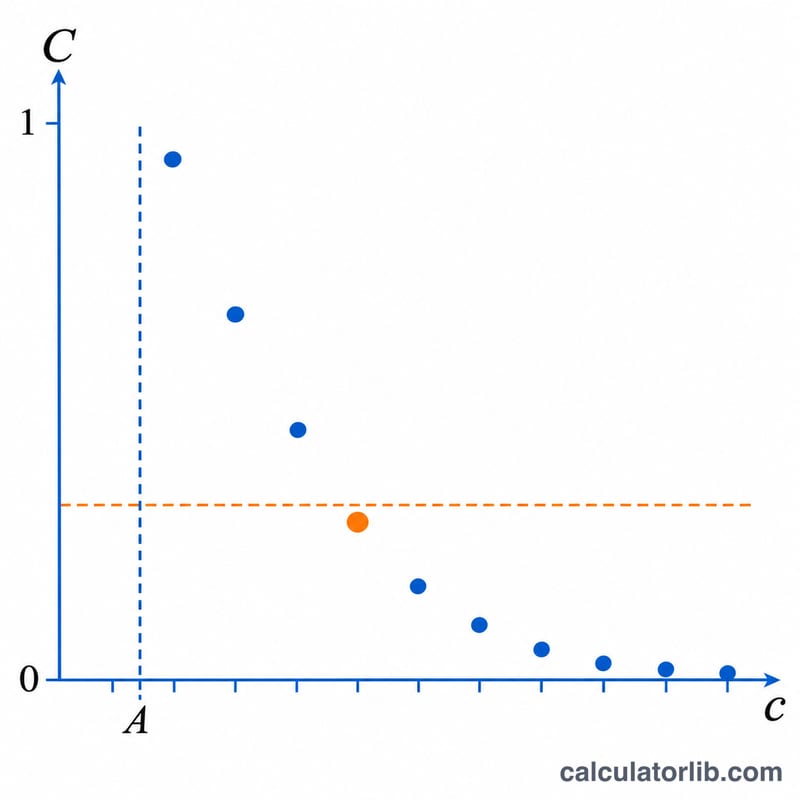
設到達率為 λ、平均服務時間為 s(服務率 μ = 1/s),則話務量 A = λ/μ(單位:爾朗),使用率 ρ = A/c。只有 A < c 時佇列才穩定;否則佇列會無限增長,計算器會直接提示,而不是給出數字。
到達者需要等候的機率就是 Erlang C,記為 C(c, A)。本計算器以 Erlang B 遞迴 Bk = A·Bk−1 / (k + A·Bk−1),再透過 C = c·B / (c − A(1 − B)) 求得。這種算法不涉及階乘,即使有數千台伺服器也能維持精度。由 C 可得:
- 平均排隊等候時間 Wq = C / (cμ − λ),平均停留時間 W = Wq + 1/μ;
- 平均佇列長度 Lq = λWq,系統內平均數量 L = Lq + A;
- 服務水準 P(Wq ≤ T) = 1 − C·e−(cμ−λ)T(先到先服務)。
結果符合利特爾法則 L = λW,並在結果中作為驗算顯示。也可以用產出率計算器(利特爾法則)交叉驗證。
計算範例
某客服中心每小時接到 120 通電話(每分鐘 2 通),平均處理時間 4 分鐘,則 A = 2 × 4 = 8 爾朗。10 名客服人員時,使用率 80%,40.9% 的來電需要等候,平均等候約 49 秒,20 秒內接聽的只有 65.4%。增加到 11 人後,等候機率降到 24.5%,平均等候降到 19.6 秒,服務水準升到 80.9%。因此要達成「20 秒內接聽 80%」需要 11 人;12 人則為 90.0%。
教科書驗算:Iversen 所著 Teletraffic Engineering and Network Planning 例 9.3.1 中,話務量 20 爾朗、平均服務時間 100 秒、32 條線路的系統,平均等候時間為 0.075 秒。本計算器結果為 0.0747 秒。
IT 範例:每秒 5,000 個請求、每個 120 ms,則 A = 600 爾朗。要讓 99% 的請求在 50 ms 內開始處理,需要 610 個並行 worker,此時使用率 98.4%,平均排隊約 7 ms。
假設與限制
- 到達隨機且彼此獨立(卜瓦松過程),服務時間服從指數分配。
- 伺服器效能相同,依先到先服務處理,等候空間不限。
- 假設沒有人中途放棄。實際上來電者會掛斷,此時 Erlang C 會高估等候時間與所需人力;納入放棄行為的 Erlang A 模型(M/M/N+M,Garnett、Mandelbaum 與 Reiman,2002)更合適。
- 結果是實際在線接聽的人數,休息、訓練與缺勤(shrinkage)需另外加上。
- 突發流量、重試與變動很大的服務時間通常會讓排隊比模型更糟。請把結果視為下限,並以真實負載驗證。
若想了解單一工作平行化的加速上限,請使用阿姆達爾定律計算器。