
LLM 自托管与 API 成本计算器

LLM 自托管与 API 成本计算器

新兴 AI Skill PRO

输入计算

GPU 部署

每小时价格仅为示例。请填写云服务报价中的单价,或自有硬件的摊销成本。

模型

默认值为 Llama 3 70B(80 层、维度 8,192、64 个注意力头、8 个键/值头)。请从模型的配置文件或论文中填入你所用模型的参数。

GPU 显存需求计算器

工作负载

效率

两个效率值都是可修改的假设,而非实测。最可靠的输入是用你自己的推理服务、在实际批大小下跑出的基准测试结果。

对比的 API

数学公式

每百万 token 成本=每 GPU 小时价格×Gtoken/秒×3600×u×106\text{每百万 token 成本} = \dfrac{\text{每 GPU 小时价格} \times G}{\text{token/秒} \times 3600 \times u} \times 10^{6}
显示计算步骤 (3)
  1. 单个解码步耗时(Roofline)

    tstep=max⁡(Nb+BS‾kηGBW,B(2N+2nlayerS‾d)mGF)t_{\text{step}} = \max\left(\dfrac{N b + B \bar{S} k}{\eta\, G\, BW},\; \dfrac{B (2N + 2\, n_{\text{layer}} \bar{S} d)}{m\, G\, F}\right)

    一个解码步要以实际带宽 η·G·BW 读取权重(N·b 字节)和所有序列的 KV 缓存(B·S̄·k 字节),并以 m·G·F 完成 B·(2N + 2·n_layer·S̄·d) 次浮点运算。两者中较慢的决定耗时(Williams、Waterman 与 Patterson;Kaplan 等 2020,式 2.2)。

  2. 每 token 的 KV 缓存

    k=2nlayernkvdnheadbkvk = 2\, {{n_{\text{layer}}}}\, {{n_{\text{kv}}}}\, \dfrac{d}{{{n_{\text{head}}}}}\, b_{\text{kv}}

    每一层的键和值:n_kv 个键/值头,每个头大小为 d ÷ n_head,每个值占 b_kv 字节。

  3. 每月盈亏平衡用量

    V∗=pGPU×G×730pAPI/106V^{*} = \dfrac{{{p_{\text{GPU}}}} \times G \times 730}{p_{\text{API}} / 10^{6}}

    全天运行部署的每月固定成本(每 GPU 小时价格 × G × 730 小时)除以按你的提示词/输出比例加权的 API 每 token 价格。只有低于单个部署的处理能力时才能达到。

使用统计

广告

结果

自托管每百万 token 成本
$1.75
输入 + 输出 token,按你的利用率
API 每百万 token 成本
$2.00
Claude Haiku 4.5
按你的每月用量,更便宜的是: API
每月差额: $1,650
盈亏平衡用量(全天运行): 1,825 百万 token/月
每秒输出 token
397
估算值,整个部署
单用户速度(解码)
31.5
每序列 token/秒
每秒全部 token
1,587
提示词 + 输出
自托管每百万输出 token 成本
$7.00
含提示词处理
API 每百万输出 token 成本
$8.00
含对应提示词
单个部署的处理能力
2,085
百万 token/月

按你用量的每月成本

每月用量(百万 token) 1,000
每小时 GPU 成本(全部 GPU) $5.00
所需部署数 1
自托管,全天运行(730 小时) $3,650.00
API $2,000.00

成本曲线

不同每月 token 用量下的每月成本 02,0004,0006,000 01,0002,000
自托管(每个台阶 = 增加一个部署) API 你的用量 盈亏平衡点

横轴:每月百万 token。纵轴:每月美元。

吞吐量估算

GPU NVIDIA H100 SXM5 80GB × 2
解码瓶颈 显存带宽
每个解码步的显存时间(ms)
31.79
每个解码步的计算时间(ms)
2.88
一个批次的预填充时间(ms) 4,275
估算每秒输出 token 397
采用的稠密峰值 TFLOPS(每 GPU) 989.4

显存检查

模型权重(GB) 140.0
每 token KV 缓存(MB) 0.328
KV 缓存,所有序列满长度时(GB) 10.5
所需 / 可用(GB)
150.5 / 160
能否放入 GPU 显存 能
最多可容纳序列数 30

运行时缓冲区、激活值和显存碎片也会占用空间,请预留余量。

采用的 API 价格

每百万输入 token 价格 $1.00
每百万输出 token 价格 $5.00
每个输出 token 对应的提示词 token 3

标价来源: BerriAI (LiteLLM), 2026-11-02

相同提示词/输出比例下的其他 API 模型

模型 每百万 token 每月
Gemini 2.5 Flash-Lite $0.17 $175
Claude Haiku 5.5 $0.20 $200
gpt-6-luna $0.20 $200
DeepSeek Flash (off-peak) $0.26 $263
deepseek-flash $0.53 $525
Mistral Large $0.75 $750
Gemini 3.5 Flash-Lite $0.85 $850
Gemini 2.5 Flash $0.85 $850
DeepSeek V4 Pro (off-peak) $0.99 $990
Gemini 3.8 Flash $1.50 $1,500
deepseek-v4-pro $1.98 $1,980
Claude Haiku 4.5 $2.00 $2,000
gpt-6.1-terra $2.00 $2,000
Gemini 2.5 Pro $3.44 $3,438
Claude Sonnet 5.5 $4.00 $4,000
gpt-6.1-sol $4.00 $4,000
Gemini 4 Argon $4.00 $4,000
Gemini 3.1 Pro Preview $4.50 $4,500
Claude Sonnet 4.6 $6.00 $6,000
Claude Opus 5.5 $8.00 $8,000
Claude Opus 5 $10.00 $10,000
Claude Fable 5.1 $20.00 $20,000
gpt-6-astra $20.00 $20,000

蓝色:按你的用量比自托管便宜。橙色:自托管更便宜。

以上基于规格书峰值(稠密、不含稀疏加速)和你的效率假设估算。实际吞吐量取决于推理引擎、算子和流量,做决定前请填入实测值。

报告本页错误

这个计算器回答什么问题

是租 GPU 自己运行开源权重模型,还是按 token 付费调用 API?答案取决于三个数字:你的 GPU 实际每秒能生成多少 token,你能让它们保持多忙,以及每个月需要多少 token。本计算器根据 GPU 规格书和模型结构估算第一个数字,换算成每百万 token 成本,再与相同提示词/输出比例下的 API 价格对比。

吞吐量如何估算

为批次中的每个序列各生成一个 token(一个解码步),需要把模型全部权重从 GPU 显存读一遍,再读取每个序列的键/值(KV)缓存。对于 \( N \) 个参数的模型,每个 token 还需要约 \( 2N \) 次浮点运算,外加一项随上下文增长的注意力计算(Kaplan 等,2020,式 2.2)。按照 Williams、Waterman 与 Patterson 的 Roofline 模型,一步的耗时取两种限制中较慢的一个:

$$ t_{\text{step}} = \max\left( \frac{N b + B \bar{S} k}{\eta \, G \, BW},\; \frac{B \, (2N + 2 \, n_{\text{layer}} \bar{S} d)}{m \, G \, F} \right) $$

其中 \( b \) 为每个权重的字节数,\( B \) 为并发序列数,\( \bar{S} \) 为解码时的平均上下文长度(提示词加一半输出),\( k \) 为每 token 的 KV 缓存字节数,\( G \) 为 GPU 数量,\( BW \) 为显存带宽,\( F \) 为该精度下的稠密峰值 FLOPS,\( \eta \) 为带宽效率,\( m \) 为算力利用率(MFU)。每 token 的 KV 缓存为 \( k = 2 \, n_{\text{layer}} \, n_{\text{kv}} \, (d / n_{\text{head}}) \, b_{\text{kv}} \)。

提示词会先被并行处理(预填充),因此通常受算力限制。与 Pope 等(2022)一致,一个批次的耗时等于预填充时间加上每个输出 token 一个解码步;每秒输出 token 等于 \( B \) 乘以每次请求的输出 token,再除以批次耗时。

批次较小时,显存项占主导,单用户速度约等于带宽除以模型大小。批次越大,每次读取权重就被更多序列分摊,总吞吐量随之上升,直到 KV 缓存或算力成为瓶颈。
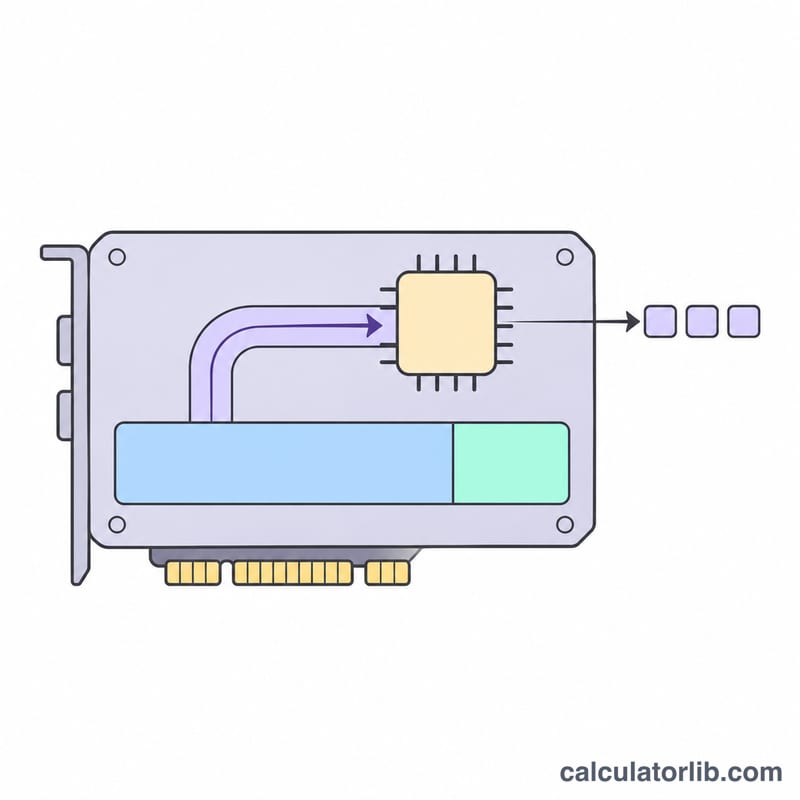
GPU 示意图,显存在模型权重和 KV 缓存之间分配,一条带宽管道向计算芯片供给数据
解码速度主要取决于 GPU 从显存读取模型权重的速度,因此显存带宽决定了吞吐量上限。

从每秒 token 到每百万 token 成本

$$ \text{每百万 token 成本} = \frac{p_{\text{GPU}} \times G}{\text{token/秒} \times 3600 \times u} \times 10^{6} $$

\( p_{\text{GPU}} \) 是每 GPU 小时价格,\( u \) 是平均利用率,即付费时长中 GPU 以模型速度提供服务的比例。只有一半时间在忙的部署,每个 token 的成本要翻倍。API 一侧按每次请求的提示词和输出 token 对输入、输出价格加权,保证两边基于同样的 token 计价。
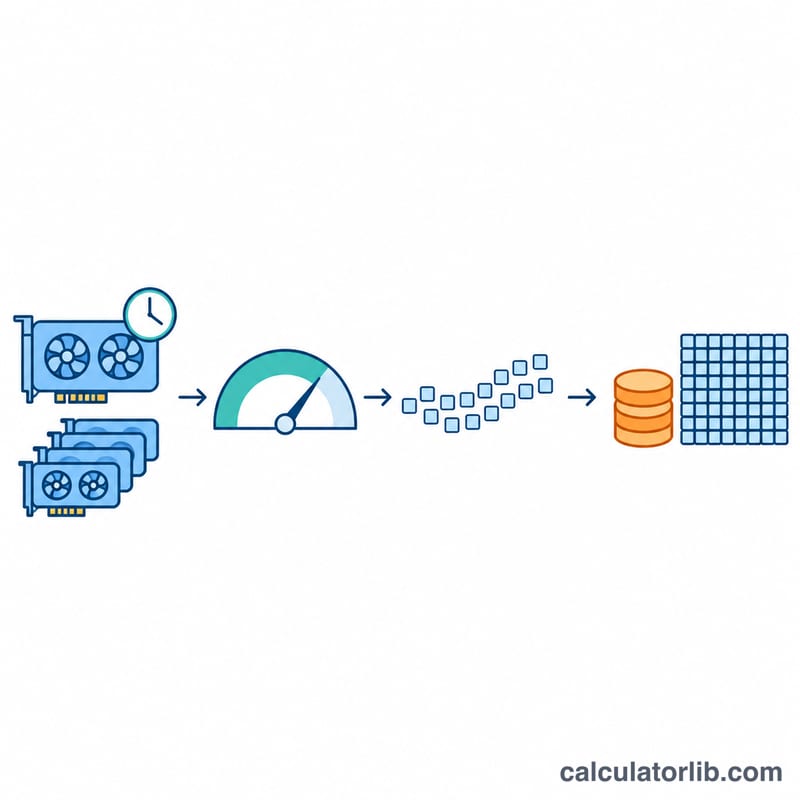
广告
流程图展示 GPU 每小时价格和 GPU 数量,按利用率和吞吐量换算,转化为每百万 token 的成本
自托管每百万 token 成本:GPU 每小时成本除以在你的利用率下每小时实际生成的 token 数。

盈亏平衡用量

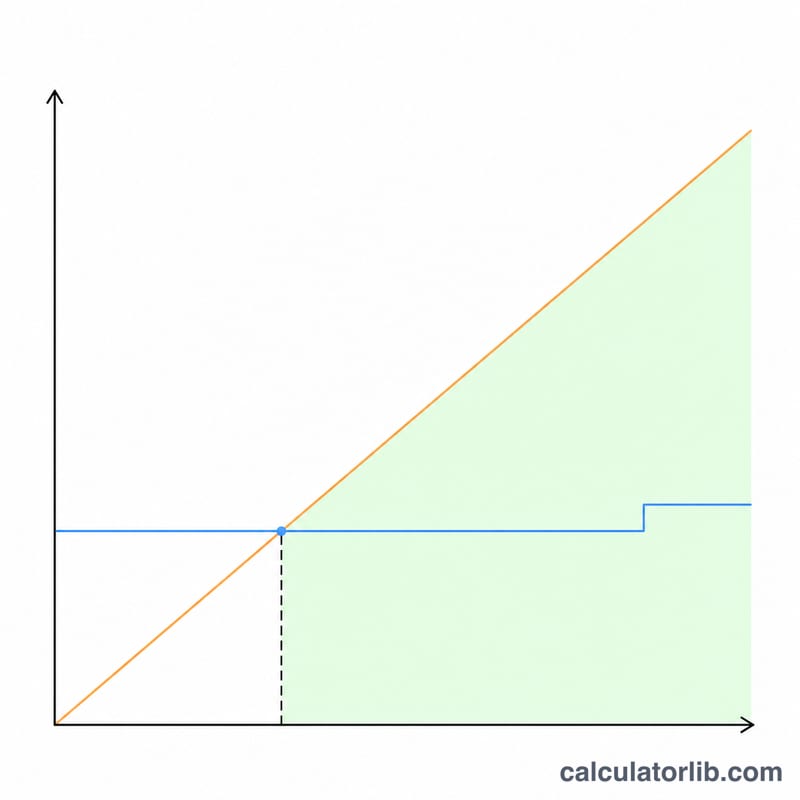
全天运行的部署每月成本固定:每 GPU 小时价格 × GPU 数量 × 730 小时。API 账单则随用量增长。盈亏平衡点是两者相等时的每月用量,即每月固定成本除以 API 每 token 价格。前提是单个部署能承载这一用量;超出处理能力就要再加一个部署,所以图中自托管曲线呈阶梯状上升。

按默认输入(Llama 3 70B,BF16,两张 H100 SXM,示例价格每 GPU 小时 2.50 美元,16 个并发序列,每次请求 1,500 个提示词 token、500 个输出 token),估算约为每秒 397 个输出 token,在 50% 利用率下每百万 token 1.75 美元。与示例 API 价格(每百万 token 输入 1 美元、输出 5 美元)相比,盈亏平衡点约为每月 18.25 亿 token。
广告
折线图中,上升的 API 成本线在盈亏平衡用量处与水平的自托管成本线相交
盈亏平衡点:当每月用量超过交叉点后,固定成本的 GPU 就比按 token 付费的 API 更便宜。

所用 GPU 参数

预设值取自各厂商自己的规格书。Tensor 算力常以结构化稀疏的数值公布,是稠密算力的两倍;常规推理按稠密方式运行,所以表格和计算器都采用稠密数值。

GPU 显存(GB) 带宽(GB/s) 稠密 FP16/BF16 TFLOPS 稠密 FP8 TFLOPS
NVIDIA H100 SXM5 80 3,352 989.4 1,978.9
NVIDIA H100 PCIe 80 2,039 756 1,513
NVIDIA H200 SXM 141 4,800 989.5 1,979
NVIDIA A100 80GB SXM 80 2,039 312 —
NVIDIA A100 80GB PCIe 80 1,935 312 —
NVIDIA L40S 48 864 362.05 733
NVIDIA L4 24 300 121 242.5
AMD Instinct MI300X 192 5,300 1,307.45 2,614.9

如果你的 GPU 不在列表中,请选择“自定义 GPU”,填入它的显存、带宽和稠密 TFLOPS。

估算未涵盖的因素

  • 推理引擎差异很大:连续批处理、分页 KV 缓存、投机解码和优化算子都会显著改变吞吐量。请在自己的系统上实测并填入结果。
  • 把模型拆分到多张 GPU 会增加通信时间,估算中未计入。
  • 混合专家(MoE)模型每个 token 只读取激活的专家:计算速度时填激活参数量,检查显存时用总参数量。
  • 不同模型的分词器不同,同一段文字的 token 数可能不同。
  • 电费、人力、应对高峰的冗余容量和出站流量费用均未包含,除非你把它们计入每小时价格。

如需更细致地估算显存,请使用 GPU 显存需求计算器。

资料来源与参考

最后更新:

行业特定热门计算器

查看全部行业特定计算器















