Calculadora de coste: LLM autoalojado frente a API

Calculadora de coste: LLM autoalojado frente a API

Emergente AI Skill PRO

Ingresar cálculo

Despliegue de GPU

El precio por hora es un ejemplo. Introduce la tarifa de tu presupuesto en la nube o el coste amortizado de tu propio hardware.

Modelo

Valores por defecto: Llama 3 70B (80 capas, dimensión 8192, 64 cabezas, 8 cabezas clave/valor). Copia los valores de tu modelo desde su archivo de configuración o su artículo.

Calculadora de VRAM necesaria en la GPU

Carga de trabajo

Eficiencia

Ambos valores de eficiencia son supuestos editables, no mediciones. El mejor dato es un benchmark de tu propio sistema de servicio con tu tamaño de lote.

API con la que comparar

Fórmula

Coste por 1 M de tokens=Precio por hora de GPU×Gtokens/s×3600×u×106\text{Coste por 1 M de tokens} = \dfrac{\text{Precio por hora de GPU} \times G}{\text{tokens/s} \times 3600 \times u} \times 10^{6}
Ver los pasos del cálculo (3)
  1. Tiempo de un paso de decodificación (roofline)

    tstep=max⁡(Nb+BS‾kηGBW,B(2N+2nlayerS‾d)mGF)t_{\text{step}} = \max\left(\dfrac{N b + B \bar{S} k}{\eta\, G\, BW},\; \dfrac{B (2N + 2\, n_{\text{layer}} \bar{S} d)}{m\, G\, F}\right)

    Cada paso de decodificación lee los pesos (N·b bytes) y la caché KV de todas las secuencias (B·S̄·k bytes) al ancho de banda efectivo η·G·BW, y ejecuta B·(2N + 2·n_layer·S̄·d) FLOP a m·G·F. El límite más lento fija el tiempo del paso (Williams, Waterman y Patterson; Kaplan et al. 2020, ec. 2.2).

  2. Caché KV por token

    k=2nlayernkvdnheadbkvk = 2\, {{n_{\text{layer}}}}\, {{n_{\text{kv}}}}\, \dfrac{d}{{{n_{\text{head}}}}}\, b_{\text{kv}}

    Claves y valores de cada capa: n_kv cabezas clave/valor de tamaño d ÷ n_head, con b_kv bytes por valor.

  3. Volumen mensual de equilibrio

    V∗=pGPU×G×730pAPI/106V^{*} = \dfrac{{{p_{\text{GPU}}}} \times G \times 730}{p_{\text{API}} / 10^{6}}

    Coste fijo mensual de un despliegue siempre encendido (precio por hora de GPU × G × 730 h) dividido entre el precio de la API por token con tu proporción de prompt y salida. Solo es alcanzable si queda por debajo de la capacidad de un despliegue.

Estadísticas de uso

Publicidad

Resultados

Coste autoalojado por 1 M de tokens
$1,75
tokens de entrada + salida, con tu utilización
Coste de la API por 1 M de tokens
$2,00
Claude Haiku 4.5
Más barato con tu volumen mensual: API
Diferencia mensual: $1.650
Volumen de equilibrio (siempre encendido): 1.825 millones de tokens al mes
Tokens de salida por segundo
397
estimación, todo el despliegue
Velocidad por usuario (decodificación)
31,5
tokens/s por secuencia
Tokens totales por segundo
1.587
prompt + salida
Coste autoalojado por 1 M de tokens de salida
$7,00
incluye el procesado del prompt
Coste de la API por 1 M de tokens de salida
$8,00
con los prompts que requieren
Capacidad de un despliegue
2.085
millones de tokens al mes

Coste mensual con tu volumen

Volumen mensual (millones de tokens) 1.000
Coste de GPU por hora (todas las GPU) $5,00
Despliegues necesarios 1
Autoalojado, siempre encendido (730 h) $3.650,00
API $2.000,00

Curva de costes

Coste mensual según el volumen mensual de tokens 02.0004.0006.000 01.0002.000
Autoalojado (cada escalón = un despliegue más) API Tu volumen Punto de equilibrio

Eje horizontal: millones de tokens al mes. Eje vertical: dólares estadounidenses al mes.

Estimación del rendimiento

GPU NVIDIA H100 SXM5 80GB × 2
La decodificación está limitada por ancho de banda de memoria
Tiempo de memoria por paso de decodificación (ms)
31,79
Tiempo de cómputo por paso de decodificación (ms)
2,88
Tiempo de prefill de un lote (ms) 4.275
Tokens de salida por segundo estimados 397
TFLOPS densos máximos usados (por GPU) 989,4

Comprobación de memoria

Pesos del modelo (GB) 140,0
Caché KV por token (MB) 0,328
Caché KV, todas las secuencias a longitud completa (GB) 10,5
Necesaria frente a disponible (GB)
150,5 / 160
Cabe en la memoria de la GPU sí
Máximo de secuencias que caben 30

Los búferes del runtime, las activaciones y la fragmentación también ocupan memoria, así que deja algo de margen.

Precio de API utilizado

Precio de entrada por 1 M de tokens $1,00
Precio de salida por 1 M de tokens $5,00
Tokens de prompt por token de salida 3

Precio de lista según BerriAI (LiteLLM), 2026-11-02

Otros modelos de API con la misma proporción de prompt y salida

Modelo Por 1 M de tokens Al mes
Gemini 2.5 Flash-Lite $0,17 $175
Claude Haiku 5.5 $0,20 $200
gpt-6-luna $0,20 $200
DeepSeek Flash (off-peak) $0,26 $263
deepseek-flash $0,53 $525
Mistral Large $0,75 $750
Gemini 3.5 Flash-Lite $0,85 $850
Gemini 2.5 Flash $0,85 $850
DeepSeek V4 Pro (off-peak) $0,99 $990
Gemini 3.8 Flash $1,50 $1.500
deepseek-v4-pro $1,98 $1.980
Claude Haiku 4.5 $2,00 $2.000
gpt-6.1-terra $2,00 $2.000
Gemini 2.5 Pro $3,44 $3.438
Claude Sonnet 5.5 $4,00 $4.000
gpt-6.1-sol $4,00 $4.000
Gemini 4 Argon $4,00 $4.000
Gemini 3.1 Pro Preview $4,50 $4.500
Claude Sonnet 4.6 $6,00 $6.000
Claude Opus 5.5 $8,00 $8.000
Claude Opus 5 $10,00 $10.000
Claude Fable 5.1 $20,00 $20.000
gpt-6-astra $20,00 $20.000

Azul: más barato que autoalojar con tu volumen. Naranja: autoalojar sale más barato.

Estimaciones a partir de los picos de las fichas técnicas (densos, sin dispersión) y tus supuestos de eficiencia. El rendimiento real depende del motor de servicio, los kernels y el tráfico; introduce un valor medido antes de decidir.

Informar de un error en esta página

Qué responde esta calculadora

¿Conviene alquilar GPU y ejecutar tú mismo un modelo de pesos abiertos, o pagar una API por token? La respuesta depende de tres cifras: cuántos tokens por segundo producen realmente tus GPU, cuánto tiempo las mantienes ocupadas y cuántos tokens necesitas al mes. La calculadora estima la primera a partir de la ficha técnica de la GPU y la forma del modelo, la convierte en un coste por millón de tokens y la compara con el precio de una API para la misma mezcla de tokens de prompt y de salida.

Cómo se estima el rendimiento

Generar un token para cada secuencia del lote (un paso de decodificación) obliga a leer una vez todos los pesos del modelo desde la memoria de la GPU, más la caché clave/valor (KV) de cada secuencia. Además cuesta unas \( 2N \) operaciones de coma flotante por token para un modelo de \( N \) parámetros, más un término de atención que crece con el contexto (Kaplan et al., 2020, ec. 2.2). Según el modelo roofline de Williams, Waterman y Patterson, un paso dura lo que el más lento de los dos límites:

$$ t_{\text{step}} = \max\left( \frac{N b + B \bar{S} k}{\eta \, G \, BW},\; \frac{B \, (2N + 2 \, n_{\text{layer}} \bar{S} d)}{m \, G \, F} \right) $$

\( b \) son los bytes por peso, \( B \) el número de secuencias simultáneas, \( \bar{S} \) el contexto medio durante la decodificación (prompt más la mitad de la salida), \( k \) los bytes de caché KV por token, \( G \) el número de GPU, \( BW \) el ancho de banda de memoria, \( F \) los FLOPS densos máximos para la precisión, \( \eta \) la eficiencia del ancho de banda y \( m \) la utilización de cómputo (MFU). La caché KV por token es \( k = 2 \, n_{\text{layer}} \, n_{\text{kv}} \, (d / n_{\text{head}}) \, b_{\text{kv}} \).

El prompt se procesa primero y en paralelo (prefill), por lo que suele estar limitado por el cómputo. Como en Pope et al. (2022), un lote tarda el tiempo de prefill más un paso de decodificación por cada token de salida, y los tokens de salida por segundo equivalen a \( B \) por los tokens de salida de cada solicitud, divididos entre ese tiempo.

Con lotes pequeños domina el término de memoria y la velocidad por usuario se acerca al ancho de banda dividido entre el tamaño del modelo. Los lotes grandes reparten cada lectura de los pesos entre más secuencias, así que el rendimiento total sube hasta que la caché KV o el cómputo se convierten en el límite.
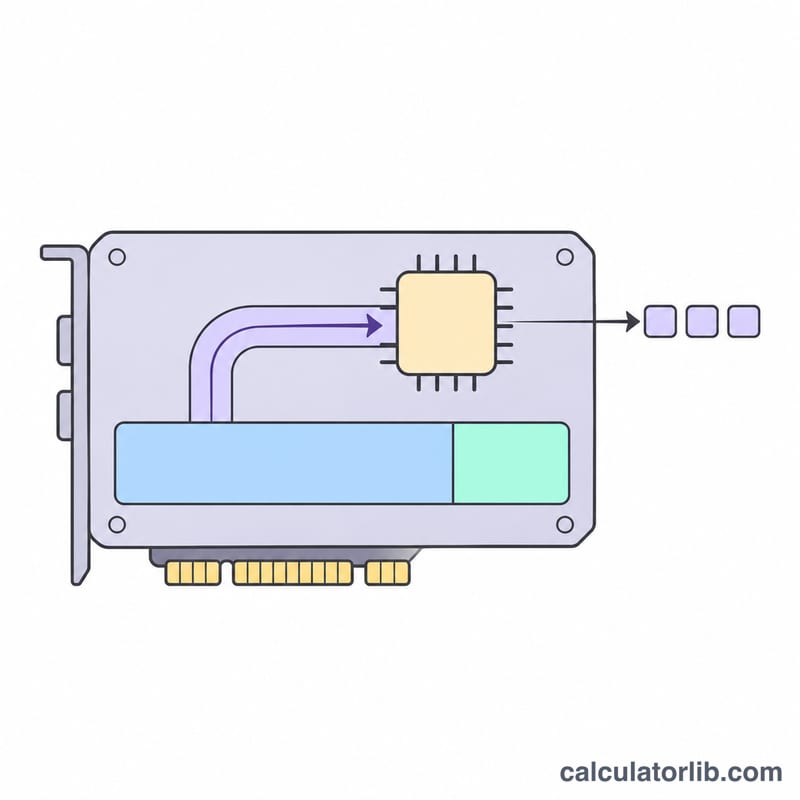
Ilustración de una GPU con la memoria dividida entre los pesos del modelo y la caché KV, y una tubería de ancho de banda que alimenta el chip de cómputo
La velocidad de decodificación depende sobre todo de qué tan rápido la GPU puede leer los pesos del modelo desde la memoria, así que el ancho de banda de memoria marca el techo de rendimiento.

De tokens por segundo a coste por millón de tokens

$$ \text{Coste por 1 M de tokens} = \frac{p_{\text{GPU}} \times G}{\text{tokens/s} \times 3600 \times u} \times 10^{6} $$

\( p_{\text{GPU}} \) es el precio por hora de GPU y \( u \) la utilización media: la parte de las horas pagadas en la que las GPU sirven al ritmo modelado. Un despliegue ocupado la mitad del tiempo paga el doble por token. En la API, los precios de entrada y salida se ponderan con tus tokens de prompt y de salida por solicitud, de modo que ambos lados se calculan sobre los mismos tokens.
Publicidad
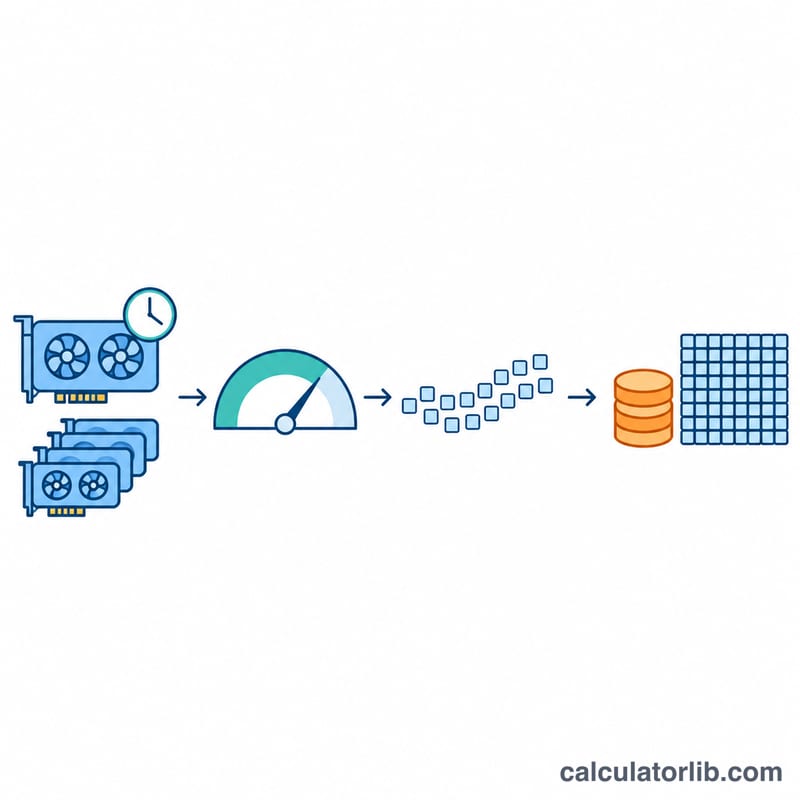
Diagrama de flujo que muestra el precio por hora de GPU y el número de GPU, ajustados por utilización y rendimiento, convertidos en costo por millón de tokens
Costo autoalojado por 1 millón de tokens: el costo por hora de GPU dividido entre los tokens que realmente produces cada hora según tu utilización.

Volumen de equilibrio

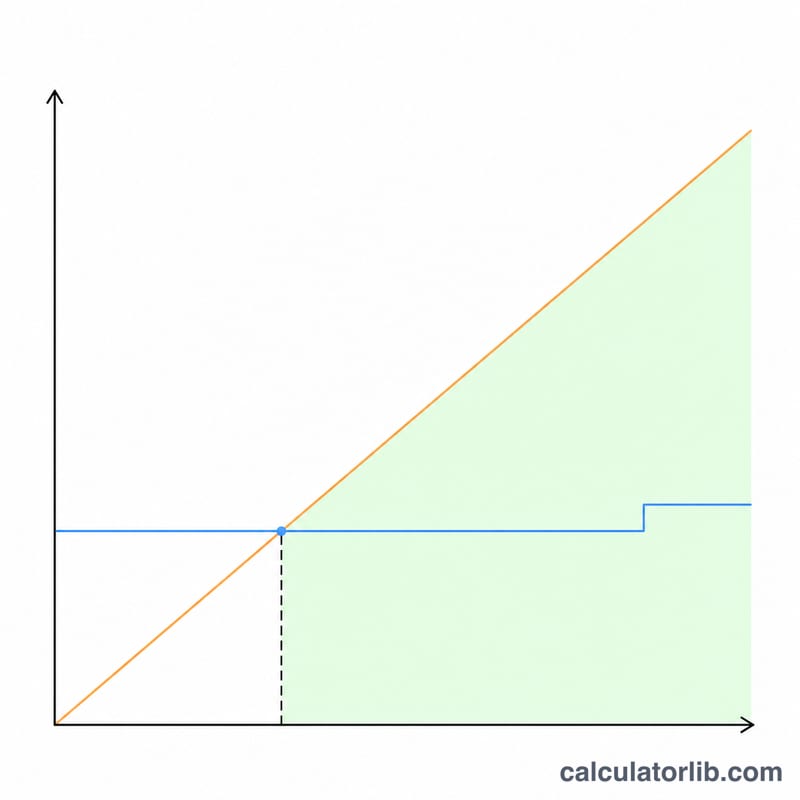
Un despliegue siempre encendido cuesta lo mismo cada mes: precio por hora de GPU × número de GPU × 730 horas. La factura de la API crece con el volumen. El punto de equilibrio es el volumen mensual en el que ambos coinciden: el coste fijo mensual dividido entre el precio de la API por token. Solo cuenta si un despliegue puede servir ese volumen; más allá de su capacidad hace falta otro despliegue, y por eso la línea autoalojada del gráfico sube por escalones.

Con los valores por defecto (Llama 3 70B en BF16 en dos GPU H100 SXM a un precio de ejemplo de 2,50 USD por hora de GPU, 16 secuencias simultáneas, 1500 tokens de prompt y 500 de salida por solicitud), la estimación es de unos 397 tokens de salida por segundo y 1,75 USD por millón de tokens con un 50 % de utilización. Frente a un precio de API de ejemplo de 1 USD de entrada y 5 USD de salida por millón de tokens, el equilibrio está en unos 1825 millones de tokens al mes.
Publicidad
Gráfico de líneas donde una línea creciente de costo de API cruza una línea plana de costo autoalojado en el volumen de equilibrio
Punto de equilibrio: cuando el volumen mensual supera el punto de cruce, una GPU de costo fijo sale más barata que pagar la API por token.

Datos de GPU utilizados

Los preajustes proceden de la ficha técnica de cada fabricante. El rendimiento de los tensor cores suele anunciarse con dispersión estructurada, que duplica la cifra densa; la inferencia habitual es densa, así que la tabla y la calculadora usan los valores densos.

GPU Memoria (GB) Ancho de banda (GB/s) TFLOPS FP16/BF16 densos TFLOPS FP8 densos
NVIDIA H100 SXM5 80 3,352 989.4 1,978.9
NVIDIA H100 PCIe 80 2,039 756 1,513
NVIDIA H200 SXM 141 4,800 989.5 1,979
NVIDIA A100 80GB SXM 80 2,039 312 —
NVIDIA A100 80GB PCIe 80 1,935 312 —
NVIDIA L40S 48 864 362.05 733
NVIDIA L4 24 300 121 242.5
AMD Instinct MI300X 192 5,300 1,307.45 2,614.9

Si tu GPU no aparece, elige «GPU personalizada» e introduce su memoria, su ancho de banda y sus TFLOPS densos.

Qué deja fuera la estimación

  • Los motores de servicio difieren: el batching continuo, la caché KV paginada, la decodificación especulativa y los kernels optimizados pueden cambiar mucho el rendimiento. Mide tu propio sistema e introduce el resultado.
  • Repartir un modelo entre varias GPU añade un tiempo de comunicación que la estimación ignora.
  • Un modelo mixture-of-experts solo lee los expertos activos en cada token: introduce los parámetros activos para la velocidad, pero comprueba la memoria con el total.
  • Cada modelo usa su propio tokenizador, así que el mismo texto puede dar un número distinto de tokens.
  • La electricidad, el personal, la capacidad de reserva para picos y el tráfico de salida no se incluyen salvo que los sumes al precio por hora.

Para dimensionar la memoria de la GPU con más detalle, usa la calculadora de VRAM necesaria en la GPU.


Fuentes y referencias

Última actualización:

Lo más popular en Específico de la Industria

Ver todas las calculadoras de Específico de la Industria