
LLM 自架與 API 成本計算器

LLM 自架與 API 成本計算器

新興 AI Skill PRO

輸入計算

GPU 部署

每小時價格僅為範例。請填入雲端報價的單價,或自有硬體的攤提成本。

模型

預設值為 Llama 3 70B(80 層、維度 8,192、64 個注意力頭、8 個鍵/值頭)。請從模型的設定檔或論文填入你所用模型的參數。

GPU VRAM 需求計算器

工作負載

效率

兩個效率值都是可調整的假設,並非實測。最可靠的輸入是在實際批次大小下,對你自己的推論服務做基準測試所得的結果。

比較的 API

數學公式

每百萬 token 成本=每 GPU 小時價格×Gtoken/秒×3600×u×106\text{每百萬 token 成本} = \dfrac{\text{每 GPU 小時價格} \times G}{\text{token/秒} \times 3600 \times u} \times 10^{6}
顯示計算步驟 (3)
  1. 單一解碼步驟耗時(Roofline)

    tstep=max⁡(Nb+BS‾kηGBW,B(2N+2nlayerS‾d)mGF)t_{\text{step}} = \max\left(\dfrac{N b + B \bar{S} k}{\eta\, G\, BW},\; \dfrac{B (2N + 2\, n_{\text{layer}} \bar{S} d)}{m\, G\, F}\right)

    一個解碼步驟要以實際頻寬 η·G·BW 讀取權重(N·b 位元組)與所有序列的 KV 快取(B·S̄·k 位元組),並以 m·G·F 完成 B·(2N + 2·n_layer·S̄·d) 次浮點運算。兩者較慢者決定耗時(Williams、Waterman 與 Patterson;Kaplan 等 2020,式 2.2)。

  2. 每 token 的 KV 快取

    k=2nlayernkvdnheadbkvk = 2\, {{n_{\text{layer}}}}\, {{n_{\text{kv}}}}\, \dfrac{d}{{{n_{\text{head}}}}}\, b_{\text{kv}}

    每一層的鍵與值:n_kv 個鍵/值頭,每個頭大小為 d ÷ n_head,每個值占 b_kv 位元組。

  3. 每月損益兩平用量

    V∗=pGPU×G×730pAPI/106V^{*} = \dfrac{{{p_{\text{GPU}}}} \times G \times 730}{p_{\text{API}} / 10^{6}}

    全天運作部署的每月固定成本(每 GPU 小時價格 × G × 730 小時)除以依你的提示詞/輸出比例加權的 API 每 token 價格。只有低於單一部署的處理量時才能達到。

使用統計

廣告

結果

自架每百萬 token 成本
$1.75
輸入 + 輸出 token,依你的使用率
API 每百萬 token 成本
$2.00
Claude Haiku 4.5
依你的每月用量,較便宜的是: API
每月差額: $1,650
損益兩平用量(全天運作): 1,825 百萬 token/月
每秒輸出 token
397
估算值,整個部署
單一使用者速度(解碼)
31.5
每序列 token/秒
每秒全部 token
1,587
提示詞 + 輸出
自架每百萬輸出 token 成本
$7.00
含提示詞處理
API 每百萬輸出 token 成本
$8.00
含對應提示詞
單一部署的處理量
2,085
百萬 token/月

依你用量的每月成本

每月用量(百萬 token) 1,000
每小時 GPU 成本(全部 GPU) $5.00
所需部署數 1
自架,全天運作(730 小時) $3,650.00
API $2,000.00

成本曲線

不同每月 token 用量下的每月成本 02,0004,0006,000 01,0002,000
自架(每一階 = 增加一個部署) API 你的用量 損益兩平點

橫軸:每月百萬 token。縱軸:每月美元。

吞吐量估算

GPU NVIDIA H100 SXM5 80GB × 2
解碼瓶頸 記憶體頻寬
每個解碼步驟的記憶體時間(ms)
31.79
每個解碼步驟的運算時間(ms)
2.88
一個批次的預填時間(ms) 4,275
估算每秒輸出 token 397
採用的密集峰值 TFLOPS(每 GPU) 989.4

記憶體檢查

模型權重(GB) 140.0
每 token KV 快取(MB) 0.328
KV 快取,所有序列滿長度時(GB) 10.5
所需/可用(GB)
150.5 / 160
是否放得進 GPU 記憶體 是
最多可容納序列數 30

執行階段緩衝區、激活值與記憶體碎片也會占用空間,請保留餘裕。

採用的 API 價格

每百萬輸入 token 價格 $1.00
每百萬輸出 token 價格 $5.00
每個輸出 token 對應的提示詞 token 3

定價來源: BerriAI (LiteLLM), 2026-11-02

相同提示詞/輸出比例下的其他 API 模型

模型 每百萬 token 每月
Gemini 2.5 Flash-Lite $0.17 $175
Claude Haiku 5.5 $0.20 $200
gpt-6-luna $0.20 $200
DeepSeek Flash (off-peak) $0.26 $263
deepseek-flash $0.53 $525
Mistral Large $0.75 $750
Gemini 3.5 Flash-Lite $0.85 $850
Gemini 2.5 Flash $0.85 $850
DeepSeek V4 Pro (off-peak) $0.99 $990
Gemini 3.8 Flash $1.50 $1,500
deepseek-v4-pro $1.98 $1,980
Claude Haiku 4.5 $2.00 $2,000
gpt-6.1-terra $2.00 $2,000
Gemini 2.5 Pro $3.44 $3,438
Claude Sonnet 5.5 $4.00 $4,000
gpt-6.1-sol $4.00 $4,000
Gemini 4 Argon $4.00 $4,000
Gemini 3.1 Pro Preview $4.50 $4,500
Claude Sonnet 4.6 $6.00 $6,000
Claude Opus 5.5 $8.00 $8,000
Claude Opus 5 $10.00 $10,000
Claude Fable 5.1 $20.00 $20,000
gpt-6-astra $20.00 $20,000

藍色:依你的用量比自架便宜。橘色:自架較便宜。

以上依規格表峰值(密集、不含稀疏加速)與你的效率假設估算。實際吞吐量取決於推論引擎、核心程式與流量,做決定前請填入實測值。

回報本頁錯誤

這個計算器回答什麼問題

該租 GPU 自己執行開放權重模型,還是依 token 付費使用 API?答案取決於三個數字:你的 GPU 實際每秒能產生多少 token、你能讓它們維持多忙,以及每個月需要多少 token。本計算器依 GPU 規格表與模型架構估算第一個數字,換算成每百萬 token 成本,再與相同提示詞/輸出比例下的 API 價格比較。

吞吐量如何估算

為批次中每個序列各產生一個 token(一個解碼步驟),需要把模型全部權重從 GPU 記憶體讀取一次,並讀取每個序列的鍵/值(KV)快取。對 \( N \) 個參數的模型,每個 token 還需約 \( 2N \) 次浮點運算,外加一項隨上下文增長的注意力運算(Kaplan 等,2020,式 2.2)。依照 Williams、Waterman 與 Patterson 的 Roofline 模型,一個步驟的耗時取兩種限制中較慢者:

$$ t_{\text{step}} = \max\left( \frac{N b + B \bar{S} k}{\eta \, G \, BW},\; \frac{B \, (2N + 2 \, n_{\text{layer}} \bar{S} d)}{m \, G \, F} \right) $$

其中 \( b \) 為每個權重的位元組數,\( B \) 為同時處理的序列數,\( \bar{S} \) 為解碼時的平均上下文長度(提示詞加一半輸出),\( k \) 為每 token 的 KV 快取位元組數,\( G \) 為 GPU 數量,\( BW \) 為記憶體頻寬,\( F \) 為該精度的密集峰值 FLOPS,\( \eta \) 為頻寬效率,\( m \) 為運算使用率(MFU)。每 token 的 KV 快取為 \( k = 2 \, n_{\text{layer}} \, n_{\text{kv}} \, (d / n_{\text{head}}) \, b_{\text{kv}} \)。

提示詞會先以平行方式處理(預填),因此通常受運算能力限制。與 Pope 等(2022)相同,一個批次的耗時為預填時間加上每個輸出 token 一個解碼步驟;每秒輸出 token 等於 \( B \) 乘以每次請求的輸出 token,再除以批次耗時。

批次較小時,記憶體項占主導,單一使用者速度約為頻寬除以模型大小。批次越大,每次讀取權重就由越多序列分攤,總吞吐量隨之提升,直到 KV 快取或運算能力成為瓶頸。
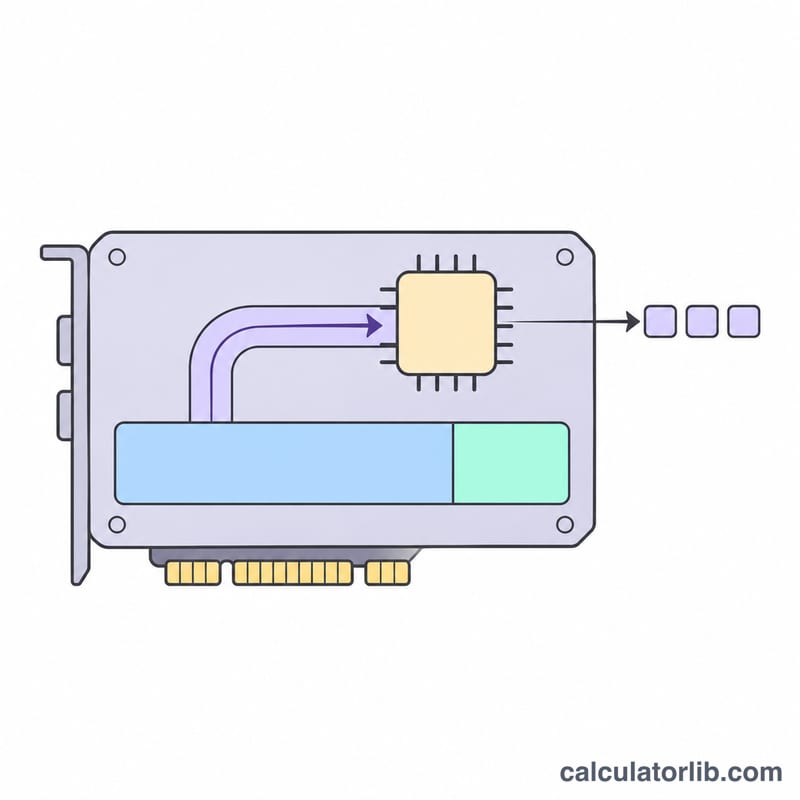
GPU 示意圖,記憶體在模型權重與 KV 快取之間分配,一條頻寬管道向運算晶片供給資料
解碼速度主要取決於 GPU 從記憶體讀取模型權重的速度,因此記憶體頻寬決定了吞吐量上限。

從每秒 token 到每百萬 token 成本

$$ \text{每百萬 token 成本} = \frac{p_{\text{GPU}} \times G}{\text{token/秒} \times 3600 \times u} \times 10^{6} $$

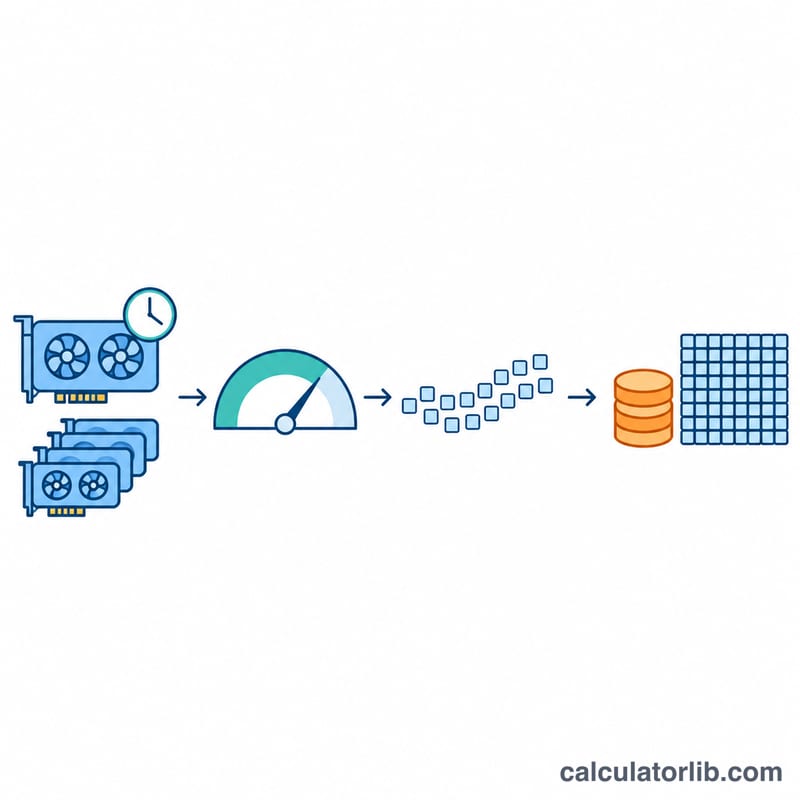
\( p_{\text{GPU}} \) 為每 GPU 小時價格,\( u \) 為平均使用率,也就是付費時數中 GPU 以模型速度提供服務的比例。只有一半時間在忙的部署,每個 token 的成本會加倍。API 一側依每次請求的提示詞與輸出 token 對輸入、輸出價格加權,讓兩邊以相同的 token 計價。
廣告
流程圖呈現 GPU 每小時價格與 GPU 數量,依使用率和吞吐量換算,轉化為每百萬 token 的成本
自架每百萬 token 成本:GPU 每小時成本除以在你的使用率下每小時實際產生的 token 數。

損益兩平用量

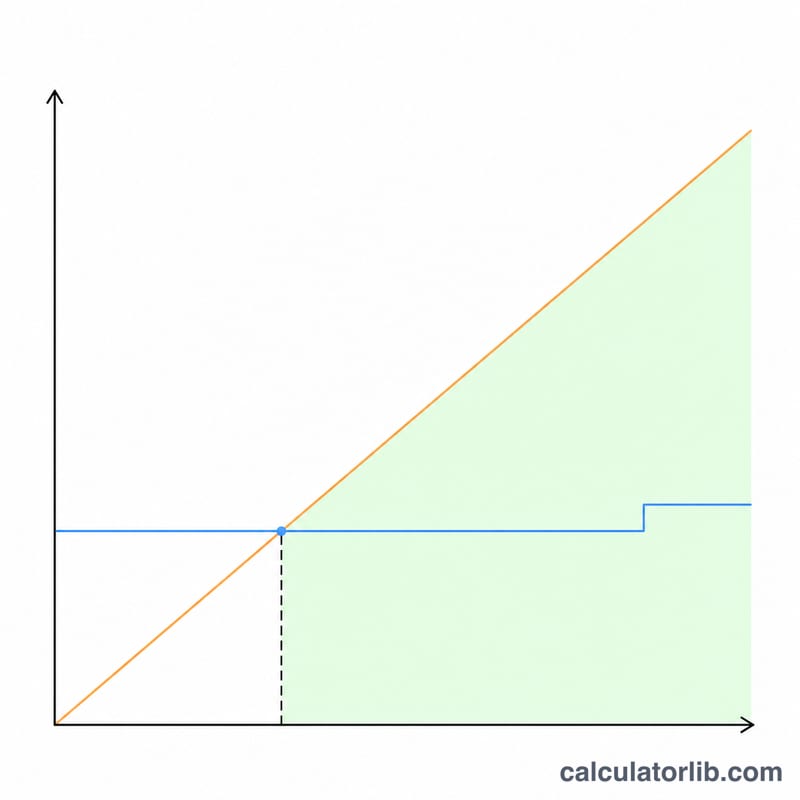
全天運作的部署每月成本固定:每 GPU 小時價格 × GPU 數量 × 730 小時。API 帳單則隨用量增加。損益兩平點是兩者相等時的每月用量,也就是每月固定成本除以 API 每 token 價格。前提是單一部署承接得了這個用量;超過處理量就得再加一個部署,因此圖中自架曲線呈階梯狀上升。

以預設輸入(Llama 3 70B,BF16,兩張 H100 SXM,範例價格每 GPU 小時 2.50 美元,16 個同時序列,每次請求 1,500 個提示詞 token、500 個輸出 token)計算,估算約為每秒 397 個輸出 token,50% 使用率下每百萬 token 1.75 美元。與範例 API 價格(每百萬 token 輸入 1 美元、輸出 5 美元)相比,損益兩平點約為每月 18.25 億 token。
廣告
折線圖中,上升的 API 成本線在損益平衡用量處與水平的自架成本線相交
損益平衡點:當每月用量超過交叉點後,固定成本的 GPU 就比按 token 付費的 API 更便宜。

使用的 GPU 規格

預設值取自各廠商自己的規格表。Tensor 運算效能常以結構化稀疏的數值公布,是密集效能的兩倍;一般推論以密集方式執行,因此表格與計算器都採用密集數值。

GPU 記憶體(GB) 頻寬(GB/s) 密集 FP16/BF16 TFLOPS 密集 FP8 TFLOPS
NVIDIA H100 SXM5 80 3,352 989.4 1,978.9
NVIDIA H100 PCIe 80 2,039 756 1,513
NVIDIA H200 SXM 141 4,800 989.5 1,979
NVIDIA A100 80GB SXM 80 2,039 312 —
NVIDIA A100 80GB PCIe 80 1,935 312 —
NVIDIA L40S 48 864 362.05 733
NVIDIA L4 24 300 121 242.5
AMD Instinct MI300X 192 5,300 1,307.45 2,614.9

若你的 GPU 不在清單中,請選擇「自訂 GPU」,填入其記憶體、頻寬與密集 TFLOPS。

估算未涵蓋的部分

  • 推論引擎差異很大:連續批次處理、分頁 KV 快取、推測解碼與最佳化核心程式都會大幅改變吞吐量。請在自己的系統上實測並填入結果。
  • 把模型分散到多張 GPU 會增加通訊時間,估算並未納入。
  • 混合專家(MoE)模型每個 token 只讀取啟用中的專家:計算速度時填入啟用參數量,檢查記憶體時則用總參數量。
  • 不同模型的分詞器不同,同一段文字的 token 數可能不同。
  • 電費、人力、因應尖峰的備援容量與對外傳輸費用都未計入,除非你把它們加進每小時價格。

如需更細緻地估算 GPU 記憶體,請使用 GPU VRAM 需求計算器。

資料來源與參考

最後更新:

行業特定熱門計算器

查看全部行業特定計算器















